


Python构建代理IP池:免费IP抓取与Crawler类实现

本文介绍如何使用Python构建代理IP池的第一步:获取IP。通过结合Requests和PyQuery库,利用自定义的ProxyMetaclass元类自动识别以crawl开头的方法,实现从多个免费代理网站批量抓取IP和端口。代码采用生成器模式返回数据,便于后续存储与检测,为反爬策略提供灵活的IP轮换方案。
代理IP池构建背景与必要性
在进行网页爬虫开发时,绝大多数目标网站都部署了反爬机制,常见手段包括限制单一IP的访问频率或总次数。一旦超出阈值,该IP将被封禁。针对访问频率限制,通常只需在请求间设置合理的时间间隔即可规避;但针对访问次数限制,单纯延时无法解决,此时引入代理IP池成为必要手段,通过轮换使用多个代理IP访问目标地址,可有效绕过此类限制。
当前网络上有大量提供代理服务的平台,部分提供免费代理,但稳定性和可用性往往较差。若业务对代理质量要求较高,建议购买付费代理服务,其可用性和响应速度通常更有保障。
为降低成本并提高可控性,可自行构建代理池。具体流程是从各类代理服务网站抓取代理IP,利用稳定网址(最好是目标爬取网站本身)检测其可用性,并将有效IP存入数据库,供后续调用。
完整代码仓库地址:https://github.com/Stevengz/Proxy_pool
本系列其他文章链接: Python搭建代理IP池(二)- 存储 IP Python搭建代理IP池(三)- 检测 IP Python搭建代理IP池(四)- 接口设置与整体调度
本文重点讲解构建代理IP池的基础环节:IP获取。
主要依赖的Python库包括:requests用于网络请求,pyquery用于HTML解析。
免费代理源与数据抓取实现
以下列举部分提供免费代理的服务平台(排名不分先后):
| 厂商名称 | 地址 |
|---|---|
| 66代理 | http://www.66ip.cn/ |
| 西刺代理 | https://www.xicidaili.com |
| 全网代理 | http://www.goubanjia.com |
| 云代理 | http://www.ip3366.net |
| IP海 | http://www.iphai.com |
| 快代理 | https://www.kuaidaili.com |
| 免费代理IP库 | http://ip.jiangxianli.com |
代理服务网站列表
代理获取的核心代码逻辑:将各网站的IP提取方法整合,运行时只需调用相应方法即可获取数据。
为保证代码扩展性,统一规定获取代理的方法以“crawl”为前缀。未来新增代理源时,只需添加以crawl开头的新方法即可,无需修改核心逻辑。
本文实现了几个示例方法,分别抓取66代理、西刺代理、云代理和快代理这四个免费网站的IP。所有方法均定义为生成器,通过yield语句返回解析后的“IP:端口”格式数据。流程为先获取网页源码,再使用PyQuery解析提取。
crawler.py模块说明
Crawler类与元类设计
import json
import re
from utils import get_page
from pyquery import PyQuery as pq

# 元类
class ProxyMetaclass(type):
 def __new__(cls, name, bases, attrs):
  count = 0
  attrs['__CrawlFunc__'] = []
  for k, v in attrs.items():
   if 'crawl_' in k:
    attrs['__CrawlFunc__'].append(k)
    count += 1
  attrs['__CrawlFuncCount__'] = count
  return type.__new__(cls, name, bases, attrs)

class Crawler(object, metaclass=ProxyMetaclass):
 def get_proxies(self, callback):
  proxies = []
  for proxy in eval("self.{}()".format(callback)):
   print('成功获取到代理', proxy)
   proxies.append(proxy)
  return proxies

 def crawl_daili66(self, page_count=4):
  start_url = 'http://www.66ip.cn/{}.html'
  urls = [start_url.format(page) for page in range(1, page_count + 1)]
  for url in urls:
   print('Crawling', url)
   html = get_page(url)
   if html:
    doc = pq(html)
    trs = doc('.containerbox table tr:gt(0)').items()
    for tr in trs:
     ip = tr.find('td:nth-child(1)').text()
     port = tr.find('td:nth-child(2)').text()
     yield ':'.join([ip, port])

 def crawl_xicidaili(self):
  for i in range(1, 3):
   start_url = 'http://www.xicidaili.com/nn/{}'.format(i)
   headers = {
    'Accept':'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
    'Host':'www.xicidaili.com',
    'Referer':'http://www.xicidaili.com/nn/3',
    'Upgrade-Insecure-Requests':'1',
   }
   html = get_page(start_url, options=headers)
   if html:
    find_trs = re.compile('<tr class.*?>(.*?)</tr>', re.S)
    trs = find_trs.findall(html)
    for tr in trs:
     find_ip = re.compile('<td>(\d+\.\d+\.\d+\.\d+)</td>')
     re_ip_address = find_ip.findall(tr)
     find_port = re.compile('<td>(\d+)</td>')
     re_port = find_port.findall(tr)
     for address,port in zip(re_ip_address, re_port):
      address_port = address+':'+port
      yield address_port.replace(' ','')

 def crawl_ip3366(self):
  for i in range(1, 4):
   start_url = 'http://www.ip3366.net/?stype=1&page={}'.format(i)
   html = get_page(start_url)
   if html:
    find_tr = re.compile('<tr>(.*?)</tr>', re.S)
    trs = find_tr.findall(html)
    for s in range(1, len(trs)):
     find_ip = re.compile('<td>(\d+\.\d+\.\d+\.\d+)</td>')
     re_ip_address = find_ip.findall(trs[s])
     find_port = re.compile('<td>(\d+)</td>')
     re_port = find_port.findall(trs[s])
     for address,port in zip(re_ip_address, re_port):
      address_port = address+':'+port
      yield address_port.replace(' ','')

 def crawl_kuaidaili(self):
  for i in range(1, 4):
   start_url = 'http://www.kuaidaili.com/free/inha/{}/'.format(i)
   html = get_page(start_url)
   if html:
    ip_address = re.compile('<td data-title="IP">(.*?)</td>')
    re_ip_address = ip_address.findall(html)
    port = re.compile('<td data-title="PORT">(.*?)</td>')
    re_port = port.findall(html)
    for address,port in zip(re_ip_address, re_port):
     address_port = address+':'+port
     yield address_port.replace(' ','')
代码中定义了一个ProxyMetaclass元类,Crawl类将其设为元类。在元类的__new__方法中,遍历类的属性字典,若方法名包含“crawl_”,则将其加入CrawlFunc列表属性中,从而自动注册所有抓取方法。
该架构支持灵活添加代理源,不仅限于免费代理,也可接入付费代理。付费代理的提取逻辑类似,通过Web请求获取数据后解析(可能更简单,如解析纯文本或JSON),最终以相同格式返回,支持用户自行扩展。
utils.py模块说明
网络请求工具封装
import requests
from requests.exceptions import ConnectionError

base_headers = {
 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/77.0.3865.120 Safari/537.36',
 'Accept-Encoding': 'gzip, deflate, sdch',
 'Accept-Language': 'en-US,en;q=0.9,zh-CN;q=0.8,zh;q=0.7'
}

def get_page(url, options={}):

 headers = dict(base_headers, **options)
 print('正在抓取', url)
 try:
  response = requests.get(url, headers=headers)
  print('抓取成功', url, response.status_code)
  if response.status_code == 200:
   return response.text
 except ConnectionError:
  print('抓取失败', url)
  return None
封装了get_page函数,用于访问指定链接并返回网页HTML内容,便于后续提取具体数据。该函数供各crawler模块统一调用。
执行抓取操作
getter.py模块说明
主程序调度与执行
from crawler import Crawler
from setting import *
import sys

class Getter():
 def __init__(self):
  self.crawler = Crawler()

 def run(self):
  print('获取器开始执行')
  for callback_label in range(self.crawler.__CrawlFuncCount__):
   callback = self.crawler.__CrawlFunc__[callback_label]
   # 获取代理
   all_ip = self.crawler.get_proxies(callback)

if __name__ == '__main__':
 get = Getter()
 get.run()
程序运行输出示例
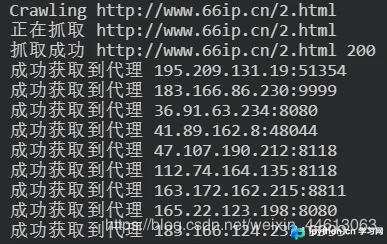
成功抓取到网站上的免费IP,但其实际可用性尚需后续步骤验证。
整体流程本质上是一个普通的爬虫程序,且目标网站反爬措施较弱。既然已涉及代理IP的使用,代码中的访问与抓取细节应易于理解。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















