


Python jieba库用法及实例解析

发布时间:2026-10-13 |
5人浏览过
本文详细介绍Python中优秀的中文分词第三方库jieba。解析其基于中文词库的分词原理,对比精确模式、全模式和搜索引擎模式三种分词方式的区别。通过统计《三国演义》人物出场次数的完整代码示例,展示jieba在实际文本处理中的应用,帮助开发者掌握分词技巧与数据处理流程。
jieba库基本介绍
1、jieba库基本介绍
jieba库概述
(1)、jieba库概述
jieba是一个性能优异的中文分词第三方库。
- - 中文文本处理通常需要先通过分词技术获取独立的词语单元
- - jieba作为优秀的中文分词第三方库,用户需自行安装使用
- - jieba库支持三种分词模式,掌握核心函数即可满足基本需求
jieba分词的原理
(2)、jieba分词的原理
Jieba分词机制依赖于内置的中文词库。
- 通过加载中文词库,计算汉字之间的关联概率 - 将概率较高的汉字组合成词组,从而生成最终的分词结果
- 除了自动分词功能外,用户还可以手动添加自定义词组以优化结果
jieba库使用说明
jieba库使用说明
jieba分词的三种模式
(1)、jieba分词的三种模式
精确模式、全模式、搜索引擎模式
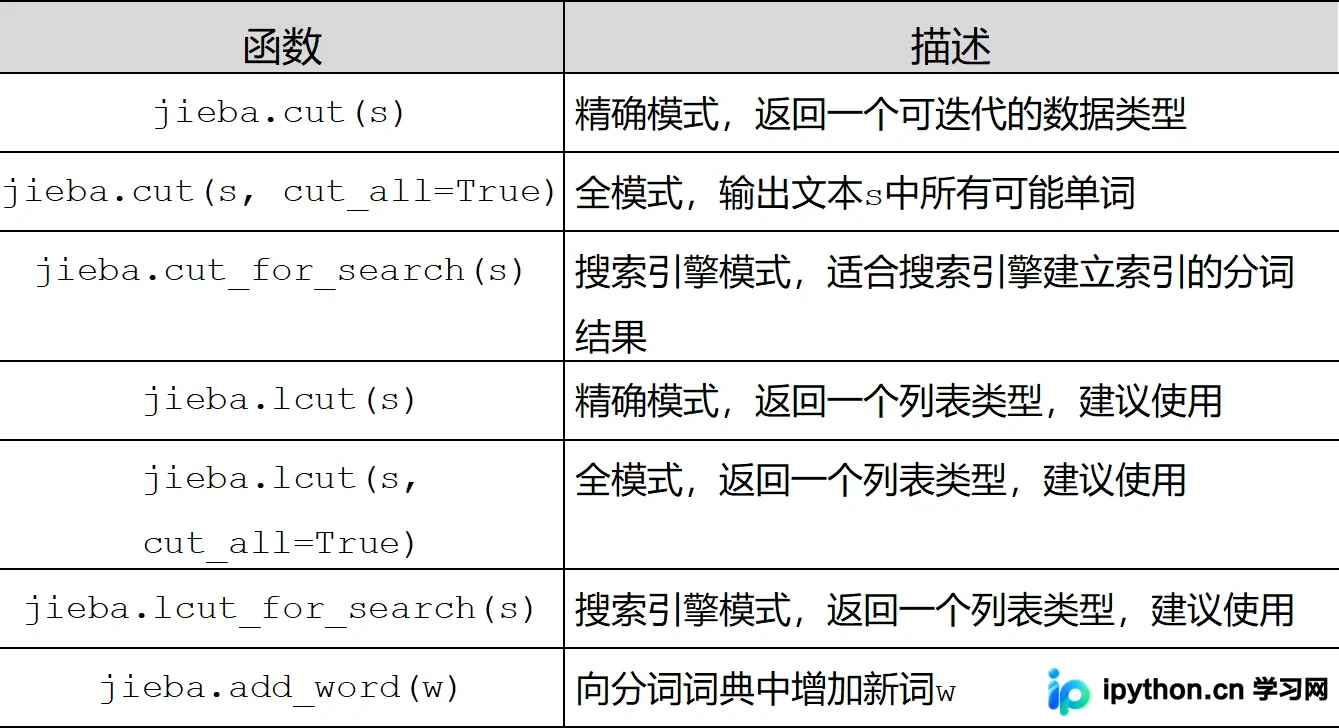
- - 精确模式:旨在将文本精确切分为不重叠的词语,确保无冗余单词
- - 全模式:扫描文本中所有可能的词语组合,输出结果包含冗余信息
- - 搜索引擎模式:在精确模式的基础上,对长词进行二次切分,以适配搜索场景
(2)、jieba库常用函数
jieba应用实例
2.jieba应用实例
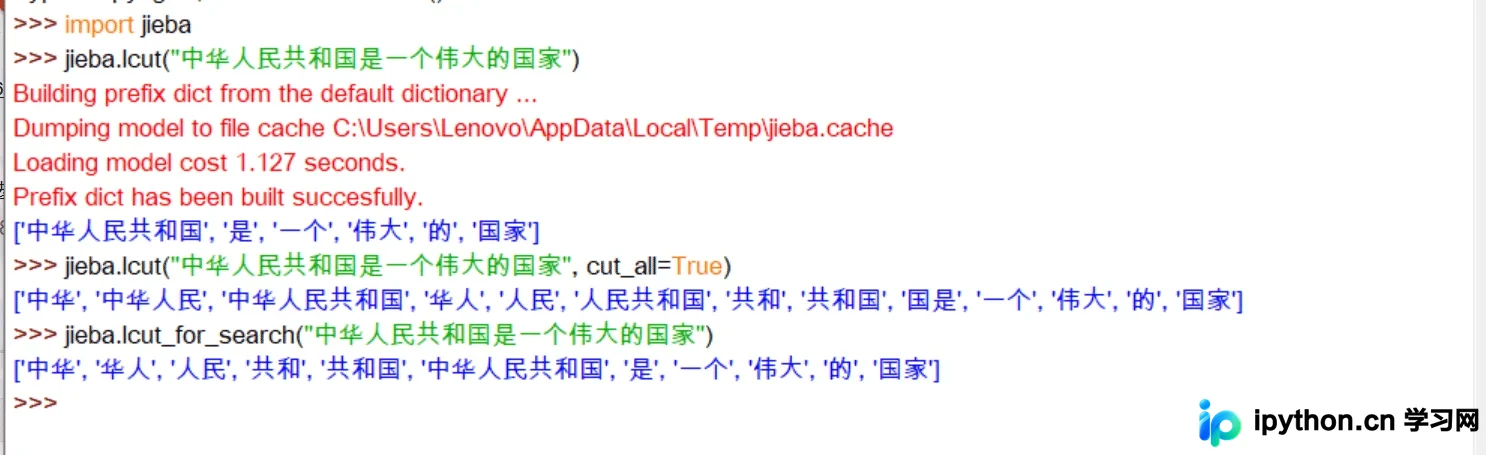
3.利用jieba库统计三国演义中任务的出场次数
统计三国演义人物出场次数
import jieba

txt = open("D:\\三国演义.txt", "r", encoding='utf-8').read()
words = jieba.lcut(txt)   # 使用精确模式对文本进行分词
counts = {}   # 通过键值对的形式存储词语及其出现的次数

for word in words:
  if len(word) == 1:  # 单个词语不计算在内
    continue
  else:
    counts[word] = counts.get(word, 0) + 1  # 遍历所有词语,每出现一次其对应的值加 1

items = list(counts.items())#将键值对转换成列表
items.sort(key=lambda x: x[1], reverse=True)  # 根据词语出现的次数进行从大到小排序

for i in range(15):
  word, count = items[i]
  print("{0:<5}{1:>5}".format(word, count))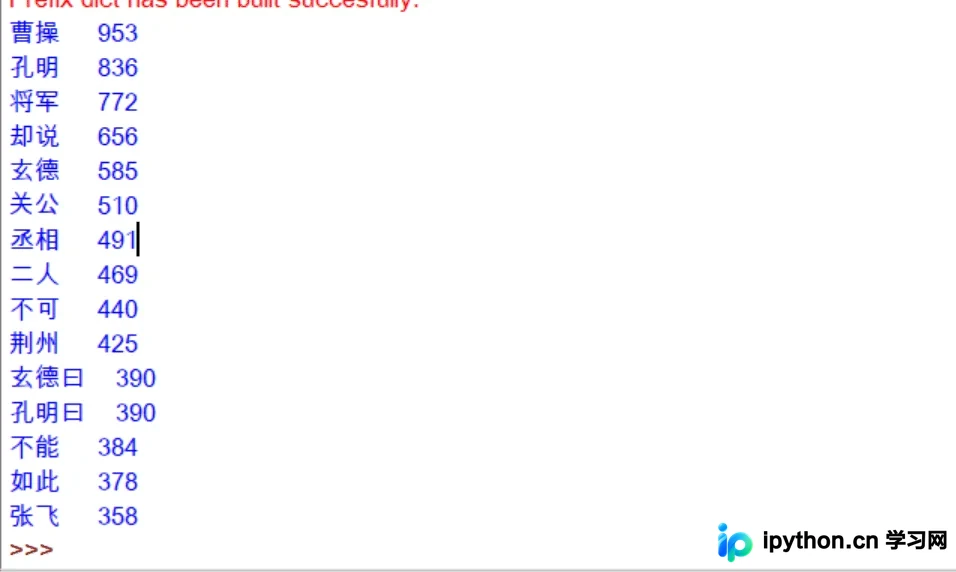
统计了次数对多前十五个名词,曹操不愧是一代枭雄,第一名当之无愧,但是我们会发现得到的数据还是需要进一步处理,比如一些无用的词语,一些重复意思的词语。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















