


Python爬虫实战:抓取中国天气网7日预报详解

发布时间:2026-10-13 |
4人浏览过
本文介绍使用Python抓取中国天气网城市近7天天气预报的完整流程。通过F12开发者工具分析HTML结构,定位日期、温度、风向等关键标签,编写Requests请求与BeautifulSoup解析代码,实现数据提取与格式化输出,并提供完整示例供参考。
Python获取城市近7天天气预报教程
本文详细讲解如何利用Python语言获取指定城市未来7天的天气预报数据。文中通过具体的示例代码展示了实现过程,内容详实,对希望学习网络爬虫或进行气象数据抓取的朋友具有较高的参考价值。
确定目标网页与链接
第一步,访问中国天气网官网,定位到目标城市(例如黄石市)的7日天气详情页。
目标网页链接为:http://www.weather.com.cn/weather/101200601.shtml
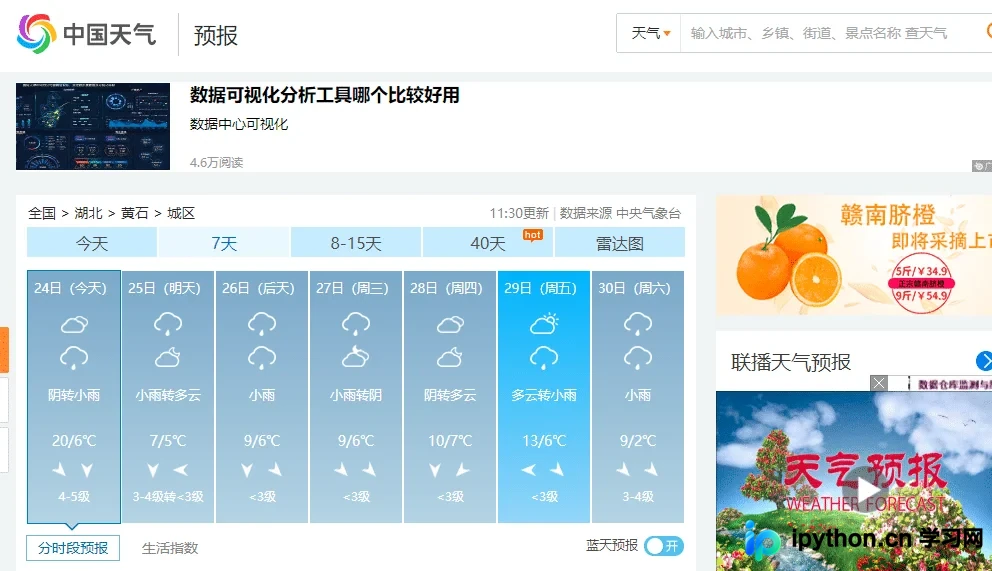
分析网页DOM结构
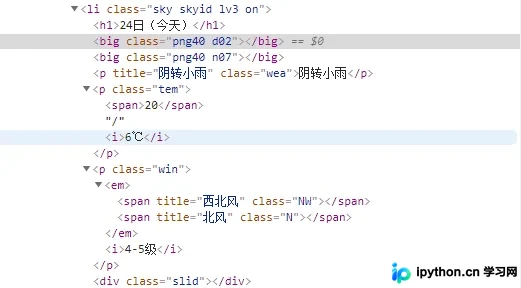
接着,按下F12键打开浏览器开发者工具,深入分析网页的DOM结构,识别并理解各个HTML标签的具体含义。其中,h1标签用于显示日期,p标签包含天气状况描述,tem-span标签对应最高气温,tem-i标签对应最低气温,win标签表示风力等级,em标签代表风向,而win-i标签则用于展示风力数值。
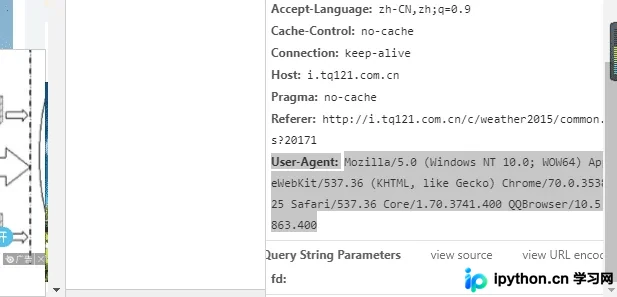
设置User-Agent代理
在发起网络请求前,必须获取并设置正确的User-Agent(用户代理),以模拟正常浏览器访问,避免被服务器拦截。
完成结构分析与代理设置后,即可开始编写Python代码。以下展示了完整的代码实现及其运行结果。
Python代码实现与运行
import re
import requests
from bs4 import BeautifulSoup

def get_page(url): #获取URL
  try:
    headers = {'user-agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.90 Safari/537.36'}
    r = requests.get(url,headers)
    r.raise_for_status()
    r.encoding = r.apparent_encoding
    return r.text
  except:
    return '出现异常' #异常处理,防止出现错误

def parse_page(html, weather_list):
  soup = BeautifulSoup(html, 'html.parser')
  day_list = soup.find('ul', 't clearfix').find_all('li')
  for day in day_list:
    date = day.find('h1').get_text()
    wea = day.find('p', 'wea').get_text()
    if day.find('p', 'tem').find('span'): #判断标签'p','tem'下是否有标签'span',以此判断是否有最高温
        tem_h = day.find('p', 'tem').find('span').get_text()
    else:
        tem_h = '' #最高温
    tem_l = day.find('p', 'tem').find('i').get_text() #最低温
    win1 = re.findall('(?<= title=").*?(?=")', str(day.find('p','win').find('em')))
    win2 = '-'.join(win1) #风向,win1-win2
    level = day.find('p', 'win').find('i').get_text() #风力
    weather_list.append([date, wea, tem_l, tem_h, win2, level])


def print_wea(weather_list):
  s = ' \t' * 3
  print(s.join(('日期', '天气', '最低温', '最高温', '风向', '风力')))
  for i in weather_list:
    print(i[0], '\t',i[1],'\t\t\t',i[2],'\t\t\t',i[3],'\t\t',i[4],'\t\t',i[5]) #按格式输出

def main():
  url = 'http://www.weather.com.cn/weather/101200601.shtml'
  html = get_page(url)
  wea_list = []
  parse_page(html, wea_list)
  print("\t\t\t\t\t\t\t\t\t黄石市近7天天气预报")
  print_wea(wea_list)

if __name__ == '__main__':
  main()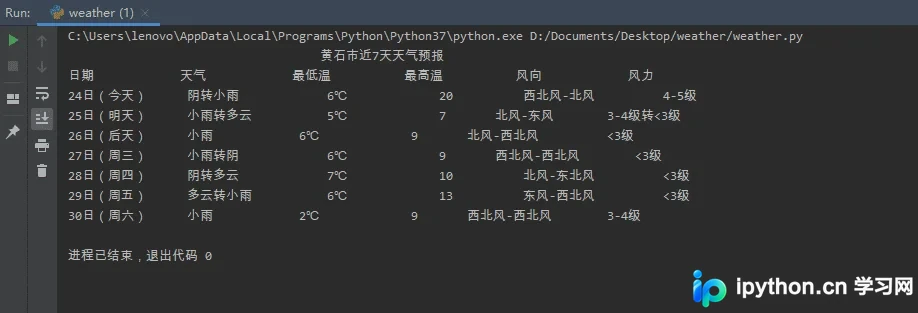
目前的代码在格式化输出方面仍有优化空间,存在一定局限性。在此分享出来,旨在抛砖引玉,欢迎大家交流讨论,共同改进代码质量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















