


Python读取.mat文件并提取数据:从scipy到pandas的完整流程

发布时间:2026-10-13 |
6人浏览过
本文详解如何使用Python读取.mat文件并提取所需信息。通过scipy.io.loadmat加载文件,解析返回的字典结构,获取指定Key对应的numpy数组。随后利用pandas将多维数组转换为DataFrame格式,便于后续的数据展示与分析处理。
本文详细介绍如何利用Python读取.mat文件并提取其中的关键信息。文中提供了详细的示例代码,对学习和工作具有参考价值,适合需要处理MATLAB格式数据的读者参考。
导入依赖库
首先,需要导入必要的Python库以支持后续操作。
from scipy.io import loadmat读取.mat文件
接下来,使用scipy库中的loadmat函数来读取.mat文件。
从示例文件中随机选取一个.mat文件进行读取操作。
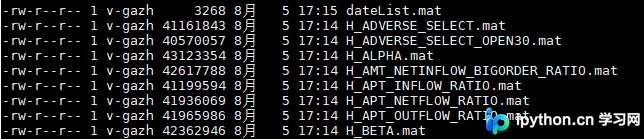
m = loadmat('H_BETA.mat') # 读出来的 m 是一个dict(字典)数据结构读取后得到的m变量内容如下所示,它是一个包含元数据及实际数据的字典。
m:{'__header__': b'MATLAB 5.0 MAT-file, Platform: GLNXA64, Created on: Mon Aug 5 17:14:09 2019',
 '__version__': '1.0',
 '__globals__': [],
 'H_BETA': array([[ 0.68508148, 0.36764355, 0.73505849, ..., 0.27600164,
     0.67968929, 0.70506438],
    [ 0.74920812, 1.10949748, 0.47506305, ..., 0.32871445,
     0.61247345, 1.06948844],
    [ 0.83311522, 1.06321302, 0.97364609, ..., 0.85837753,
     0.96296771, 1.46095171],
    ...,
    [    nan,     nan,     nan, ...,     nan,
         nan, -9.04648469],
    [    nan,     nan,     nan, ...,     nan,
         nan,     nan],
    [    nan,     nan,     nan, ...,     nan,
In [29]: m.keys()
Out[29]: dict_keys(['__header__', '__version__', '__globals__', 'H_BETA'])
提取指定数据
为了获取.mat文件中特定的数据,需要按照字典的键值对形式进行提取。
由于.mat文件内部的数据结构本质上是字典(dict),因此取值时必须遵循key:value的格式。
In [30]: m['H_BETA']
Out[30]:
array([[ 0.68508148, 0.36764355, 0.73505849, ..., 0.27600164,
     0.67968929, 0.70506438],
    [ 0.74920812, 1.10949748, 0.47506305, ..., 0.32871445,
     0.61247345, 1.06948844],
    [ 0.83311522, 1.06321302, 0.97364609, ..., 0.85837753,
     0.96296771, 1.46095171],
    ...,
    [    nan,     nan,     nan, ...,     nan,
        nan, -9.04648469],
    [    nan,     nan,     nan, ...,     nan,
        nan,     nan],
    [    nan,     nan,     nan, ...,     nan,
        nan,     nan]])

In [31]: type(m['H_BETA'])
Out[31]: numpy.ndarray
数据预处理与转换
在获取原始数据后,通常需要进行预处理以方便后续使用。
读取得到的数据类型为ndarray,为了更直观地展示和处理数据,可以将其转换为pandas库中的DataFrame对象。
In [32]: import pandas as pd
In [33]: df = pd.DataFrame(m['H_BETA'])
In [34]: df.head()
Out[34]:
    1     2     3     4     5     6     7     8     9     10
 0.685081 0.367644 0.735058 0.085046 0.104332 0.560731 0.350219 0.758185 0.303823 0.114022 0.452877
 0.749208 1.109497 0.475063 0.896100 1.117772 0.611356 0.662669 0.603077 0.863930 0.756870 0.725808
 0.833115 1.063213 0.973646 0.935061 0.631670 0.916800 0.662993 0.543231 0.671558 1.027954 0.526402
 0.488906 0.932741 0.956622 0.573116 0.893764 0.987304 0.380807 1.211157 0.550213 0.898408 1.153289
 0.440694 0.503209 0.509693 0.477054 0.344717 -0.054662 1.124213 0.344906 0.612898 0.217625 -0.129715

[5 rows x 2111 columns]
经过上述转换,数据格式变得规整。此时,可以根据实际需求选择保存为文件或进行其他进一步的处理。
以上就是本文的全部内容,希望能为读者提供有益的帮助,欢迎大家继续支持本站获取更多技术资源。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















