


TensorFlow自定义梯度实现:重写机制与Stop Gradient详解

本文介绍TensorFlow中两种自定义反向传播梯度的方法。第一种通过tf.RegisterGradient注册新梯度并使用gradient_override_map覆盖原操作,适用于不可导节点如符号函数的平滑近似。第二种利用tf.stop_gradient阻断前向梯度传播,实现前向与反向函数的解耦,常用于梯度反转场景。文章提供具体代码示例及注意事项,帮助开发者灵活控制梯度流。
前言
TensorFlow自定义梯度的应用场景
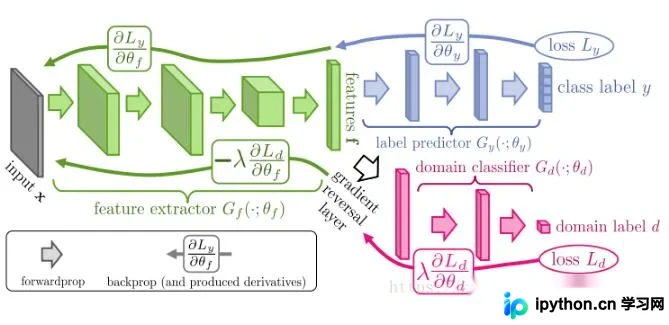
在深度学习模型训练中,有时需要对特定节点的梯度进行定制处理。特别是当某些操作不可导(例如涉及  等阶梯除法或离散操作)时,若仍需保留该操作并希望其支持反向传播,就必须定义自定义的梯度计算规则。在某些特定场景下,如文献[2]所述的梯度反转(Gradient Inversion)任务中,必须修改某层节点的反向传播逻辑,即对反向梯度进行翻转处理,具体机制可参考
 所示的流程。
在TensorFlow框架中,存在多种实现自定义梯度的途径,本文将重点介绍其中两种常用且有效的方法。
方法一:重写梯度法(Override Gradient)
1. 重写梯度法
重写梯度法(Override Gradient)利用TensorFlow内置机制,直接覆盖特定操作节点的默认梯度计算逻辑。该方法适用范围广泛,下面通过一个具体案例[3]进行说明。
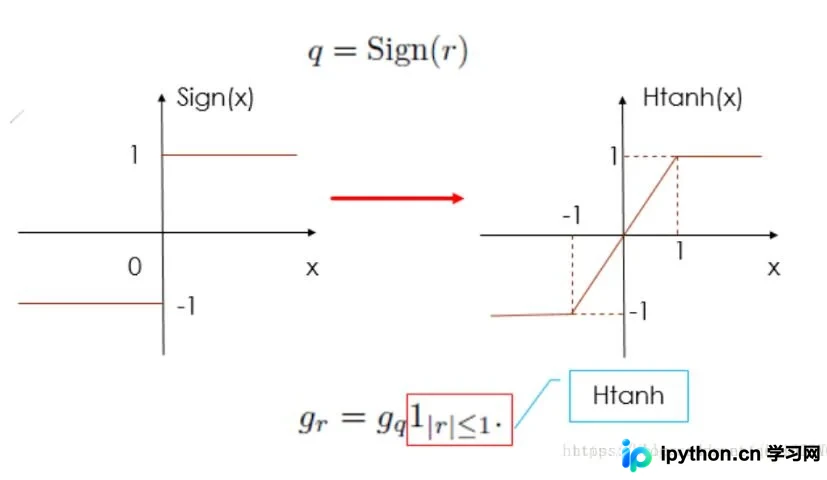
以符号函数为例,其前向传播采用阶跃函数 y = \rm{sign}(x),如图所示。由于阶跃函数在零点不连续且不可导,直接反向传播会导致梯度消失或报错。因此,在反向传播阶段,通常将其替换为可微的近似函数 y = \rm{Htanh}(x)。此时,梯度计算规则变为:当输入值大于1或小于-1时梯度为0,而在-1到1之间时梯度为1。
实现重写梯度的核心步骤涉及两个关键API:tf.RegisterGradient() 用于注册新的梯度计算函数,tf.get_default_graph().gradient_override_map() 用于在图中指定操作节点的梯度替换。例如,将名为 'Sign' 的操作节点的梯度替换为新注册的 'QuantizeGrad',具体实现代码如下。
重写梯度法代码实现
#使用修饰器,建立梯度反向传播函数。其中op.input包含输入值、输出值,grad包含上层传来的梯度
@tf.RegisterGradient("QuantizeGrad")
def sign_grad(op, grad):
 input = op.inputs[0] # 取出当前的输入
 cond = (input>=-1)&(input<=1) # 大于1或者小于-1的值的位置
 zeros = tf.zeros_like(grad) # 定义出0矩阵用于掩膜
 return tf.where(cond, grad, zeros)
 # 将大于1或者小于-1的上一层的梯度置为0

#使用with上下文管理器覆盖原始的sign梯度函数
def binary(input):
 x = input
 with tf.get_default_graph().gradient_override_map({"Sign":'QuantizeGrad'}):
 #重写梯度
  x = tf.sign(x)
 return x

#使用
x = binary(x)
在自定义梯度函数 def sign_grad(op, grad): 中,op 参数包含当前操作的输入张量及输出信息,而 grad 参数则代表从反向传播回传的上一层梯度。
在TensorFlow中实现自定义梯度时,tf.identity() 函数扮演着重要角色。其API定义如下。
tf.identity(
 input,
 name=None
)
tf.identity() 返回与输入形状和内容完全一致的输出张量,但允许用户自定义其反向传播时的梯度行为。因此,在需要执行梯度反转等特殊操作时,该函数尤为关键。
接下来展示另一个梯度反转[2]的示例,其中梯度计算结果为  而非
 。
import tensorflow as tf
x1 = tf.Variable(1)
x2 = tf.Variable(3)
x3 = tf.Variable(6)
@tf.RegisterGradient('CustomGrad')
def CustomGrad(op, grad):
#  tf.Print(grad)
 return -grad

g = tf.get_default_graph()
oo = x1+x2
with g.gradient_override_map({"Identity": "CustomGrad"}):
 output = tf.identity(oo)
grad_1 = tf.gradients(output, oo)
with tf.Session() as sess:
 sess.run(tf.global_variables_initializer())
 print(sess.run(grad_1))
由于计算的是 -grad,因此最终的梯度输出为 [-1] 而非 [1]。需要注意的是,在自定义函数 def CustomGrad() 中,返回值必须是一个张量(Tensor),而不能返回标量参数(如 return 0)。若返回非张量类型,程序将报错,错误示例如下。
AttributeError: 'int' object has no attribute 'name'报错原因在于TensorFlow内部操作需要获取返回值的名称属性,而整型(int)对象不具备 name 属性。
补充说明:def CustomGrad() 的函数签名名称由用户自定义,无固定限制。
方法二:Stop Gradient法
2. Stop Gradient法
除了重写梯度,还有一种更简洁的自定义梯度实现方式,即利用 tf.stop_gradient() 函数。具体示例[1]如下。
Stop Gradient法代码实现
t = g(x)
y = t + tf.stop_gradient(f(x) - t)
在此场景中,前向传递函数为 f(x),但希望反向传播时使用函数 g(x)。由于 tf.stop_gradient() 在前向传播过程中不起作用(即不阻断前向数据流),表达式 +t 和 -t 相互抵消,最终前向输出仍为 f(x)。而在反向传播过程中,由于 tf.stop_gradient() 的作用,f(x)-t 这一分支的梯度被截断为0,从而使得只有 g(x) 的梯度参与反向传播。
以下是完整的实现代码示例。
import tensorflow as tf

x1 = tf.Variable(1)
x2 = tf.Variable(3)
x3 = tf.Variable(6)

f = x1+x2*x3
t = -f

y1 = t + tf.stop_gradient(f-t)
y2 = f

grad_1 = tf.gradients(y1, x1)
grad_2 = tf.gradients(y2, x1)
with tf.Session(config=config) as sess:
 sess.run(tf.global_variables_initializer())

 print(sess.run(grad_1))
 print(sess.run(grad_2))
运行结果显示,第一个梯度输出为 [-1],第二个梯度输出为 [1],成功实现了梯度反转的效果。
以上关于TensorFlow中两种自定义梯度方式的介绍到此结束,希望能为相关开发者提供参考与帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















