


Python实现疫情数据爬虫完整源码解析

发布时间:2026-10-13 |
3人浏览过
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。
疫情数据概述
疫情数据
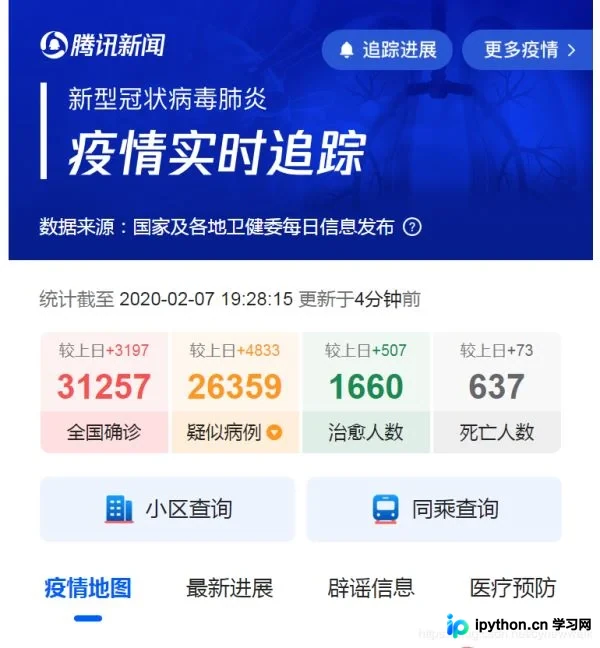
Python爬虫源码实现
程序源码
// An highlighted block
import requests
import json
class epidemic_data():
  def __init__(self, province):
    self.url = url
    self.header = header
    self.text = {}
    self.province = province
    # self.r=None
  def down_page(self):
    r = requests.get(url=url, headers=header)
    self.text = r.text
    # self.r = r
  def parse_page(self):
    # print(type(self.r.json()['data']))
    # 因为解析数据为 data 前有一个"",所以数据类型为string
    data_str = json.loads(self.text)['data'] #sring
    # print(type(data_dict))
    # print(type(data_dict['data']))
    # 将str 转化为对象
    data_json = json.loads(data_str)
    data_tree_dict = data_json['areaTree'][0]['children'] # 取中国的省列表
    prt_str = []
    prt_str.append("数据更新时间:"+data_json['lastUpdateTime'])
    prt_str.append("全国" + ":" + "累计确诊病例:" + str(data_json['chinaTotal']['confirm']) + \
            "累计疑似病例:" + str(data_json['chinaTotal']['suspect']) + \
            "累计死亡病例:" + str(data_json['chinaTotal']['dead']) + \
            "累计出院病例:" + str(data_json['chinaTotal']['heal']) + \
            "今日新增确诊病例:" + str(data_json['chinaAdd']['confirm']) + \
            "今日新增疑似病例:" + str(data_json['chinaAdd']['suspect']) + \
            "今日新增死亡病例:" + str(data_json['chinaAdd']['dead']) + \
            "今日新增出院病例:" + str(data_json['chinaAdd']['heal']))
    for province_list in data_tree_dict:
      for provice_name in self.province:
        if provice_name in province_list['name']:
          city_list = province_list['children']
          prt_str.append(province_list['name'] + ":" + "累计确诊病例:" + str(province_list['total']['confirm']) + \
                    "累计死亡病例:" + str(province_list['total']['dead']) + \
                    "累计出院病例:" + str(province_list['total']['heal']) + \
                    "今日新增确诊病例:" + str(province_list['today']['confirm']) + \
                    "今日新增死亡病例:" + str(province_list['today']['dead']) + \
                    "今日新增出院病例:" + str(province_list['today']['heal']))
          if provice_name == '山东':
            for data_dict in city_list:
              prt_str.append(data_dict['name'] + ":" + "累计确诊病例:" + str(data_dict['total']['confirm']) + \
                      "累计死亡病例:" + str(data_dict['total']['dead']) + \
                      "累计出院病例:" + str(data_dict['total']['heal']) + \
                      "今日确诊病例:" + str(data_dict['today']['confirm']) + \
                      "今日死亡病例:" + str(data_dict['today']['dead']) + \
                      "今日出院病例:" + str(data_dict['today']['heal']))
    for item in prt_str:
      print(item)
    a = data_tree_dict
    # print(type(data_tree_dict['chinaTotal']))
    # print(data_tree_dict.keys())
  def write_page(self):
    pass
  def show(self):
    pass
  def show(self):
    self.down_page()
    self.parse_page()
if __name__ == '__main__':
  url = 'https://view.inews.qq.com/g2/getOnsInfo?name=disease_h5'
  header = {
    'user - agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/79.0.3945.130 Safari/537.36'
  }
  province = ['湖北','山东']
  wf = epidemic_data(province)
  wf.show()
代码总结与说明
总结
以上所述是小编给大家介绍的python 爬取疫情数据的源码,希望对大家有所帮助!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















