


Python字典深浅拷贝机制与高效遍历方法解析

本文深入解析Python中字典、列表等可变对象的赋值、浅拷贝与深拷贝机制,通过内存地址变化直观展示区别。同时对比了字典的两种常见循环方式,指出直接遍历Key与items()方法的性能差异,为大数据量场景下的代码优化提供实践建议。
本节内容
- 深浅拷贝
- 循环方式
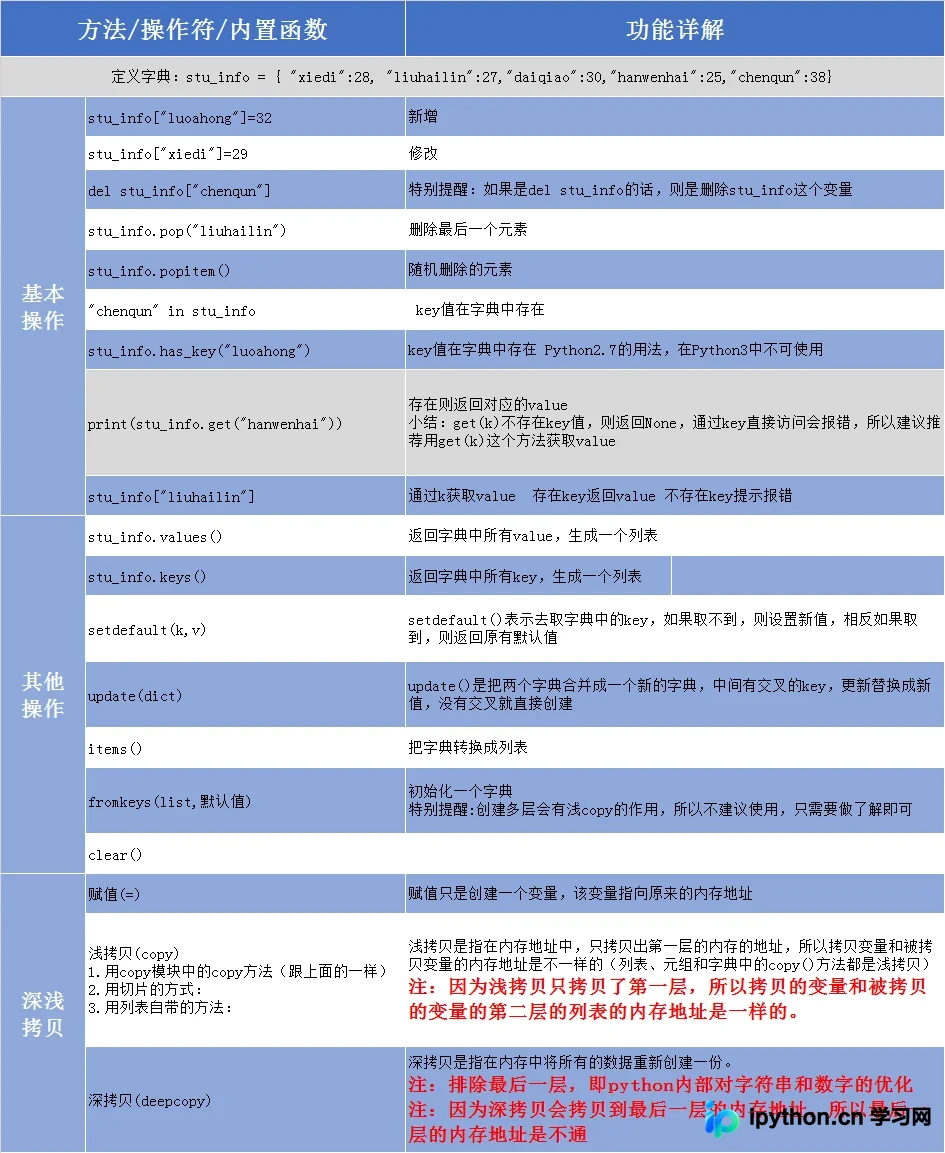
- 字典常用方法总结
一、深浅拷贝
列表、元组、字典(以及其他)
针对列表、元组及字典等可变对象,执行赋值操作(使用等号=)、浅拷贝(调用copy方法)或深拷贝(调用deepcopy方法)时,它们在内存中的地址分配情况存在显著差异。
赋值(=)
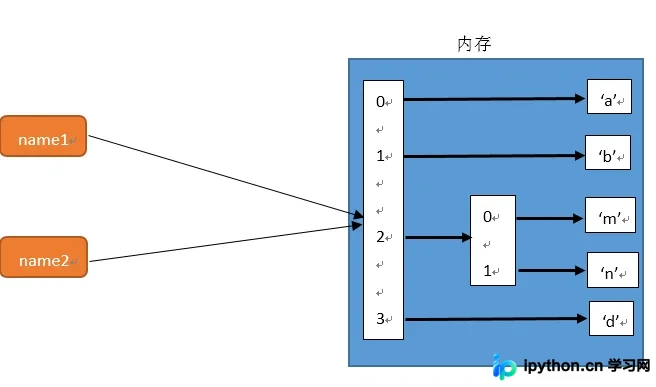
简单的赋值操作仅创建一个新的变量引用,该新变量直接指向原对象在内存中的同一地址,并未创建新对象。
>>> name1 = ['a','b',['m','n'],'c']
>>> name2 = name1
#输出结果,两个内存地址是一样的
>>> print(id(name1),',',id(name2))
50077256 , 50077256
如图所示:
浅拷贝(copy)
浅拷贝仅在内存中复制最外层对象的地址,因此拷贝后的变量与被拷贝变量的顶层内存地址不同。需要注意的是,列表、元组和字典内置的copy()方法均执行浅拷贝操作。
>>> import copy
>>> name1 = ['a','b',['m','n'],'c']
#浅copy
>>> name2 = copy.copy(name1)
>>> print(name1,',',id(name1))
['a', 'b', ['m', 'n'], 'c'] , 50228296
>>> print(name2,',',id(name2))
['a', 'b', ['m', 'n'], 'c'] , 50920008
#修改列表中的元素
>>> name1[0] = 'h'
>>> name1[2][0] = 'M'
>>> print(name1,',',id(name1))
['h', 'b', ['M', 'n'], 'c'] , 50228296
>>> print(name2,',',id(name2))
['a', 'b', ['M', 'n'], 'c'] , 50920008
如图所示:
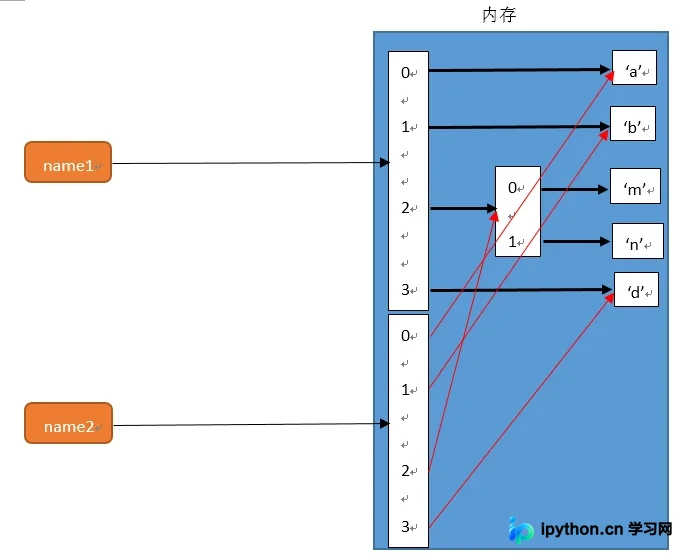
由于浅拷贝仅处理第一层,拷贝变量与被拷贝变量内部嵌套的第二层列表(或子对象)仍共享相同的内存地址。
>>> import copy
>>> name1 = ['a','b',['m','n'],'c']
>>> name2 = copy.copy(name1)
>>> name1[0] = 'h'
>>> name1[2][0] = 'M'
#name1[2][0]的内存地址和name2[2][0]内存地址是一样的
>>> print(name1,id(name1),id(name1[2][0]))
['h', 'b', ['M', 'n'], 'c'] 50209800 13820904
>>> print(name2,id(name2),id(name2[2][0]))
['a', 'b', ['M', 'n'], 'c'] 50891144 13820904
浅拷贝的三种表现形式:
1.使用copy模块中的copy函数(效果与上述示例一致)
2.采用切片操作实现:
>>> name1 = ['a','b',['m','n'],'c']
>>> name2 = name1[:]
3.利用列表或字典自带的方法:
>>> name1 = ['a','b',['m','n'],'c']
>>> name2 = name1.copy()
深拷贝(deepcopy)
深拷贝会在内存中递归地重新创建所有层级的数据,生成一个完全独立的副本。
注意:Python内部对字符串和数字进行了优化缓存,因此最后一层不可变对象(如字符串和数字)的内存地址可能相同,但这不影响整体深拷贝的独立性。
>>> import copy
>>> name1 = ['a','b',['m','n'],'c']
#深拷贝
>>> name2 = copy.deepcopy(name1)
>>> print(name1,',',id(name1))
['a', 'b', ['m', 'n'], 'c'] , 50142472
>>> print(name2,',',id(name2))
['a', 'b', ['m', 'n'], 'c'] , 50942280
>>> name1[0] = 'h'
>>> name1[2][0] = 'M'
>>> print(name1,id(name1),id(name1[2][0]))
['h', 'b', ['M', 'n'], 'c'] 50142472 10937320
>>> print(name2,id(name2),id(name2[2][0]))
['a', 'b', ['m', 'n'], 'c'] 50942280 4896280
如图所示:
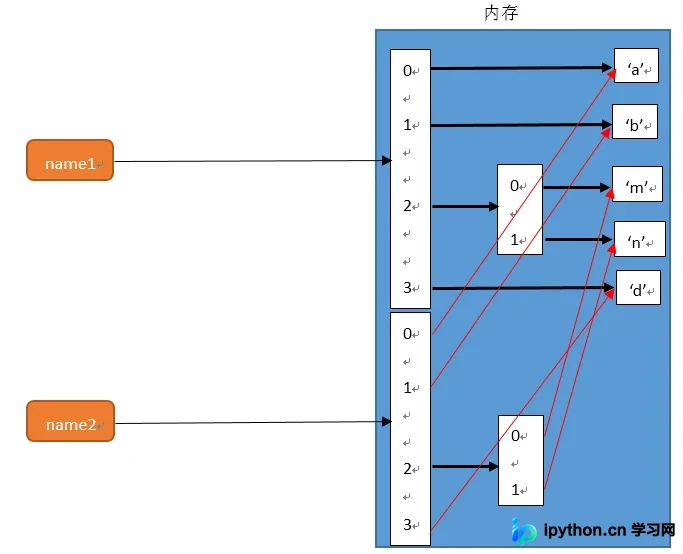
由于深拷贝会递归处理至最深层级,因此最后一层可变对象的内存地址是完全不同的,修改原对象不会影响拷贝对象。
二、循环方式
方法1、
for key in info:
  print(key,info[key])
方法2、
for k,v in info.items(): #会先把dict转成list,数据量大时莫用
  print(k,v)
小结:
①方法1的执行效率远高于方法2。
②方法1是直接通过Key获取对应的Value。
③方法2则是先将字典转换为键值对列表,再从中取值。
④当数据量较大时,方法2中字典转换为列表的过程会消耗大量时间;若数据量较小,两者效率差异不明显。
字典常用方法
更多关于Python字典深浅拷贝与循环方式方法请查看下面的相关链接
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















