


Pandas数据操作中的内存复制机制解析

发布时间:2026-10-13 |
5人浏览过
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
Pandas模块概述
pandas模块
Pandas是一个功能强大的结构化数据分析工具集,其核心基础依赖于Numpy以提供高效的矩阵运算能力。该库广泛应用于数据挖掘、数据分析以及数据清洗等场景,为处理大规模数据集提供了便捷的方法。
数据复制机制示例分析
作为Pandas系列教程的最后一部分,本文将重点探讨一个关键的数据“复制”问题。
具体示例如下:
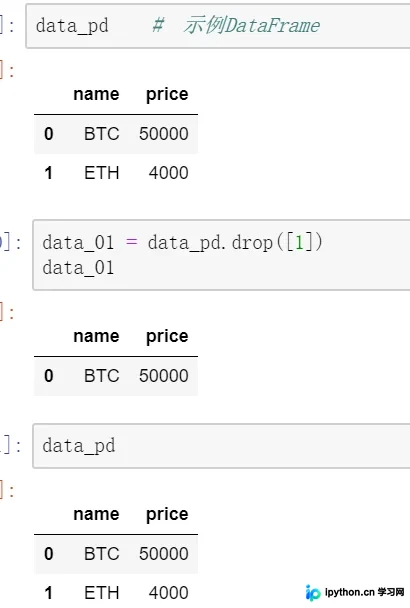
从上述示例中可以观察到,当我们对变量data_pd执行删除某行的操作时,原始变量data_pd在内存中的值并未发生直接改变。相反,系统开辟了一块新的内存区域来存放删除一行后的新数据。这种机制可以理解为:操作是在原数据的一份副本上进行的,从而确保原始数据不受影响,保障了数据的安全性。
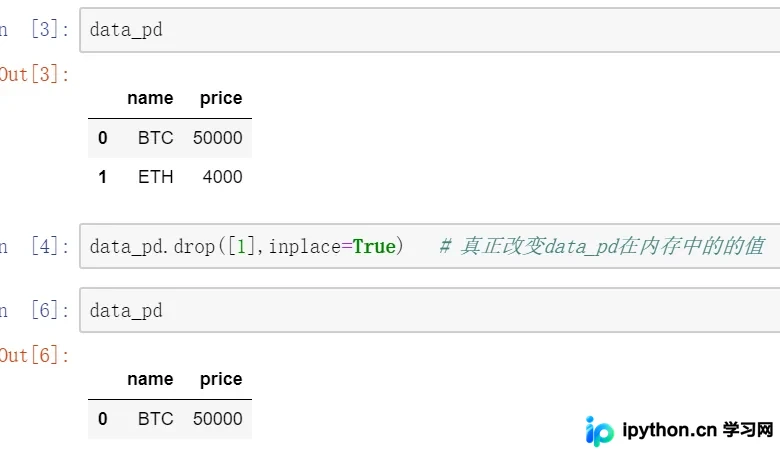
如果希望直接修改原数据的值,可以在上述操作方法中设置特定的参数来实现。
Python赋值与深浅复制展望
上述讨论的现象在Python编程领域中普遍存在。本文仅作为引子,笔者将在后续博文中深入探讨整个Python领域内关于“赋值与深浅复制”的完整机制。
总结
以上介绍了Python第三方库Pandas中关于数据操作与内存复制的相关内容,希望能为读者提供帮助!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















