


Python爬虫实战:Cookie持久化存储与SSL证书忽略处理

发布时间:2026-10-13 |
5人浏览过
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
Cookie的保存与读取机制
一、Cookie的保存与读取
1. Cookie的保存——使用FileCookieJar类
from urllib import request,parse
from http import cookiejar
#创建cookiejar实例
filename = "cookie.txt"
cookie = cookiejar.MozillaCookieJar(filename)
#生成cookie的管理器
cookie_handler = request.HTTPCookieProcessor(cookie)
#创建http请求管理器
http_handler = request.HTTPHandler()
#生成https管理器
https_handler = request.HTTPHandler()
#创建请求管理器
opener = request.build_opener(http_handler,https_handler,cookie_handler)
def login():
"""
负责初次登录
需要输入用户名密码
:return:
"""
url = "http://www.renren.com/PLogin.do"
data = {
"email":"1215217867@qq.com",
"password":"481648541615485"
}
#把数据进行编码
data = parse.urlencode(data)
#创建一个请求对象
req = request.Request(url,data=data.encode())
#使用opener发起请求
rep = opener.open(req)
#保存cookie到文件
#ignore_discard表示及时cookie将要被丢弃也要保存下来
#ignore_expire表示如果该文件中cookie即使已经过期,保存
cookie.save(ignore_discard=True,ignore_expires=True)
def getHomePage():
url = "http://www.renren.com/965187997/profile"
#如果已经执行了login函数,则opener自动已经包含相应的cookie值
rsp = opener.open(url)
html = rsp.read().decode()
with open("rsp.html","w") as f:
f.write(html)
if __name__ == "__main__":
"""
执行完login之后,会得到授权之后的cookie
我们尝试把cookie打印出来
"""
login()
getHomePage()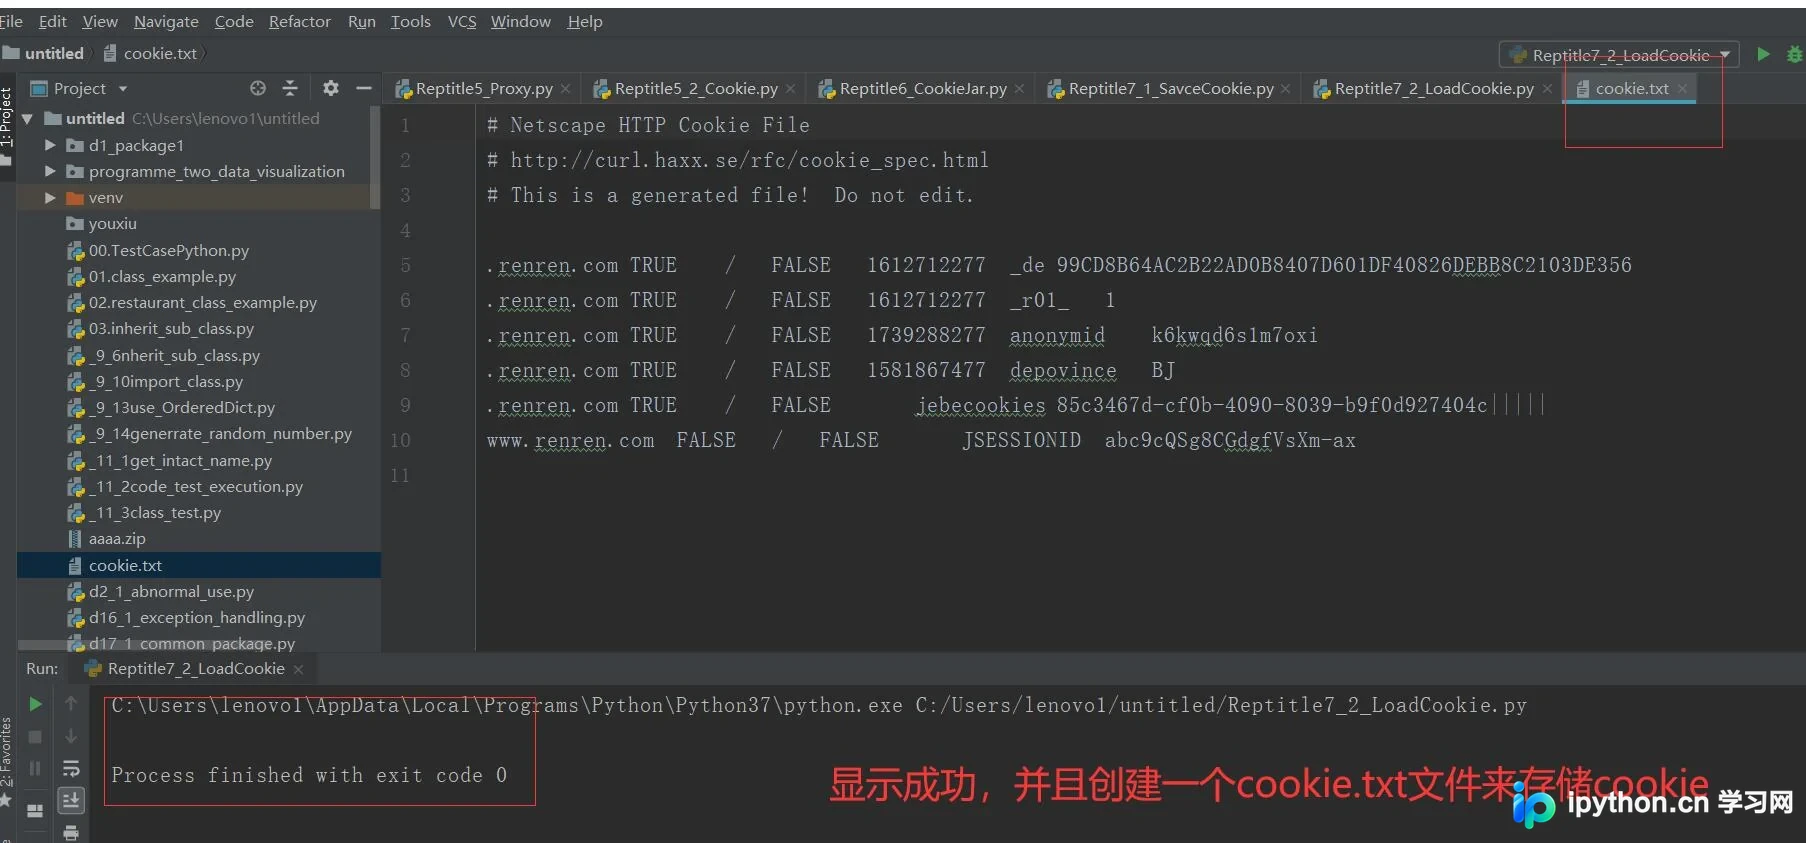
2. Cookie的读取
from urllib import request,parse
from http import cookiejar
#创建cookiejar实例
cookie = cookiejar.MozillaCookieJar()
cookie.load("cookie.txt",ignore_discard=True,ignore_expires=True)
#生成cookie的管理器
cookie_handler = request.HTTPCookieProcessor(cookie)
#创建http请求管理器
http_handler = request.HTTPHandler()
#生成https管理器
https_handler = request.HTTPHandler()
#创建请求管理器
opener = request.build_opener(http_handler,https_handler,cookie_handler)
def login():
"""
负责初次登录
需要输入用户名密码
:return:
"""
url = "http://www.renren.com/PLogin.do"
data = {
"email":"1215217867@qq.com",
"password":"481648541615485"
}
#把数据进行编码
data = parse.urlencode(data)
#创建一个请求对象
req = request.Request(url,data=data.encode())
#使用opener发起请求
rep = opener.open(req)
#保存cookie到文件
#ignore_discard表示及时cookie将要被丢弃也要保存下来
#ignore_expire表示如果该文件中cookie即使已经过期,保存
cookie.save(ignore_discard=True,ignore_expires=True)
def getHomePage():
url = "http://www.renren.com/965187997/profile"
#如果已经执行了login函数,则opener自动已经包含相应的cookie值
rsp = opener.open(url)
html = rsp.read().decode()
with open("rsp.html","w") as f:
f.write(html)
if __name__ == "__main__":
"""
执行完login之后,会得到授权之后的cookie
我们尝试把cookie打印出来
"""
# login()
getHomePage()通过修改代码,程序能够读取之前保存的Cookie文件,并成功访问目标网页。
SSL证书原理与忽略验证方法
二、SSL证书处理
1. 什么是SSL
(1)SSL证书是指遵循SSL安全套接层协议的服务器数字证书(Secure Socket Layer)。
(2)该证书最初由美国网景公司(Netscape)开发。
(3)CA(Certificate Authority,证书认证中心)是负责发放、管理及废除数字证书的第三方权威机构。
(4)在遇到不被信任的SSL证书时,可以通过代码配置忽略验证,从而继续执行请求。
from urllib import request
#导入python ssl处理模块
import ssl
#利用非认证上下文环境替换认证的下文环境
ssl._create_default_https_context = ssl._create_unverified_context
url = "https://www.12306.cn/mormhweb/"
rsp = request.urlopen(url)
html = rsp.read().decode()
print(html)
三、完整源码示例
Reptitle7_1_SaveCookie.py
Reptitle7_2_LoadCookie.py
Reptitle7_3_SSLAnalysis.py
以上就是本次介绍的全部相关知识点,感谢大家的学习和对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















