


MySQL乱码原理与修复指南:从‘错进错出’到正确转码

MySQL 乱码通常源于客户端、连接层与存储层的编码不一致。理解“错进错出”的原理有助于识别潜在风险,而使用 mysqldump 或二进制字段中转是修复已损坏数据的可靠途径,直接修改表字符集往往会导致二次破坏。
结果或目标
在处理多语言混合存储或迁移项目时,确保 UTF-8 或其他字符集在不同环境(Shell、Web终端、MySQL Server、InnoDB 引擎)间无损流转,是防止出现“???”或乱码符号的核心目标。
准备条件
- 环境认知:明确当前 Shell(如 Bash)、MySQL 客户端配置及目标表的默认字符集(Character Set)与排序规则(Collation)。
- 备份策略:在执行任何数据修复前,务必备份原始数据,尤其是涉及 `ALTER TABLE` 操作时。
真实操作顺序:MySQL 乱码原理与修复
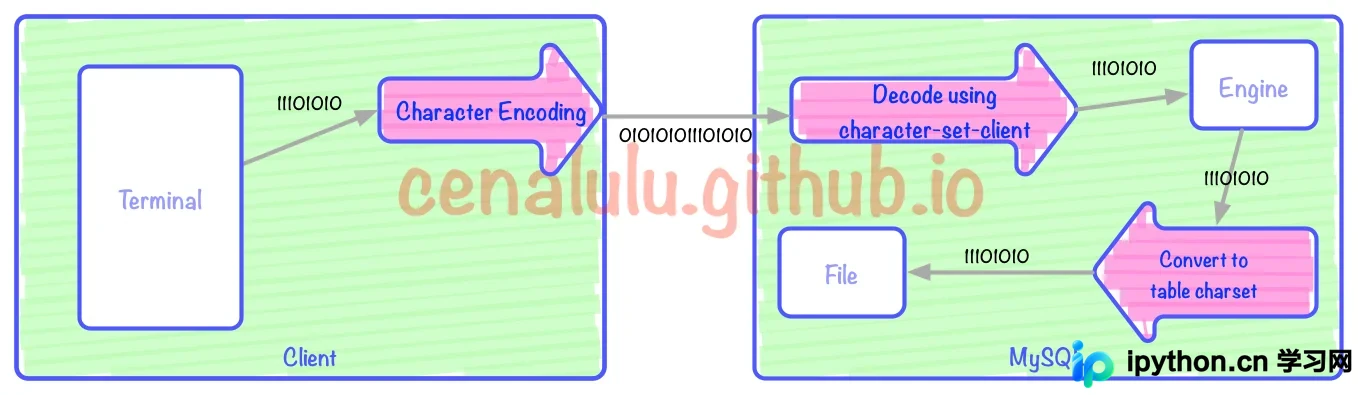
第1步:理解数据存入时的编码转换流程
目的:掌握数据从输入端到磁盘的流转路径,定位编解码节点。
动作说明:
- 客户端输入:用户在 Terminal 中输入字符,OS 将其转换为二进制流(基于终端编码,如 UTF-8 或 GBK)。
- 网络传输:二进制流通过 MySQL 客户端协议发送至 Server。
- Server 接收与解码:MySQL Server 根据
character-set-client对数据进行解码。 - 内部转换:检查客户端编码与表结构编码的一致性。若不一致且需要转换,则在内存中进行重新编码。
- 存储写入:最终的二进制流被写入 InnoDB 表文件。
此过程涉及三次关键的编/解码行为,任一环出错均可能导致最终显示异常。
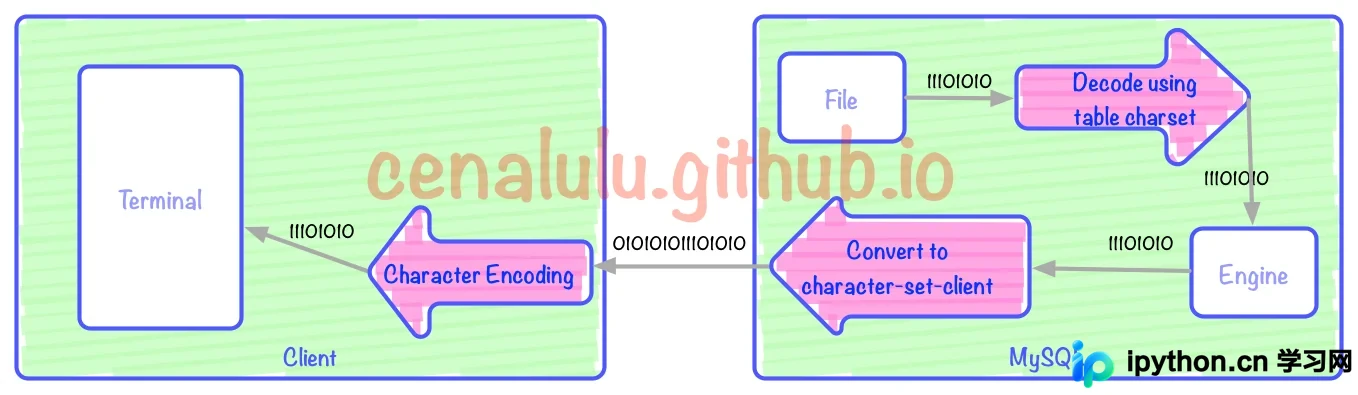
第2步:理解数据取出时的反向转换流程
目的:分析为何有时存入看似正常,取出却乱码。
动作说明:
- 磁盘读取:存储引擎按表定义的字符集读取字节流。
- 逻辑处理 :进行字符串函数操作(如
- 服务端编码:将处理后的结果按照
character-set-client进行编码。 - 客户端展示:Client 接收后按其自身配置的编码进行展示。
SUBSTR, LEFT)。
第3步:排查“三位一体”不一致导致的乱码
入口:观察插入时的 Warning 信息或直接查看查询结果。
动作说明:
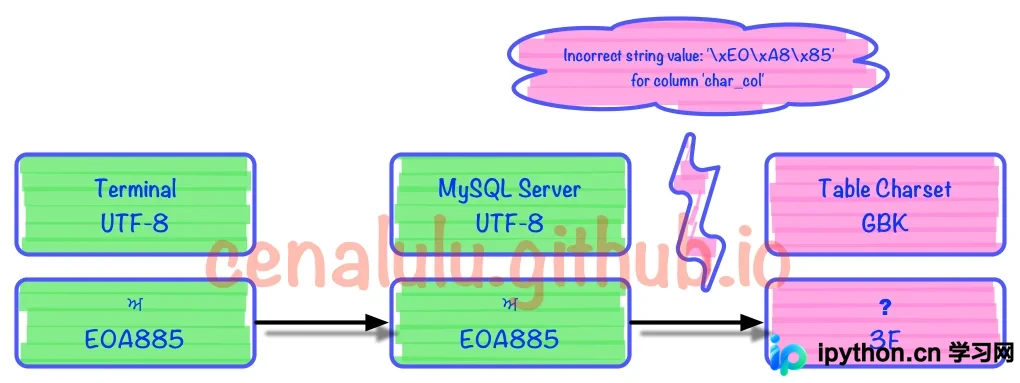
最常见的情况是存入时的 Client 编码与取出时的 Client 编码不一致,或者两者与表定义不符。例如:
-- 假设表为 utf8,但客户端强制指定 gbk
mysql> set names gbk;
mysql> insert into table_name (col) values ('中文');
-- 可能出现 Warning: Incorrect string value
完成状态判断:若 `SHOW WARNINGS` 中出现 1366 错误,或查出的十六进制值与预期不符,则确认存在编码不匹配。
第4步:深入理解“错进错出”与有损转换
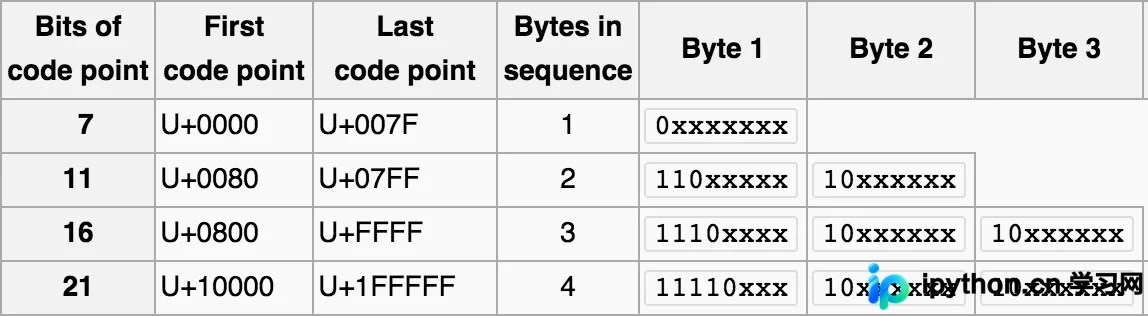
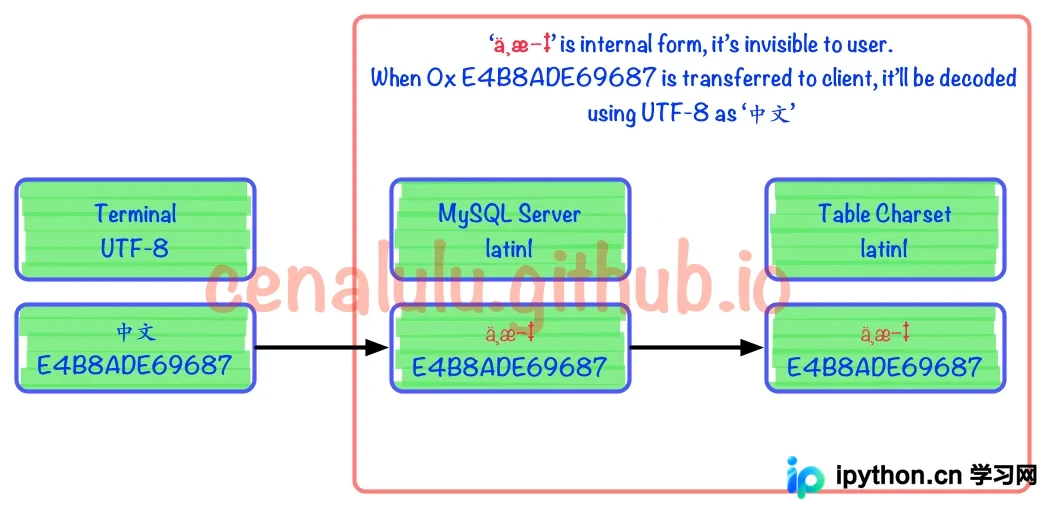
背景:“错进错出”指客户端编码与表编码不同,但利用 Latin1 等字符集“透传”特性,使得数据在特定条件下看起来不乱码的现象。这种方法极不稳定。
有损 vs 无损:
当源字符集包含的目标字符集不支持的字符时(如 UTF-8 中的生僻字存入 GBK 表),MySQL 会用 `?` 替换,造成永久丢失。Latin1 因常作为“二进制容器”保留原始字节,才实现了脆弱的“错进错出”。
风险提示:依赖 Latin1 中转是高风险操作,一旦迁移至严格模式或更改配置,数据将不可逆损坏。
第5步:实施正确的数据修复方案
风险提醒:严禁直接使用 ALTER TABLE tbl CONVERT TO CHARACTER SET utf8 修复已由“错进错出”产生的乱码,这会引发二次乱码。以下两种方法为官方推荐或社区验证的安全手段。
方法 A:Dump 与 Reload(推荐用于跨字符集迁移)
目的:利用导出工具的编码一致性,将数据以正确格式落盘再导入。
步骤:
- 使用
--default-character-set=utf8导出,同时禁用自动设置 charset 选项,确保导出的 SQL 文件内容即为我们要保存的 UTF-8 字节序列。 - 创建新的 UTF-8 字符集表结构。
- 导入 SQL 文件。
# 1. 导出:强制指定 UTF-8 发送,跳过添加 SET NAMES 语句
mysqldump -u root -p --skip-set-charset --default-character-set=utf8 dbname old_table > data.sql

# 2. 验证:用文本编辑器打开 data.sql,确认中文显示正常

# 3. 创建新表
create table new_table (...) DEFAULT CHARSET=utf8;

# 4. 导入
mysql -u root -p --default-character-set=utf8 dbname < data.sql
方法 B:转为 Binary 再转回(快速修补现有表)
目的:绕过 MySQL 的字符集校验,将乱码字节视为纯二进制中转。
步骤:
- 将列类型临时改为
VARBINARY或BLOB,此时 MySQL 不再尝试进行字符集转换,仅移动字节流。 - 再次将列类型改回
VARCHAR并指定正确的字符集(如utf8mb4)。
-- 第一步:剥离字符属性,当作二进制处理
ALTER TABLE your_table MODIFY COLUMN col_name VARBINARY(50);

-- 第二步:赋予正确的字符集,此时 MySQL 会将原始二进制流重新解释为新的字符集编码
ALTER TABLE your_table MODIFY COLUMN col_name VARCHAR(50) CHARACTER SET utf8mb4;
简要总结
解决 MySQL 乱码的关键在于保持全链路字符集一致。对于已发生“错进错出”导致的数据隐患,切勿盲目执行 CONVERT TO。应优先采用 mysqldump 结合指定字符集的方式重建数据,或利用 Binary 字段作为中介进行无损转码。预防永远重于治疗,建议在应用层和配置文件统一设置为 utf8mb4。
以上就是 MySQL 乱码原理分析及修复方法的详细内容,更多关于 MySQL 字符集优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















