


Linux网络诊断:traceroute与mtr排查

理解traceroute与mtr:看懂网络路径、延迟和丢包
traceroute与mtr是Linux环境下诊断网络连通性与路由路径的核心工具。它们通过发送带有递增TTL(生存时间)值的探测包,迫使沿途路由器逐跳返回ICMP超时或端口不可达报文,从而绘制出数据包从源端到目的端的完整转发路径。在输出结果中,“跳数”代表数据包经过的路由器数量,“地址”为各节点IP或主机名,“延迟”反映往返时间(RTT),而“丢包率”则体现探测包未获响应的比例。需要特别注意的是,中间节点显示高丢包或超时往往并非真实链路故障。许多运营商路由器出于安全策略或性能保护,会主动限速或丢弃ICMP探测包,导致探测失败,但实际业务流量(如TCP/UDP)仍可正常转发。因此,解读指标时应结合业务协议特征,避免将控制平面的探测限制误判为数据平面的链路中断。
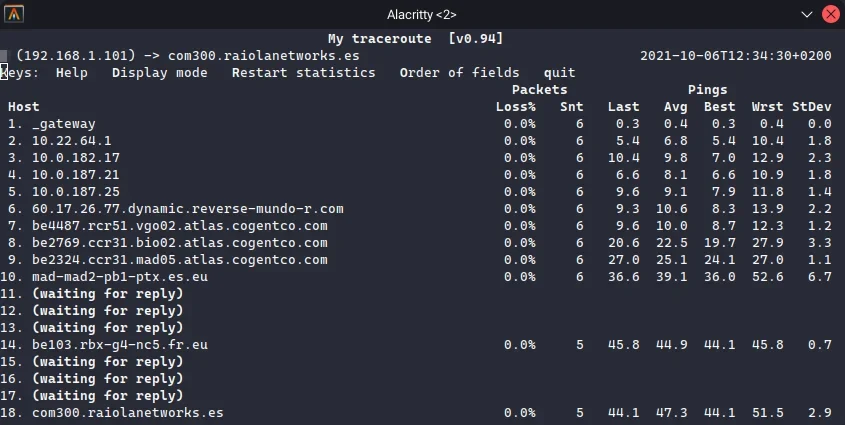
用traceroute定位异常路径:从本机到目标主机逐跳排查
使用traceroute进行逐跳排查时,基本命令格式为`traceroute [参数] 目标IP或域名`。常用参数包括`-I`(使用ICMP Echo请求,模拟ping)、`-T`(使用TCP SYN包,默认端口80,可穿透部分仅放行TCP的防火墙)以及`-n`(禁用DNS反向解析以加快输出)。执行后,终端会逐行打印每一跳的IP地址及三次探测的延迟值。排查时需重点关注三类现象:一是延迟突增,若某跳RTT从几毫秒骤升至数百毫秒且后续跳数维持高位,通常表明该节点或其上行链路存在拥塞;二是连续超时(显示为`* * *`),若仅单跳超时但后续跳数正常,多为该节点禁ping,若连续多跳超时且最终无法到达目标,则大概率是中间链路中断或路由黑洞;三是路径变化,多次执行发现跳数或IP频繁变动,说明网络存在动态路由调整或负载均衡,此时需结合业务实际受影响情况综合判断,避免将正常路由切换误认为故障。
用mtr持续验证:区分瞬时异常、持续丢包与真实故障
mtr(My Traceroute)融合了ping与traceroute的优势,能够持续发送探测包并实时汇总统计信息。基本用法为`mtr 目标地址`,运行后终端会动态刷新表格。核心字段包括:`Loss%`(丢包率)、`Snt`(已发包数)、`Last`/`Avg`/`Best`/`Wrst`(最近/平均/最佳/最差延迟)。通过持续观测(建议运行数分钟至数十分钟),可精准定位故障归属。若仅首跳(本地网关)出现高丢包或延迟抖动,问题通常出在本地局域网、网卡驱动或路由器负载;若中间某跳持续丢包且后续所有跳数同步恶化,说明该节点是真实瓶颈;若仅目标主机(最后一跳)丢包,则可能是目标服务器过载、安全组拦截或回程路由异常;若去程正常但业务仍不通,需警惕非对称路由导致的回程路径故障。mtr的连续采样机制能有效过滤瞬时网络抖动,帮助运维人员区分偶发波动与持续性链路劣化。
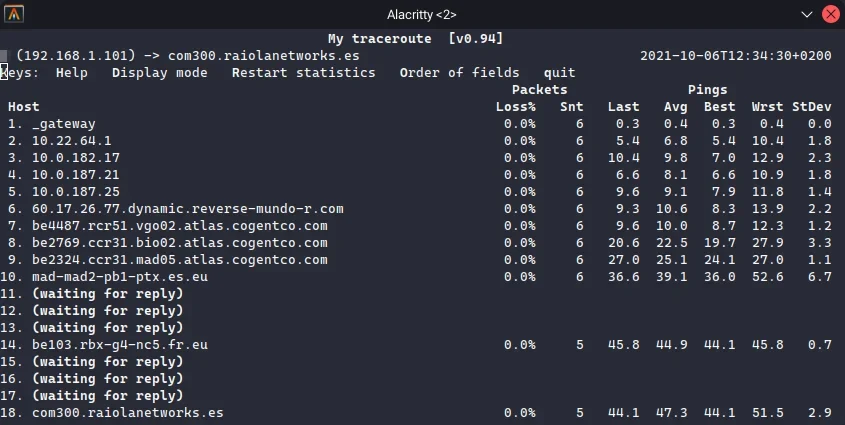
验证与避坑:结合多次测试确认结论
网络诊断结论必须经过多维度复测验证,切忌单次测试下定论。建议在业务低峰与高峰时段分别执行测试,对比延迟基线变化;同时更换多个目标地址(如不同运营商DNS、公共测速节点)以排除单点故障。协议维度上,应交替使用ICMP、UDP与TCP模式(如`mtr -T -P 443`),因为部分云厂商或企业防火墙会严格限速ICMP,导致UDP/TCP业务正常但探测显示高丢包。常见误判场景包括:一是节点不响应探测,需结合`tcping`或业务端口连通性交叉验证;二是负载均衡导致路径漂移,多次测试结果不一致属正常现象,应关注整体延迟分布而非单跳IP;三是IPv4与IPv6路由完全独立,IPv4通畅不代表IPv6正常,需分别使用`traceroute -4`与`traceroute -6`独立排查。只有综合多协议、多时段、多目标的交叉数据,才能得出可靠的排障结论。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















