


Python解决大文件多次循环读取与定时任务执行方案

本文针对Python中numpy.fromfile无法追加读取大文件的问题,提供了基于生成器的分块读取解决方案,支持自定义包头包尾处理。同时介绍了利用死循环结合time.sleep实现每隔固定时间执行函数的简单方法,适用于接口数据定时获取与入库场景。
Python大文件分块读取解决方案
在使用numpy时,np.fromfile函数存在一个限制:它只能一次性读取整个文件内容,不支持追加读取模式。这意味着连续调用两次np.fromfile读取同一个文件,得到的结果是完全相同的,无法实现流式或分段读取。
当面临的数据文件体积庞大(例如达到几个GB或更大)时,一次性将所有数据加载到内存中是不现实的,因此需要采用追加读取或分块读取的策略来处理数据。
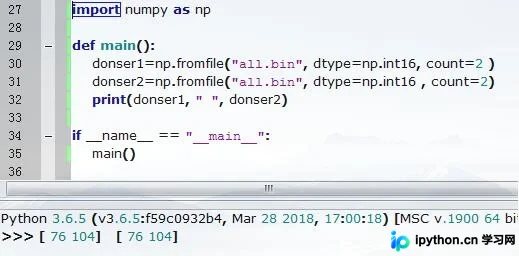
我们的目标是将读取到的数据分为donser1和donser2两部分,并确保这两部分在逻辑上是连续的数据段,以便后续处理。
在实际应用场景中,例如读取二进制数据文件,文件结构通常由“包头+数据”组成。我们需要将这两部分分离开来分别获取,然后再进行进一步的逻辑处理。
具体实现代码如下所示。
import numpy as np

length=2500
plt_arr=np.linspace(0.0, 0.0, length*2048*16)
start=0
tail_size = 40  #40bit
num_size=16*1024-40 # 16kb -40b


def one_file(f, loop):
  global tail_size, num_size
  while loop:
    num = np.fromfile(f, dtype=np.int16, count=num_size)
    tail=np.fromfile(f, dtype=np.int16, count=tail_size)
    loop=loop-1
    yield num, tail

def main():
  file_path="E://1-gl300c.r3f"
  global length, plt_arr, start
  loop=length
  with open(file_path, 'rb') as f:
    for num, tail in one_file(f, loop):
      plt_arr[start:start+len(num)]=num[:]
      start=start+len(num)
  return   plt_arr[0:start]

if __name__ == "__main__":
  donser=main()
  print(donser)
假设数据文件的格式为“数据部分+包尾”,我们需要将plt_arr用于存储全部的数据部分,而丢弃包尾。该方法实现了多次连续追加读取数据文件内容的功能。建议在使用plt_arr时,预先分配好大小再进行逐次赋值,因为亲测发现使用append方法和concatenate方法的时间效率极差,甚至不如不使用numpy。相关代码如下:
def read_in_chunks(filePath, chunk_size=16*1024):
  file_object = open(filePath,'rb')
  count=0
  while True:
    chunk_data = file_object.read(chunk_size)
    if not chunk_data:
      break
    yield chunk_data[0:16*1024-28]


if __name__ == "__main__":
  num=0
  for chunk in read_in_chunks("E:\\1-gl300c.r3f"):
    #process(chunk) # <do something with chunk>
    name=str(num)+".bin"
    num=num+1
    if num<303000:
      continue
    if num>308001:
      break
    file_object = open(name, 'wb')
    file_object.write(chunk)
    file_object.close( )
关于numpy.fromfile的其他使用方法,可以参考相关文档或示例。
Python定时任务执行实现
补充知识:如何在Python中实现每隔一段时间自动运行一个函数。
例如,使用Python语言每隔两分钟从接口获取一次数据,并将其插入到数据库中。
参考多位开发者的建议,感觉最简单且有效的实现方式如下:
构建一个死循环,让目标函数执行完毕后休眠两分钟,然后进入下一次执行。除非手动停止程序或遇到错误导致中断,否则该程序将永久运行下去。
具体代码实现如下:
import get_details
import time

second=2*60
print second
while True:
get_details.sign_cycle()
time.sleep(second)
上述代码实现了让get_details模块中的sign_cycle()函数每隔两分钟执行一次的功能。
这种方法是否非常简单直观?
以上关于Python numpy实现多次循环读取文件及等间隔过滤数据的示例,以及定时任务执行的方案,就是小编分享给大家的全部内容。希望能为大家提供参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















