


Python机器学习新手入门:学习路线与必备库推荐
针对Python机器学习初学者的实用指南。详细拆解四阶段系统学习路线,深入剖析NumPy、Pandas、Matplotlib与Scikit-learn的核心职责,并通过端到端可执行代码演示标准建模全流程。
Python 机器学习入门的关键,不在于过早推导繁琐的数学定理或强行生搬深度神经网络,而在于建立一条“数据清洗表达 → 经典算法拟合 → 泛化能力评估”的清晰实践闭环。掌握科学的学习阶段划分,并熟练运用以 NumPy、Pandas、Matplotlib/Seaborn 和 Scikit-learn 为代表的四个核心基础库,就能在两到三个月内扎实跑通结构化表格建模任务,为后续进阶奠定可靠的工程基石。
一、新手系统学习路线的四个阶段
初学者最容易遇到的阻碍是“学了许多孤立知识,却不知道如何拼装成一个能运行的模型”。合理的学习路线必须是递进式的,每一阶段都有明确的输入、实操重点与阶段性验收指标。
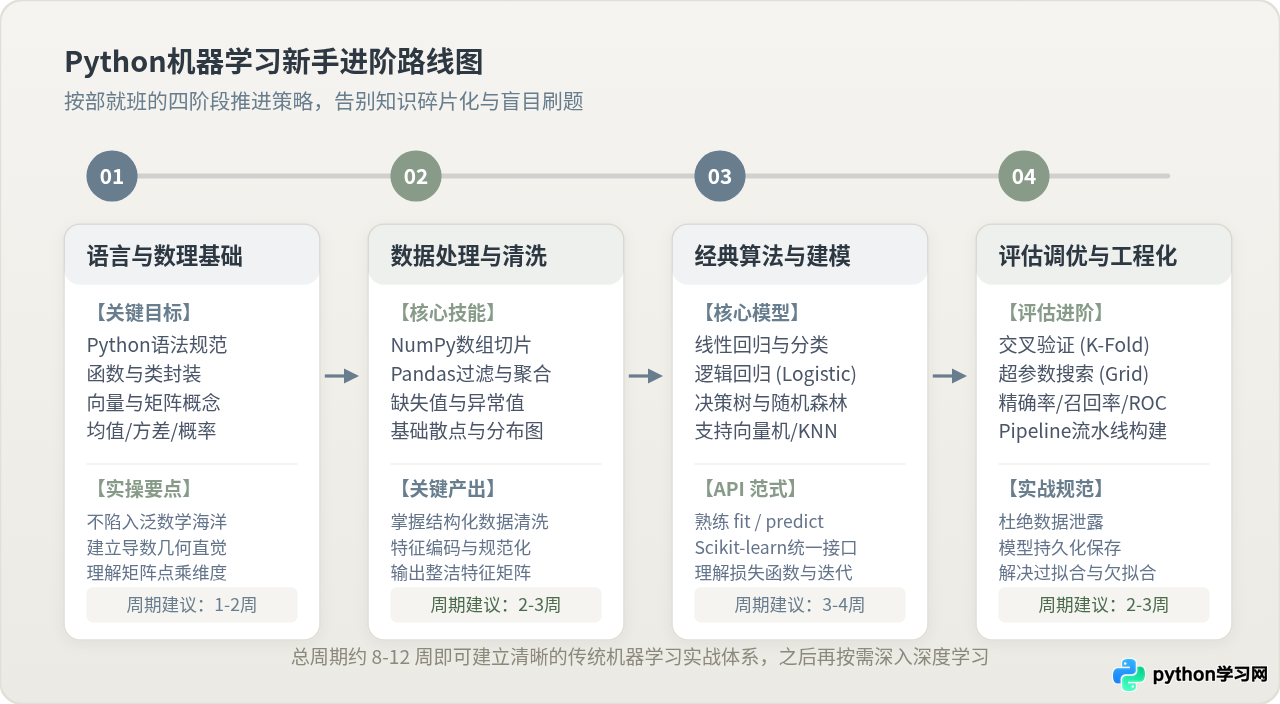
阶段一:Python 语法与核心数理准备(1-2 周)
在进入机器学习前,读者需要具备基础的 Python 编写能力,特别是列表推导式、字典操作、函数封装以及简单的面向对象类概念。
在数学准备方面,许多新手常陷入高等数学课本无法自拔。实际上,新手入门只需建立直觉理解即可:
- 线性代数:理解向量与矩阵的几何含义,掌握矩阵点乘的维度匹配规则(如形状
(M, K)与(K, N)点乘得到(M, N))。 - 微积分:无需手算多重积分,只需理解导数与梯度代表函数变化最快的方向即可,这是梯度下降算法寻找最优解的物理直觉。
- 概率与统计:掌握均值、方差、标准差、正态分布和条件概率的基本定义,了解不同特征尺度对算法的影响。
阶段二:数据探索与特征预处理(2-3 周)
真实世界的数据极少是现成整洁的。在这一阶段,重点是学会用代码检查数据结构、统计分布并排查瑕疵:
- 利用 NumPy 进行快速数组切片与掩码(Mask)布尔运算。
- 利用 Pandas 处理结构化表格,掌握缺失值填充(
fillna)、离群点过滤、数据分组聚合(groupby)与多表关联。 - 将类别型文本特征转化为数值形式(如独热编码 One-Hot Encoding 或标签编码 Label Encoding)。
阶段三:经典机器学习算法原理与实践(3-4 周)
直接在 Scikit-learn 框架下学习经典机器学习模型,重点是理解不同算法的适用场景和假设前提:
- 回归算法:线性回归(Linear Regression)、岭回归(Ridge)与 Lasso 回归。
- 分类算法:逻辑回归(Logistic Regression)、支持向量机(SVM)、K 近邻(KNN)与朴素贝叶斯。
- 树模型与集成学习:决策树(Decision Tree)、随机森林(Random Forest)与梯度提升树(GBDT)。树模型对特征缩放不敏感且处理非线性能力强,是目前工业界处理表格数据的核心主力。
阶段四:模型验证、超参数调优与工程规范(2-3 周)
能运行 model.fit() 仅仅完成了建模的一半。更关键的工作是验证模型在新样本上的泛化能力:
- 掌握 K 折交叉验证(K-Fold Cross Validation),避免单次划分偶然性。
- 使用网格搜索(
GridSearchCV)或随机搜索寻找最优超参数组合。 - 使用
Pipeline将预处理步骤和估算器串联,杜绝测试集统计信息向训练集泄露。
二、机器学习四大必备库推荐与分工解析
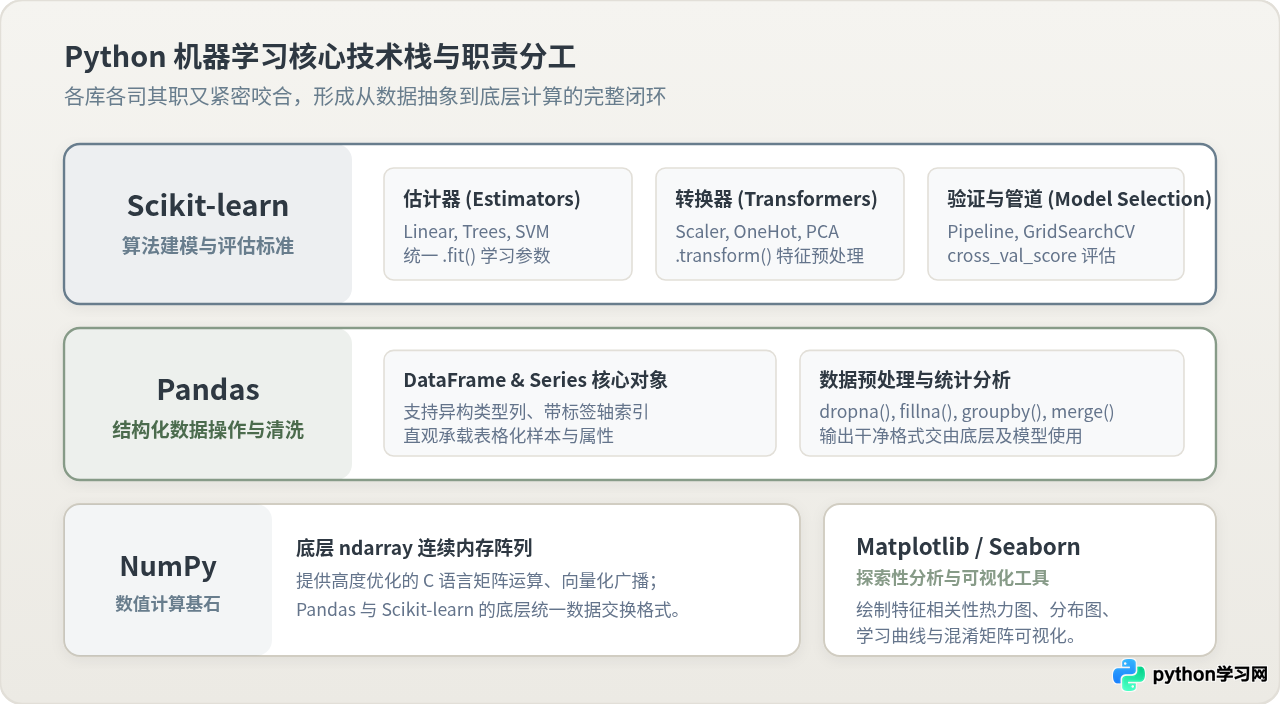
Python 生态之所以在机器学习领域占据统治地位,是因为其生态库形成了层层递进、接口统一的协作体系。新手不必四处搜集小众工具,掌握以下四个标准库即可覆盖 95% 以上的基础任务。
| 库名称 | 定位与核心职能 | 核心数据结构/接口 | 新手必备核心操作 |
|---|---|---|---|
| NumPy | 数值计算基石,底层 C 语言高效矩阵运算 | numpy.ndarray |
数组创建、广播机制、矩阵点乘 np.dot、统计函数 np.mean |
| Pandas | 表格化数据操作、数据清洗与特征提取 | DataFrame, Series |
read_csv, info(), describe(), dropna(), apply() |
| Matplotlib / Seaborn | 数据可视化、分布探索与指标评估图表 | Figure, Axes, 绘图函数 |
直方图 hist, 散点图 scatter, 相关性热力图 heatmap |
| Scikit-learn | 经典机器学习建模、特征转换与模型评估 | fit(), predict(), transform() |
标准化 StandardScaler, 划分 train_test_split, 评估报告 |
1. NumPy:不可替代的矩阵运算引擎
NumPy 提供的 ndarray 是一块连续的内存空间,其向量化运算比纯 Python 原生列表迭代快数十倍到上百倍。在机器学习算法底层,权重更新、内积计算和损失函数求和都是基于 NumPy 向量化操作完成的。
2. Pandas:连接现实业务与数值矩阵的桥梁
现实中的数据往往包含字段名、时间戳、缺失值与字符串分类标签。Pandas 能够直观地进行行列切片和清洗,清洗完毕后再将其转换为 NumPy 数组或者直接灌入 Scikit-learn 模型中。
3. Matplotlib 与 Seaborn:发现特征规律的眼睛
盲目训练模型往往无法定位问题。通过 Matplotlib 绘制特征分布,或使用 Seaborn 绘制多特征相关性热力图(Heatmap),可以帮助我们在建模前快速剔除无用特征、发现多重共线性并识别数据偏态。
4. Scikit-learn:工业级算法实现的标杆
Scikit-learn(简称 sklearn)拥有极其优雅和统一的 API 设计规范:
- 所有模型算法都是估计器(Estimator),统一通过
estimator.fit(X, y)学习参数; - 所有特征预处理工具都是转换器(Transformer),统一通过
transformer.fit_transform(X)转换数据; - 所有推理预测统一调用
estimator.predict(X_new)。这种高度一致的设计大幅降低了换用不同算法的学习成本。
三、关键差异剖析:传统规则编程 vs 机器学习
理解“为什么要用机器学习”以及“机器学习在什么时候会失效”,是新手跨越思维障碍的关键一步。
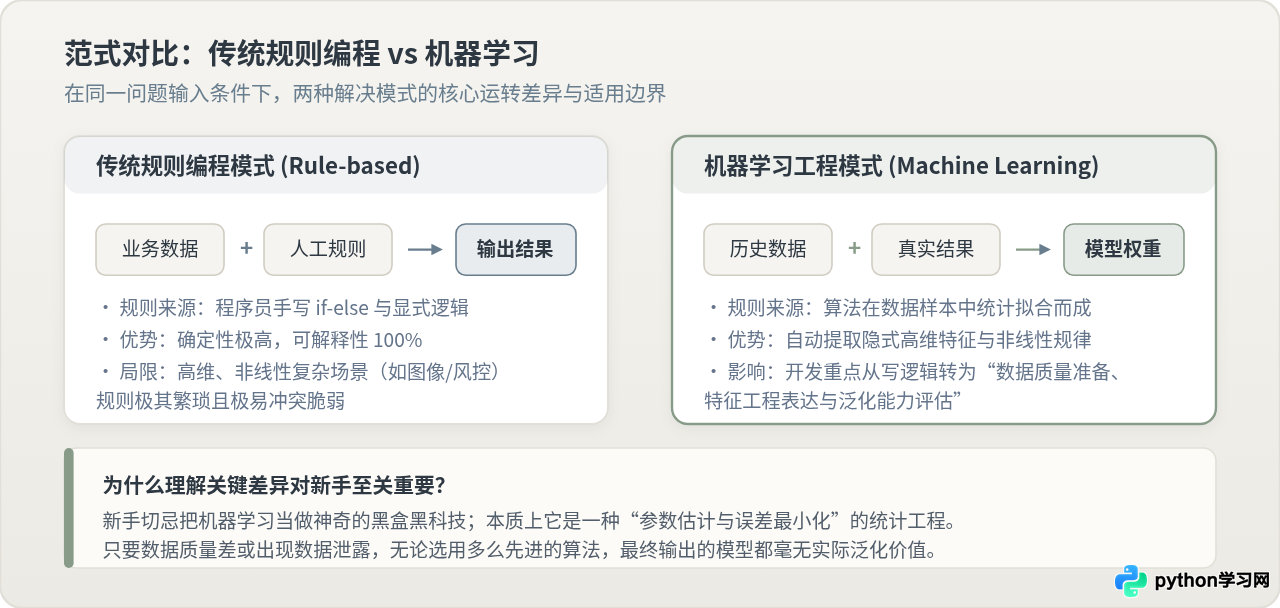
在同一问题背景下,这两种解决方式存在根本性的输入输出反转:
- 条件一致性对比:以“垃圾邮件过滤”为例。在传统编程中,工程师需要观察样本,人工归纳出“包含特定敏感词超过 3 次”、“发件人域名可疑”等一条条
if-else规则。当规则扩展到数百条时,规则之间就会出现逻辑互斥和维护灾难。 - 核心差异的影响:机器学习则完全不同。开发者提供已标注的大量正常邮件与垃圾邮件,由统计分类算法自动计算每个词项在不同类别下的权重比值。只要特征表达合理,算法可以在高维空间中自动绘制出决策分界面。
- 适用边界注意:这并不意味着机器学习总是优于传统编程。当业务逻辑是法律条款、税率计算等确定性 100% 的刚性规则时,传统编程是唯一正确的方案;只有当问题规则极其复杂、无法穷举规则,且拥有充足的历史样本数据时,机器学习才能发挥真正的威力。
四、端到端完整实战:从零构建二分类预测模型
下面通过一个完整的、可直接运行的代码示例,展示从数据读取、清洗切分、特征缩放到模型训练与评估的全部 6 个标准操作步骤。
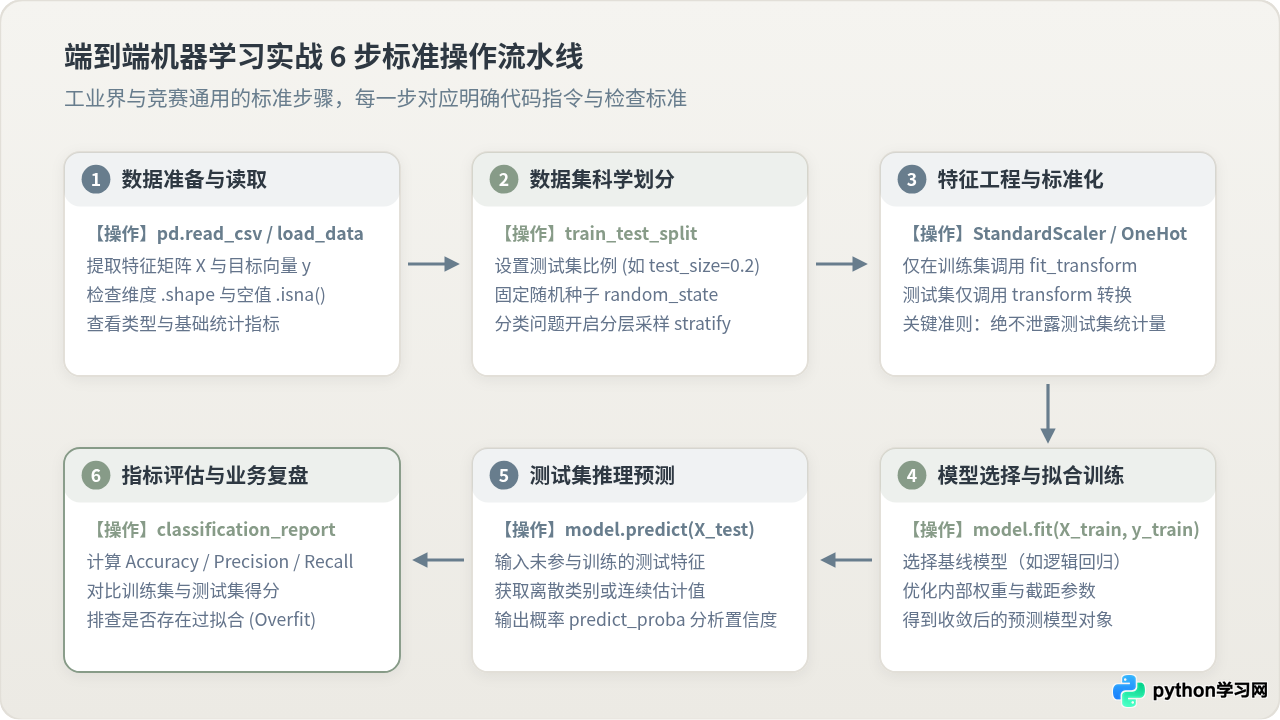
pip install numpy pandas matplotlib scikit-learn
# 导入标准库与必要组件
import numpy as np
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# 步骤 1:加载公开基准数据集(威斯康星州乳腺肿瘤诊断数据集)
raw_data = load_breast_cancer(as_frame=True)
df = raw_data.frame
print(f"原始数据维度: {df.shape}")

# 步骤 2:分离特征矩阵 X 与目标向量 y
X = df[raw_data.feature_names]
y = df['target']

# 步骤 3:科学划分训练集与测试集(80% 训练,20% 测试,启用分层抽样保持正负比例一致)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
print(f"训练集样本数: {X_train.shape[0]}, 测试集样本数: {X_test.shape[0]}")

# 步骤 4:特征标准化(关键:仅在训练集 fit,再对测试集 transform,严防数据泄露)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 步骤 5:模型初始化与拟合训练
model = LogisticRegression(max_iter=1000, random_state=42)
model.fit(X_train_scaled, y_train)

# 步骤 6:测试集推理预测与多维度指标评估
y_pred = model.predict(X_test_scaled)
acc = accuracy_score(y_test, y_pred)

print("-" * 50)
print(f"测试集准确率 (Accuracy): {acc:.4f}")
print("\n分类评估详细报告 (Classification Report):")
print(classification_report(y_test, y_pred, target_names=raw_data.target_names))
print("混淆矩阵 (Confusion Matrix):")
print(confusion_matrix(y_test, y_pred))原始数据维度: (569, 31)
训练集样本数: 455, 测试集样本数: 114
--------------------------------------------------
测试集准确率 (Accuracy): 0.9825
分类评估详细报告 (Classification Report):
precision recall f1-score support
malignant 0.98 0.98 0.98 42
benign 0.99 0.99 0.99 72
accuracy 0.98 114
macro avg 0.98 0.98 0.98 114
weighted avg 0.98 0.98 0.98 114
混淆矩阵 (Confusion Matrix):
[[41 1]
[ 1 71]]
在上述结果中,测试集 114 个未知样本中共有 112 个被正确识别(良性与恶性各失误 1 例),整体准确率达到 98.25%。更重要的是,分类报告中良性与恶性的 f1-score 均保持在 0.98 以上,证明模型在两类样本上性能表现均衡,没有出现偏倚。
五、新手四大高频误区与实操避坑指南
在机器学习实践中,很多新手往往将时间浪费在次要甚至错误的方向上。以下归纳了最常见的四个认知误区及正确的应对策略。
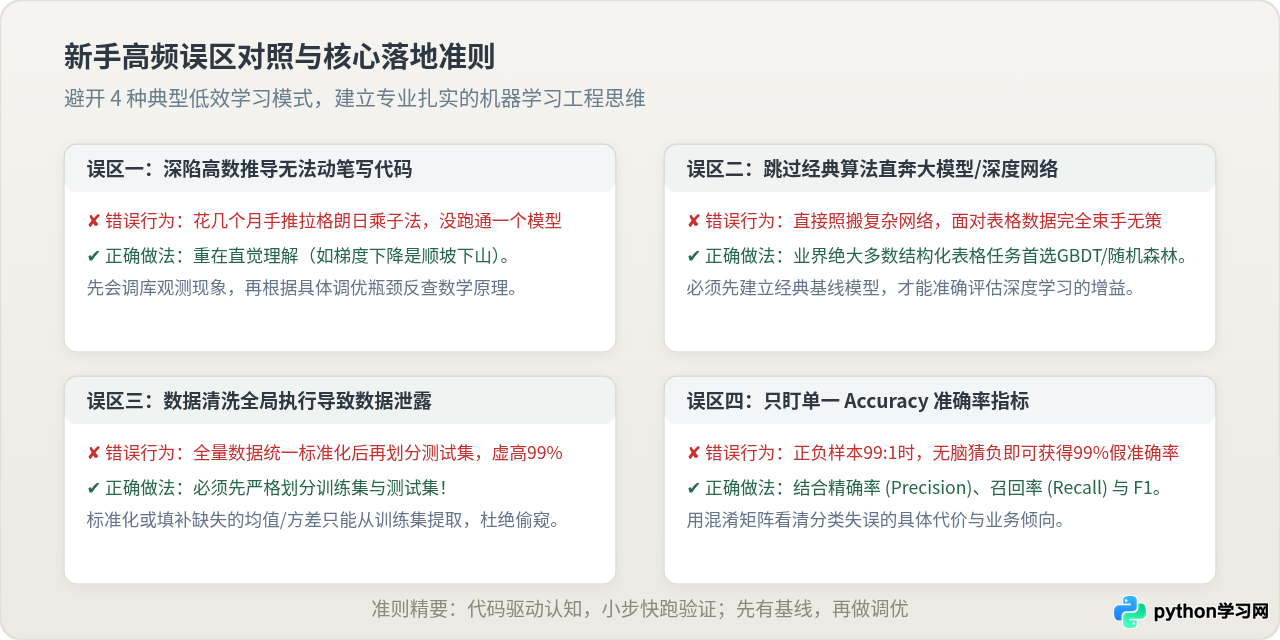
最典型的数据泄露是在执行标准化或缺失值填补时,直接对整个数据集
X 执行 StandardScaler().fit_transform(X),之后才调用 train_test_split。这种做法会导致测试集的均值和方差提前泄露给训练阶段,导致线下测试准确率虚高(例如达到 99%),但上线面对真实业务数据时效果急剧下跌。永远记住:一切统计参数只能从训练集学习!
- 避免死啃数学不写代码:理解公式的本质是为了指导算法选型与调参。遇到公式卡住时,直接写代码打印中间矩阵的
.shape,观察损失值随迭代轮数的变化曲线,具象直观的反馈远比干看课本更有效。 - 树立基线(Baseline)意识:不要一接到任务就直接搭建复杂的多层神经网络。在结构化表格场景中,先跑一个逻辑回归或轻量随机森林作为基准模型;若复杂模型带来的收益提升只有 0.5%,其带来的推理延迟和部署成本往往得不偿失。
- 警惕单一准确率指标:在严重失衡的数据集(如欺诈交易仅占 0.1%)中,一个全猜“正常”的模型准确率可高达 99.9%,但这个模型完全无法识别任何欺诈,属于无效模型。必须养成结合混淆矩阵、精确率(Precision)与召回率(Recall)综合判定的习惯。
六、总结与下一步建议
掌握 Python 机器学习并不需要一蹴而就的算法推导神技,而是一个从基础数据结构操作走向规范工程实践的渐进过程。
读者在完成本文的四阶段进阶路线和四大核心库基础学习后,建议在公开开源数据集(如 Kaggle Titanic 经典生存预测、House Prices 房价回归)上亲手编写两到三个端到端项目。通过亲身经历数据清洗中的脏数据洗礼、解决模型过拟合,逐步形成条件反射般的建模思维。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















