


详解pandas绘制矩阵散点图(scatter_matrix)的方法

本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
scatter_matrix函数功能概述
利用散点图矩阵,我们可以直观地观察数据集中各个特征两两之间的关联与分布情况。
pd.plotting.scatter_matrix(frame, alpha=0.5, c,figsize=None, ax=None, diagonal='hist', marker='.', density_kwds=None,hist_kwds=None, range_padding=0.05, **kwds)核心参数详解
该函数支持以下主要参数: 1、frame:传入pandas DataFrame对象。 2、alpha:控制图像透明度,取值范围通常为(0,1]。 3、figsize:设定图像尺寸,单位为英寸,以(width, height)元组形式指定。 4、ax:可选参数,通常设为None。 5、diagonal:关键参数,必须在'hist'(直方图)和'kde'(核密度估计)中二选一,用于绘制对角线上的分布图。 6、marker:指定Matplotlib支持的标记样式,如'.'、','、'o'等。 7、density_kwds:可选字典,用于传递与kde相关的额外绘图参数。 8、hist_kwds:可选字典,用于传递与hist相关的额外绘图参数。 9、range_padding:浮点数,可选,设置x轴和y轴原点附近的留白距离,值越大图像离原点越远。 10、kwds:字典,用于传递与scatter_matrix函数本身相关的其他参数。 11、c:指定颜色。
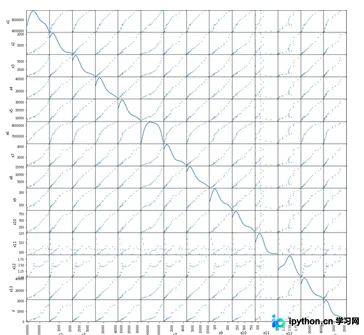
生成的图形效果如下所示。
基于iris数据集的实战演示
本例选用sklearn库中的iris(鸢尾花)数据集作为测试数据。
import matplotlib.pyplot as plt
from scipy import sparse
import numpy as np
import matplotlib as mt
import pandas as pd
from IPython.display import display
from sklearn.datasets import load_iris
import sklearn as sk
from sklearn.model_selection import train_test_split

iris=load_iris()
#print(iris)
X_train,X_test,y_train,y_test = train_test_split(iris['data'],iris['target'],random_state=0)
iris_dataframe = pd.DataFrame(X_train,columns=iris.feature_names)
grr = pd.plotting.scatter_matrix(iris_dataframe,c=y_train,figsize=(15,15),marker='o',hist_kwds={'bins':20},s=60,alpha=.8)
plt.show()
至此,关于pandas绘制矩阵散点图(scatter_matrix)的详细方法介绍完毕。如需了解更多相关技巧,可查阅本站往期文章或继续浏览后续内容。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















