


Python使用Requests库获取网页源码的完整指南

发布时间:2026-10-14 |
5人浏览过
本文详细介绍如何使用Python的requests库查看网页源代码。通过导入requests模块,利用get()函数发送HTTP请求获取指定URL的HTML内容,并设置编码为utf-8后打印输出。文章包含完整代码示例及运行结果分析,适合初学者快速掌握网页数据抓取的基本方法。
Python查看网页代码的基本方法
在Python中查看网页源代码,主要依赖于网络请求库。
首先,需要在代码中导入模块,这是进行HTTP请求的基础。
代码实现与结果分析
import requests接着,调用库提供的方法,传入目标网页的URL链接。该函数会向服务器发送GET请求并返回响应对象。获取到响应后,可以通过语句将响应中的文本内容(即网页源码)打印到控制台,从而完成查看操作。
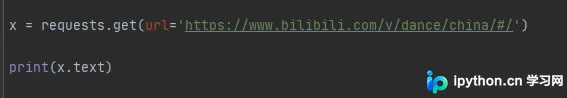
执行上述代码后,控制台将输出目标网页的完整HTML结构,具体输出内容取决于所请求的网页地址。
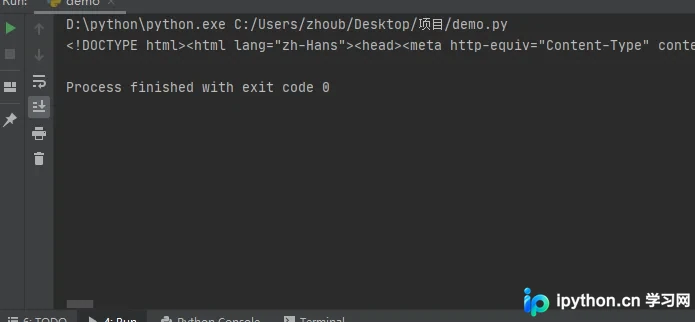
为了更深入地理解,下面提供一段完整的代码扩展示例。
以下是使用Python获取网页HTML代码的标准实现方式。
具体实现步骤如下:
import requests
res = requests.get('https://www.jb51.net/更换成你的网页.html')
res.encoding = 'utf-8'
print(res.text)
运行上述代码后,终端会显示网页的原始HTML文本。
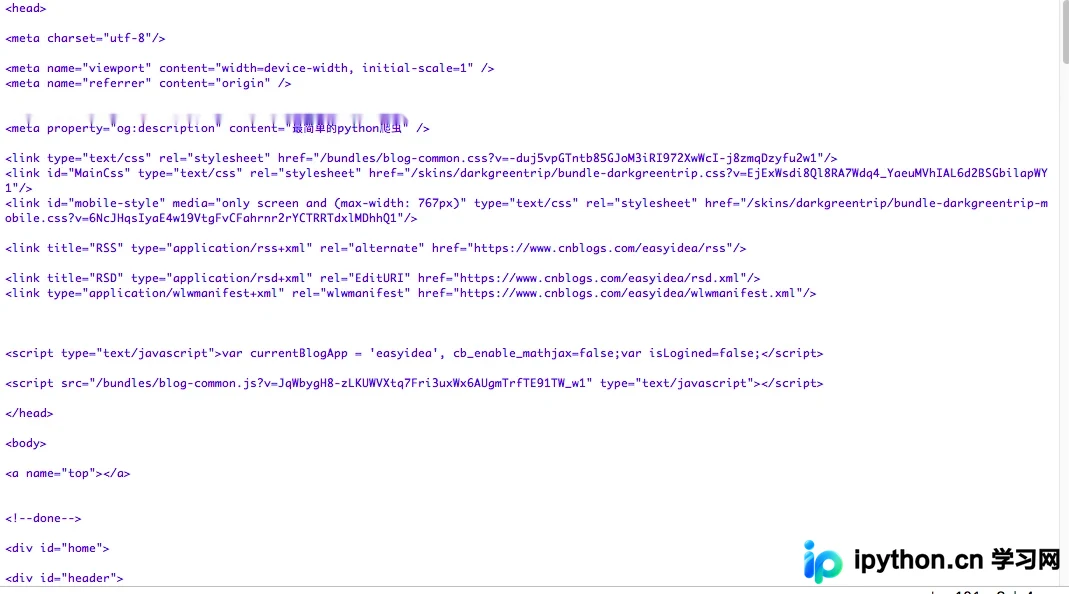
以上就是通过Python查看网页代码的完整流程。如需了解更多关于Python网络请求或网页抓取的高级技巧,建议查阅本站相关历史文章或继续探索后续内容。感谢阅读与支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















