


利用sklearn实现多分类任务中各类别的指标评估与可视化

本文介绍如何使用Python的sklearn库对多分类模型进行细粒度评估。通过classification_report获取每个类别的精确率、召回率和F1值,支持以字典格式输出以便程序处理。同时演示如何生成并可视化混淆矩阵,帮助开发者直观分析模型在各类别上的表现及误分类情况。
多分类指标评估需求与方案概述
近期接到一项客户需求,要求对多分类预测结果中的每一个类别分别进行性能评估,具体需要输出每个类别的精确率(precision)、召回率(recall)以及F1分数(F1-score)。
针对这一需求,利用sklearn库可以高效解决。该实现方案并不复杂,本文在此记录具体操作步骤,供后续查阅及读者参考。
首先构建模拟数据集,用于演示评估流程。
y_true = ['北京', '上海', '成都', '成都', '上海', '北京', '上海', '成都', '北京', '上海'] y_pred = ['北京', '上海', '成都', '上海', '成都', '成都', '上海', '成都', '北京', '上海']
其中,y_true代表真实标签,y_pred为多分类模型输出的预测结果。借助sklearn.metrics模块中的classification_report函数,即可实现对多分类各单独类别的性能指标评估。
使用classification_report获取各类别指标
具体的Python实现代码如下:
# -*- coding: utf-8 -*-
from sklearn.metrics import classification_report

y_true = ['北京', '上海', '成都', '成都', '上海', '北京', '上海', '成都', '北京', '上海']
y_pred = ['北京', '上海', '成都', '上海', '成都', '成都', '上海', '成都', '北京', '上海']

t = classification_report(y_true, y_pred, target_names=['北京', '上海', '成都'])

print(t)
执行上述代码后,控制台将输出如下结果:
       precision  recall f1-score  support

     北京    0.75   0.75   0.75     4
     上海    1.00   0.67   0.80     3
     成都    0.50   0.67   0.57     3

  accuracy              0.70    10
  macro avg    0.75   0.69   0.71    10
weighted avg    0.75   0.70   0.71    10
需注意,默认情况下classification_report的输出类型为字符串。若需在后续代码中直接调用这些指标数据,可将output_dict参数设置为True,此时返回结构如下:
{‘北京': {‘precision': 0.75, ‘recall': 0.75, ‘f1-score': 0.75, ‘support': 4},
‘上海': {‘precision': 1.0, ‘recall': 0.6666666666666666, ‘f1-score': 0.8, ‘support': 3},
‘成都': {‘precision': 0.5, ‘recall': 0.6666666666666666, ‘f1-score': 0.5714285714285715, ‘support': 3},
‘accuracy': 0.7,
‘macro avg': {‘precision': 0.75, ‘recall': 0.6944444444444443, ‘f1-score': 0.7071428571428572, ‘support': 10},
‘weighted avg': {‘precision': 0.75, ‘recall': 0.7, ‘f1-score': 0.7114285714285715, ‘support': 10}}
生成与可视化混淆矩阵
此外,使用confusion_matrix函数可以获取该多分类问题的混淆矩阵,相关代码如下:
from sklearn.metrics import confusion_matrix
y_true = ['北京', '上海', '成都', '成都', '上海', '北京', '上海', '成都', '北京', '上海']
y_pred = ['北京', '上海', '成都', '上海', '成都', '成都', '上海', '成都', '北京', '上海']
print(confusion_matrix(y_true, y_pred, labels = ['北京', '上海', '成都']))
运行上述代码后,输出结果如下:
[[2 0 1]
 [0 3 1]
 [0 1 2]]
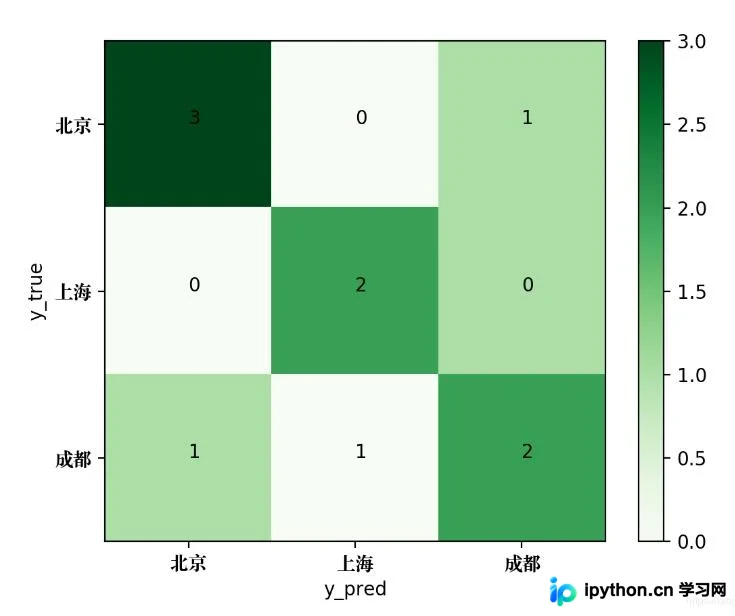
为了更直观地展示混淆矩阵,可以使用以下Python代码将其绘制为图像:
# -*- coding: utf-8 -*-
# author: Jclian91
# place: Daxing Beijing
# time: 2019-11-14 21:52

from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import matplotlib as mpl

# 支持中文字体显示, 使用于Mac系统
zhfont=mpl.font_manager.FontProperties(fname="/Library/Fonts/Songti.ttc")

y_true = ['北京', '上海', '成都', '成都', '上海', '北京', '上海', '成都', '北京', '上海']
y_pred = ['北京', '上海', '成都', '上海', '成都', '成都', '上海', '成都', '北京', '上海']

classes = ['北京', '上海', '成都']
confusion = confusion_matrix(y_true, y_pred)

# 绘制热度图
plt.imshow(confusion, cmap=plt.cm.Greens)
indices = range(len(confusion))
plt.xticks(indices, classes, fontproperties=zhfont)
plt.yticks(indices, classes, fontproperties=zhfont)
plt.colorbar()
plt.xlabel('y_pred')
plt.ylabel('y_true')

# 显示数据
for first_index in range(len(confusion)):
  for second_index in range(len(confusion[first_index])):
    plt.text(first_index, second_index, confusion[first_index][second_index])

# 显示图片
plt.show()
生成的混淆矩阵可视化图片如下:
XGBoost在二分类与多分类中的应用补充
补充知识:基于Python Sklearn实现XGBoost的二分类与多分类任务。
针对二分类场景:
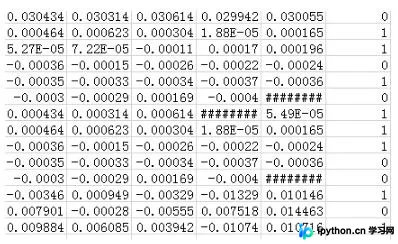
训练数据train2.txt的格式示例如下:
import numpy as np
import pandas as pd
import sklearn
from sklearn.cross_validation import train_test_split,cross_val_score
from xgboost.sklearn import XGBClassifier
from sklearn.metrics import precision_score,roc_auc_score

min_max_scaler = sklearn.preprocessing.MinMaxScaler(feature_range=(-1,1))
resultX = []
resultY = []
with open("./train_data/train2.txt",'r') as rf:
  train_lines = rf.readlines()
  for train_line in train_lines:
    train_line_temp = train_line.split(",")
    train_line_temp = map(float, train_line_temp)
    line_x = train_line_temp[1:-1]
    line_y = train_line_temp[-1]
    resultX.append(line_x)
    resultY.append(line_y)

X = np.array(resultX)
Y = np.array(resultY)
X = min_max_scaler.fit_transform(X)
X_train,X_test, Y_train, Y_test = train_test_split(X,Y,test_size=0.3)

xgbc = XGBClassifier()
xgbc.fit(X_train,Y_train)
pre_test = xgbc.predict(X_test)

auc_score = roc_auc_score(Y_test,pre_test)
pre_score = precision_score(Y_test,pre_test)

print("xgb_auc_score:",auc_score)
print("xgb_pre_score:",pre_score)
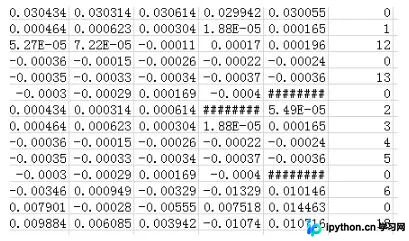
针对多分类场景:假设存在19种分类,其中正常状态标记为0,异常状态标记为1至18。数据格式示例如下:
# -*- coding:utf-8 -*-
from sklearn import datasets
from sklearn.multiclass import OneVsRestClassifier
from sklearn.svm import LinearSVC
from sklearn.cross_validation import train_test_split,cross_val_score
from sklearn.svm import SVC
from sklearn.linear_model import LogisticRegression
from xgboost.sklearn import XGBClassifier
import sklearn
import numpy as np
from sklearn.preprocessing import OneHotEncoder
from sklearn.metrics import precision_score,roc_auc_score
min_max_scaler = sklearn.preprocessing.MinMaxScaler(feature_range=(-1,1))

resultX = []
resultY = []
with open("../train_data/train_multi_class.txt",'r') as rf:
  train_lines = rf.readlines()
  for train_line in train_lines:
    train_line_temp = train_line.split(",")
    train_line_temp = map(float, train_line_temp) # 转化为浮点数
    line_x = train_line_temp[1:-1]
    line_y = train_line_temp[-1]
    resultX.append(line_x)
    resultY.append(line_y)

X = np.array(resultX)
Y = np.array(resultY)

#fit_transform(partData)对部分数据先拟合fit,找到该part的整体指标,如均值、方差、最大值最小值等等(根据具体转换的目的),然后对该partData进行转换transform,从而实现数据的标准化、归一化等等。。
X = min_max_scaler.fit_transform(X)
#通过OneHotEncoder函数将Y值离散化成19维,例如3离散成000000···100

Y = OneHotEncoder(sparse = False).fit_transform(Y.reshape(-1,1))
X_train,X_test, Y_train, Y_test = train_test_split(X,Y,test_size=0.2)

model = OneVsRestClassifier(XGBClassifier(),n_jobs=2)
clf = model.fit(X_train, Y_train)

pre_Y = clf.predict(X_test)
test_auc2 = roc_auc_score(Y_test,pre_Y)#验证集上的auc值
print ("xgb_muliclass_auc:",test_auc2)
以上内容分享了使用sklearn进行多分类类别指标评估的方法,希望能为读者提供有价值的参考,欢迎支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















