


Python爬取梨视频生活板块最热视频实战解析

发布时间:2026-10-14 |
3人浏览过
本文详细介绍如何使用Python爬取梨视频生活板块的最热视频。通过解析Ajax请求获取视频伪URL,并针对其加密机制进行URL替换处理,最终利用多线程技术实现视频的高效批量下载。
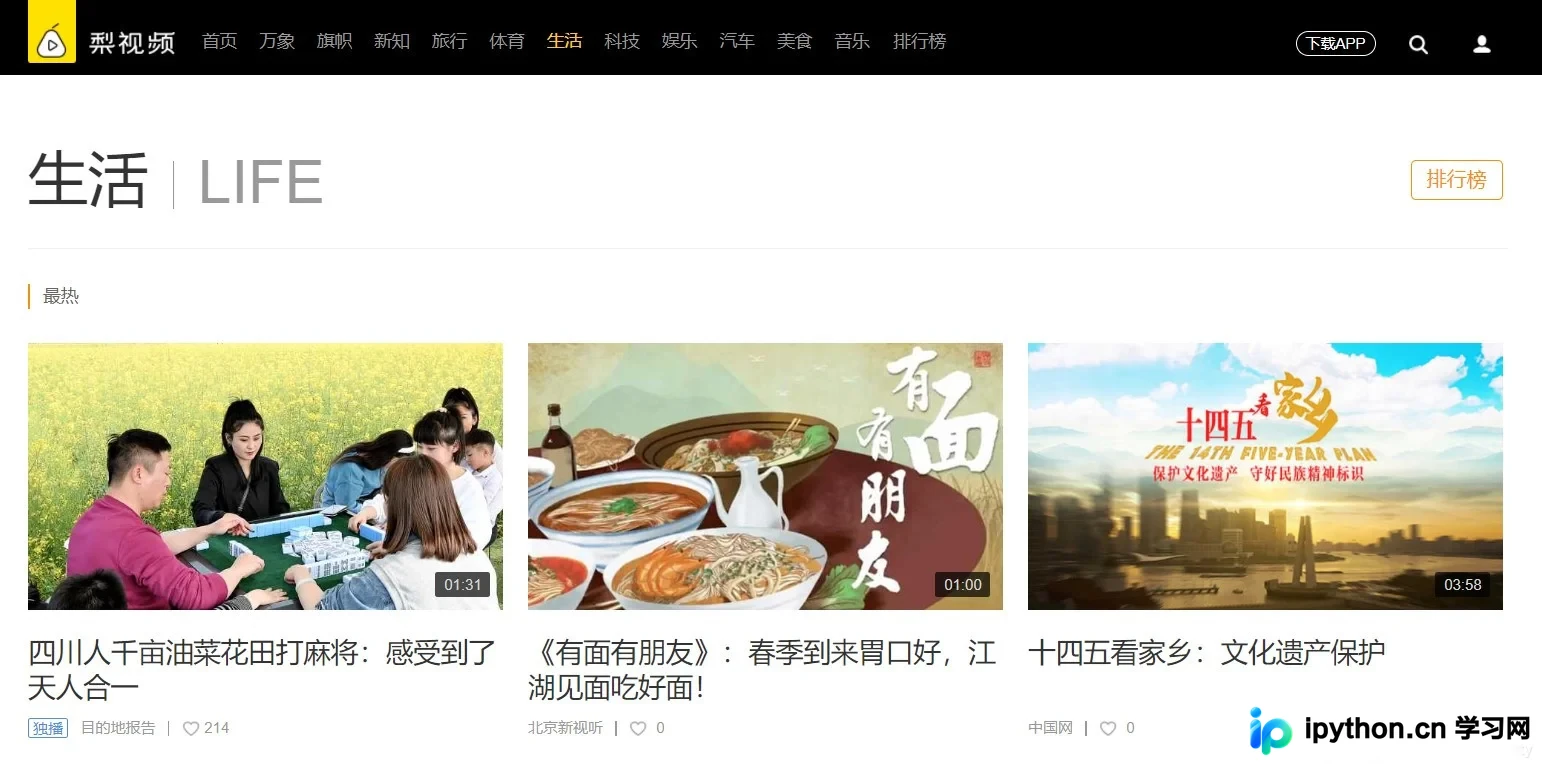
Python爬取梨视频生活板块最热视频实战解析
以下是完整的代码实现:
完整代码实现
import requests
from lxml import etree
import random
import os
from multiprocessing.dummy import Pool


if not os.path.exists('./视频'):
  os.mkdir('./视频')

urls=[]
url='https://www.pearvideo.com/category_5'
headers={'user-agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.72 Safari/537.36 Edg/89.0.774.45'}

page_text=requests.get(url=url,headers=headers).text
tree=etree.HTML(page_text)

li_list=tree.xpath('//ul[@id="listvideoListUl"]/li')

for li in li_list:
  a_url='https://www.pearvideo.com/'+li.xpath('./div/a/@href')[0]
  name=li.xpath('./div/a/div[2]/text()')[0]+'.mp4'

  mrd=random.random()
  code=li.xpath('./div/a/@href')[0][-7:]
  new_headers={'Referer': a_url,
         'user-agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.82 Safari/537.36 Edg/89.0.774.50'
         }
  new_url='https://www.pearvideo.com/videoStatus.jsp?contId='+str(code)+'&mrd='+str(mrd)

  r=requests.get(url=new_url,headers=new_headers)
  video_url=eval(r.text)['videoInfo']['videos']['srcUrl']


  old=video_url.split('/')[-1].split('-')[0]
  new='cont-'+str(code)
  true_video_url=video_url.replace(old,new)


  dic={'name':name,
     'my_url':true_video_url}
  urls.append(dic)


#使用线程池对数据视频进行请求
def get_video_data(dic):
  print(dic['name']+'开始下载'+'\n')
  data_url=dic['my_url']
  data=requests.get(url=data_url,headers=headers).content
  with open('./视频/'+dic['name'],'wb') as f:
    f.write(data)
    print(dic['name']+'下载成功')

pool=Pool(4)
pool.map(get_video_data,urls)

pool.close()
pool.join()
代码说明如下:
在2021年3月14日这个时间节点,梨视频的视频临时访问链接(伪URL)是通过Ajax接口动态获取的。
对部分关键代码段进行解释:
1. 导入所需模块
模块导入与初始化
import requests                #网路爬虫标准库(代替urllib)
from lxml import etree            #用于解析页面信息
import random                 #梨视频的url中有一段需要随机数
import os                   #主要用于生成文件夹存放视频
from multiprocessing.dummy import Pool    #导入线程池对应类
2. 获取视频的临时访问链接
获取视频临时链接
#参数准备
mrd=random.random()
code=li.xpath('./div/a/@href')[0][-7:]
new_headers={
'Referer': a_url,
'user-agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36     (KHTML, like Gecko) Chrome/89.0.4389.82 Safari/537.36 Edg/89.0.774.50'
      }

#获取url
new_url='https://www.pearvideo.com/videoStatus.jsp?contId='+str(code)+'&mrd='+str(mrd)
r=requests.get(url=new_url,headers=new_headers)
video_url=eval(r.text)['videoInfo']['videos']['srcUrl']
3. 解析并获取真实视频地址
经过实际测试,直接使用上述方法获取的链接下载视频,得到的文件内容为空。
由于作者当时经验有限,对此感到困惑。后来在B站用户“_千户”的留言中才了解到伪链接与真实链接的区别:
视频地址经过加密处理,Ajax接口返回的地址需要添加“cont-”前缀,并将其中一段数字替换为具体的内容ID,才能构成真实的下载地址。 真实地址示例:"https://video.pearvideo.com/mp4/third/20201120/cont-1708144-10305425-222728-hd.mp4" 临时地址示例:"https://video.pearvideo.com/mp4/third/20201120/1606132035863-10305425-222728-hd.mp4"
解析真实视频地址
#仅需要做几个简单的截取切片操作就可以替换相关内容

old=video_url.split('/')[-1].split('-')[0]
new='cont-'+str(code)
true_video_url=video_url.replace(old,new)
4. 视频存储逻辑
多线程下载与存储
#使用线程池对数据视频进行请求
def get_video_data(dic):
  print(dic['name']+'开始下载'+'\n')
  data_url=dic['my_url']
  data=requests.get(url=data_url,headers=headers).content
  with open('./视频/'+dic['name'],'wb') as f:
    f.write(data)
    print(dic['name']+'下载成功')

pool=Pool(4)
pool.map(get_video_data,urls)

pool.close()
pool.join()
5. 运行结果展示
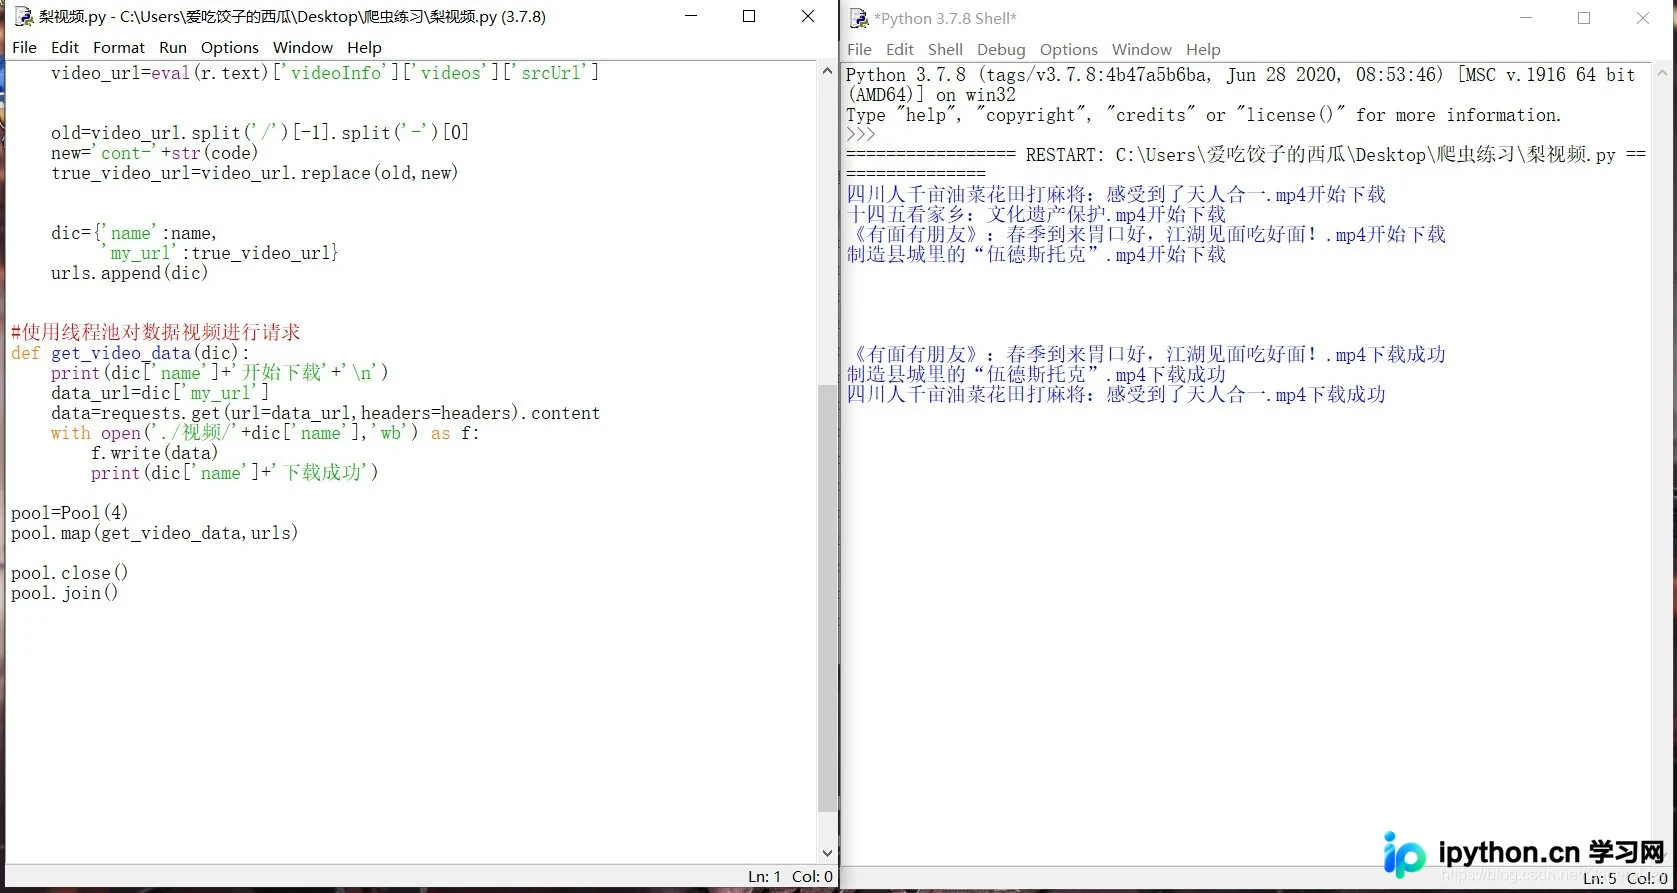
至此,关于使用Python爬取梨视频生活板块最热视频的教程介绍完毕。如需了解更多Python爬虫相关内容,欢迎查阅本站往期文章或继续浏览后续内容,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















