


Python多线程爬虫实战:高效抓取小米应用商店数据

本文详解如何利用Python多线程技术高效抓取小米应用商店数据。通过分析动态加载接口,使用requests、threading和queue库构建爬虫,实现聊天社交类应用名称与链接的快速批量获取,并展示控制台输出结果及执行时间统计。
本文内容仅供学习与技术交流使用,不涉及任何商业用途。若发现任何问题,请及时联系处理。
本文来源:IT共享之家,作者:IT共享者
前言
小米应用商店致力于为用户提供安全可靠的安卓应用和游戏发现服务。然而,手动逐个搜索下载不仅操作繁琐,且效率较低。
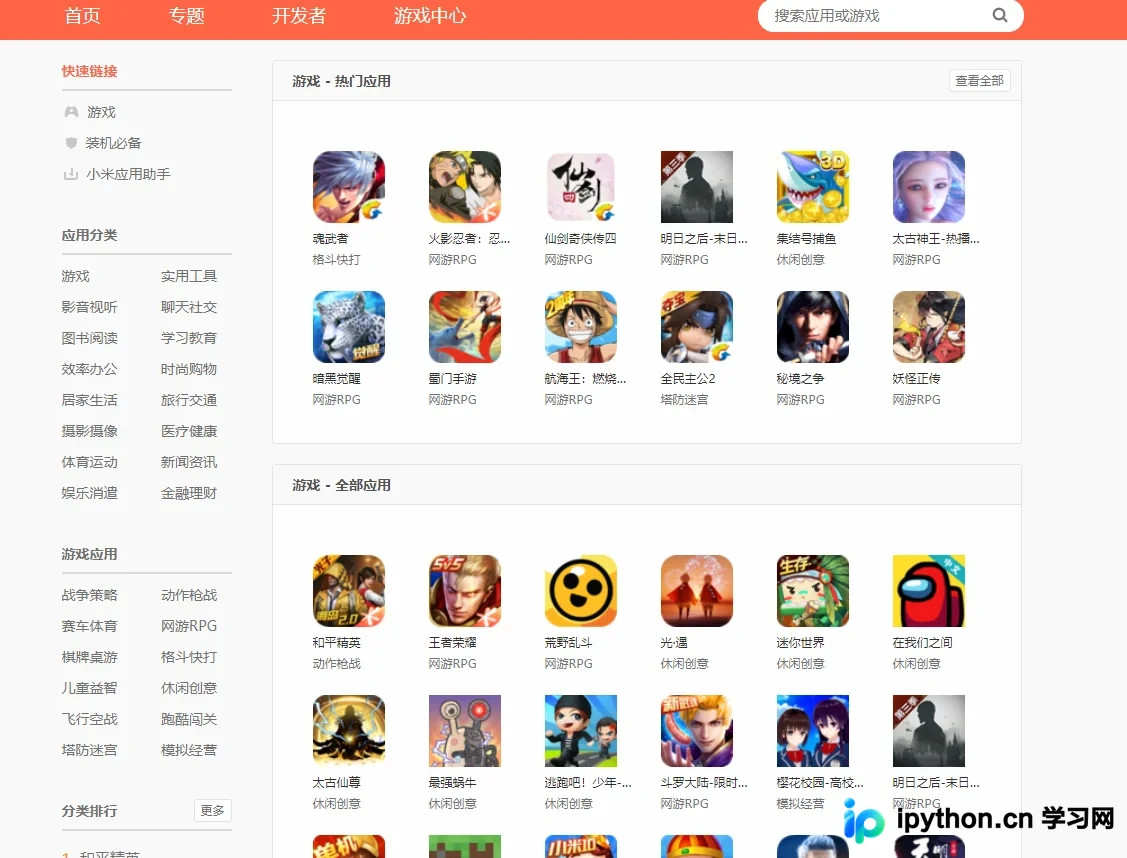
本文将演示如何利用多线程技术爬取小米应用商店的游戏模块,以实现快速批量获取数据。
二、项目目标
目标:针对应用分类中的“聊天社交”类别,批量获取应用名称及其下载链接,并在控制台输出供用户直接使用。
三、涉及的库和网站
1、目标网址:通过百度搜索“小米应用商店”进入官方网站。
2、核心库:requests、threading、queue、json、time。
3、开发工具:PyCharm。
四、项目分析
1、判断页面加载方式。
通过局部刷新机制及右键查看网页源代码,发现搜索关键字未在源码中出现,由此判定该网站为动态加载页面,需通过抓取网络数据包进行分析。
2、使用Chrome浏览器,按下F12打开开发者工具抓取网络数据包。
1)获取返回JSON数据的URL地址(查看Headers中的Request URL)。
http://app.mi.com/categotyAllListApi?page={}&categoryId=2&pageSize=30
2)查看并分析查询参数(查看Headers中的Query String Parameters)。
page: 1
categoryId: 2
pageSize: 30
分析发现仅page参数发生变化(取值为0, 1, 2, 3...),因此可通过控制page参数拼接多个返回JSON数据的URL地址。
五、项目实施
1、定义一个继承object的class类,编写__init__方法初始化self,并定义main函数。准备导入所需库、url地址及请求头headers。
import requests
from threading import Thread
from queue import Queue
import json
import time
class XiaomiSpider(object):
def __init__(self):
   self.headers = {'User-Agent':'Mozilla/5.0'}
   self.url = 'http://app.mi.com/categotyAllListApi?page={}&categoryId=15&pageSize=30'
def main(self):
pass
if __name__ == '__main__':
  imageSpider = XiaomiSpider()
  imageSpider.main()
2、定义队列,用于存放待抓取的URL地址。
self.url_queue = Queue()
3、将生成的URL地址放入队列。
def url_in(self):
# 拼接多个URL地址,然后put()到队列中
for i in range(67):
self.url.format((str(i)))
self.url_queue.put(self.url)
4、定义线程事件函数get_page,用于请求数据。
defget_page(self):
# 先get()URL地址,发请求
while True:
# 当队列不为空时,获取url地址
if not self.url_queue.empty():
      url = self.url_queue.get()
      html = requests.get(url,headers=self.headers).text
self.parse_page(html)
else:
break
5、定义函数parse_page,解析JSON模块,提取应用名称和应用链接内容。
# 解析函数
def parse_page(self,html):
  app_json = json.loads(html)
for app in app_json['data']:
# 应用名称
    name = app['displayName']
# 应用链接
    link = 'http://app.mi.com/details?id={}'.format(app['packageName'])
    d = { '名称' : name,'链接' : link }
    print(d)
6、在main方法中,定义t_list = []用于存放所有线程对象。调用get_page实现多线程爬取。
def main(self):
self.url_in()
# 存放所有线程的列表
  t_list = []
for i in range(10):
    t = Thread(target=self.get_page)
    t.start()
    t_list.append(t)
7、使用for循环遍历线程列表,统一回收线程。
# 统一回收线程for p in t_list: p.join()
8、统计并输出程序执行时间。
start = time.time()
spider = XiaomiSpider()
spider.main()
end = time.time()
print('执行时间:%.2f' % (end-start))
六、效果展示
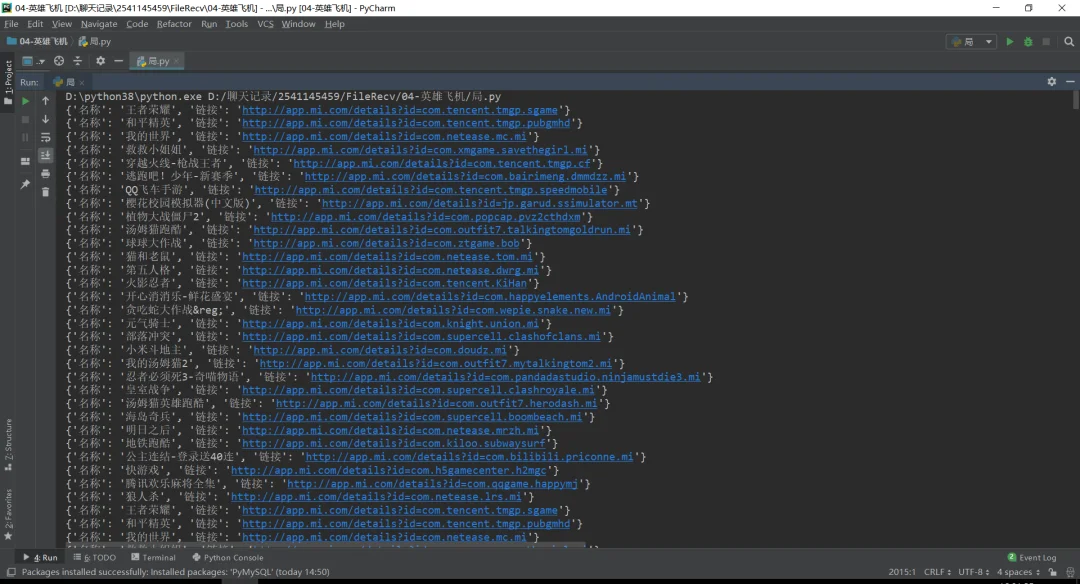
1、运行程序。点击运行后,控制台将显示游戏名称、下载链接及执行时间。
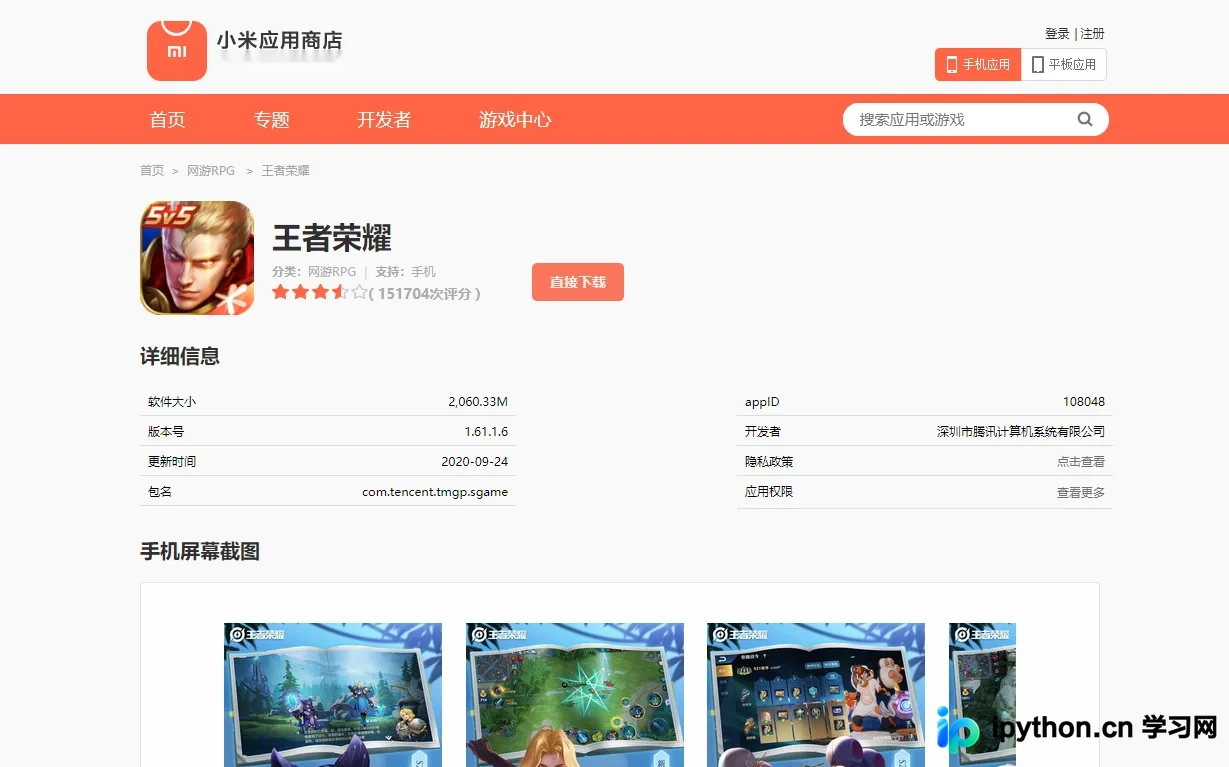
2、点击蓝色的网址可直接跳转至下载页面下载应用,如下图所示。
到此这篇关于Python爬虫过程解析之多线程获取小米应用商店数据的文章就介绍到这了,更多相关Python多线程获取小米应用商店数据内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















