


Python爬虫基于lxml解决数据编码乱码问题

在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
lxml与XPath基础介绍
lxml是Python中一个高效的解析库,支持HTML和XML格式的解析,并兼容XPath查询方式,其解析速度表现优异。
XPath全称为XML Path Language(XML路径语言),是一种用于在XML文档中检索信息的语言。虽然它最初设计用于处理XML文档,但同样适用于HTML文档的数据搜索。
XPath具备强大的节点选择功能,提供简洁的路径表达式,并内置超过100个函数,涵盖字符串、数值、时间匹配及节点序列处理等。几乎所有需要定位的节点都可以通过XPath进行选择。
XPath于1999年11月16日成为W3C标准,旨在服务于XSLT、XPointer及其他XML解析软件。更多详细信息可访问其官方网站:https://www.w3.org/TR/xpath/。
数据乱码问题与解决方案
问题描述:
response = requests.get(url=url, headers=headers).text
html = etree.HTML(response)
name = html.xpath("/html/body/div[2]/ul/li[1]/a/p/text()")[0]
print(name)
虽然能够正常获取数据,但返回结果出现异常。
å·²éªè¯ å®å ¨ ç¾ç
这种乱码现象通常由编码不匹配引起。
解决方法:
name = html.xpath("/html/body/div[2]/ul/li[1]/a/p/text()")[0].encode('ISO-8859-1').decode('UTF-8')
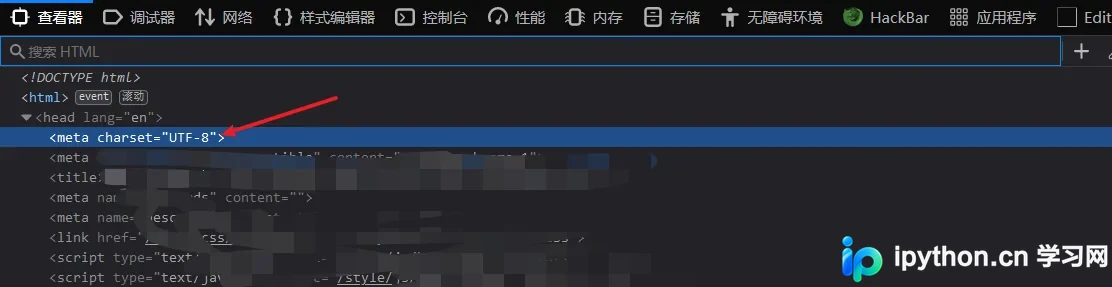
具体的UTF-8编码处理需根据实际网页的编码情况调整。
首先检查网页的编码设置。
可通过浏览器按F12打开开发者工具查看。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















