


Python爬虫实战:抓取豆瓣电影Top250并导出Excel

本文详解如何使用Python爬虫技术抓取豆瓣电影Top250榜单数据。通过requests库处理反爬机制,利用lxml进行XPath解析,并结合xlwt库将电影名称、评分及简介等信息批量写入Excel文件。文中包含完整的代码示例及异常处理方案,适合Python初学者参考学习。
豆瓣电影Top250分页机制与请求策略
豆瓣电影Top250榜单共分为10页,首页URL为https://movie.douban.com/top250。实际上,该链接隐含了分页参数,完整形式应为https://movie.douban.com/top250?start=0。其中start参数指定起始位置,例如start=0表示获取第1至25名(从《肖申克的救赎》到《触不可及》),而start=25则表示获取第26至50名(从《蝙蝠侠:黑暗骑士》到《死亡诗社》)。
基于上述规律,可以使用步长为25的range函数生成循环参数,以遍历所有页面。
具体实现代码如下:
for i in range(0, 250, 25): print(i)
解决反爬机制与获取页面源码
在分析页面结构后,尝试直接使用requests.get()获取页面内容,但发现返回结果为空。此时检查响应状态码。
url = 'https://movie.douban.com/top250?start=0'res = request.get(url=url)print(res.status_code)
结果显示响应码为418。
此前未遇到过此状态码,经网络搜索得知,需在get请求中添加header参数即可解决。
可以使用浏览器自带的User-Agent信息,例如:
headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'}
或者安装并使用fake_agent库(通过pip install fake_agent)生成随机User-Agent并添加到header字典中。
from fake_useragent import UserAgentheaders = {'User-Agent': UserAgent().random}
添加header后,即可成功获取页面源码。
使用lxml与XPath解析页面数据
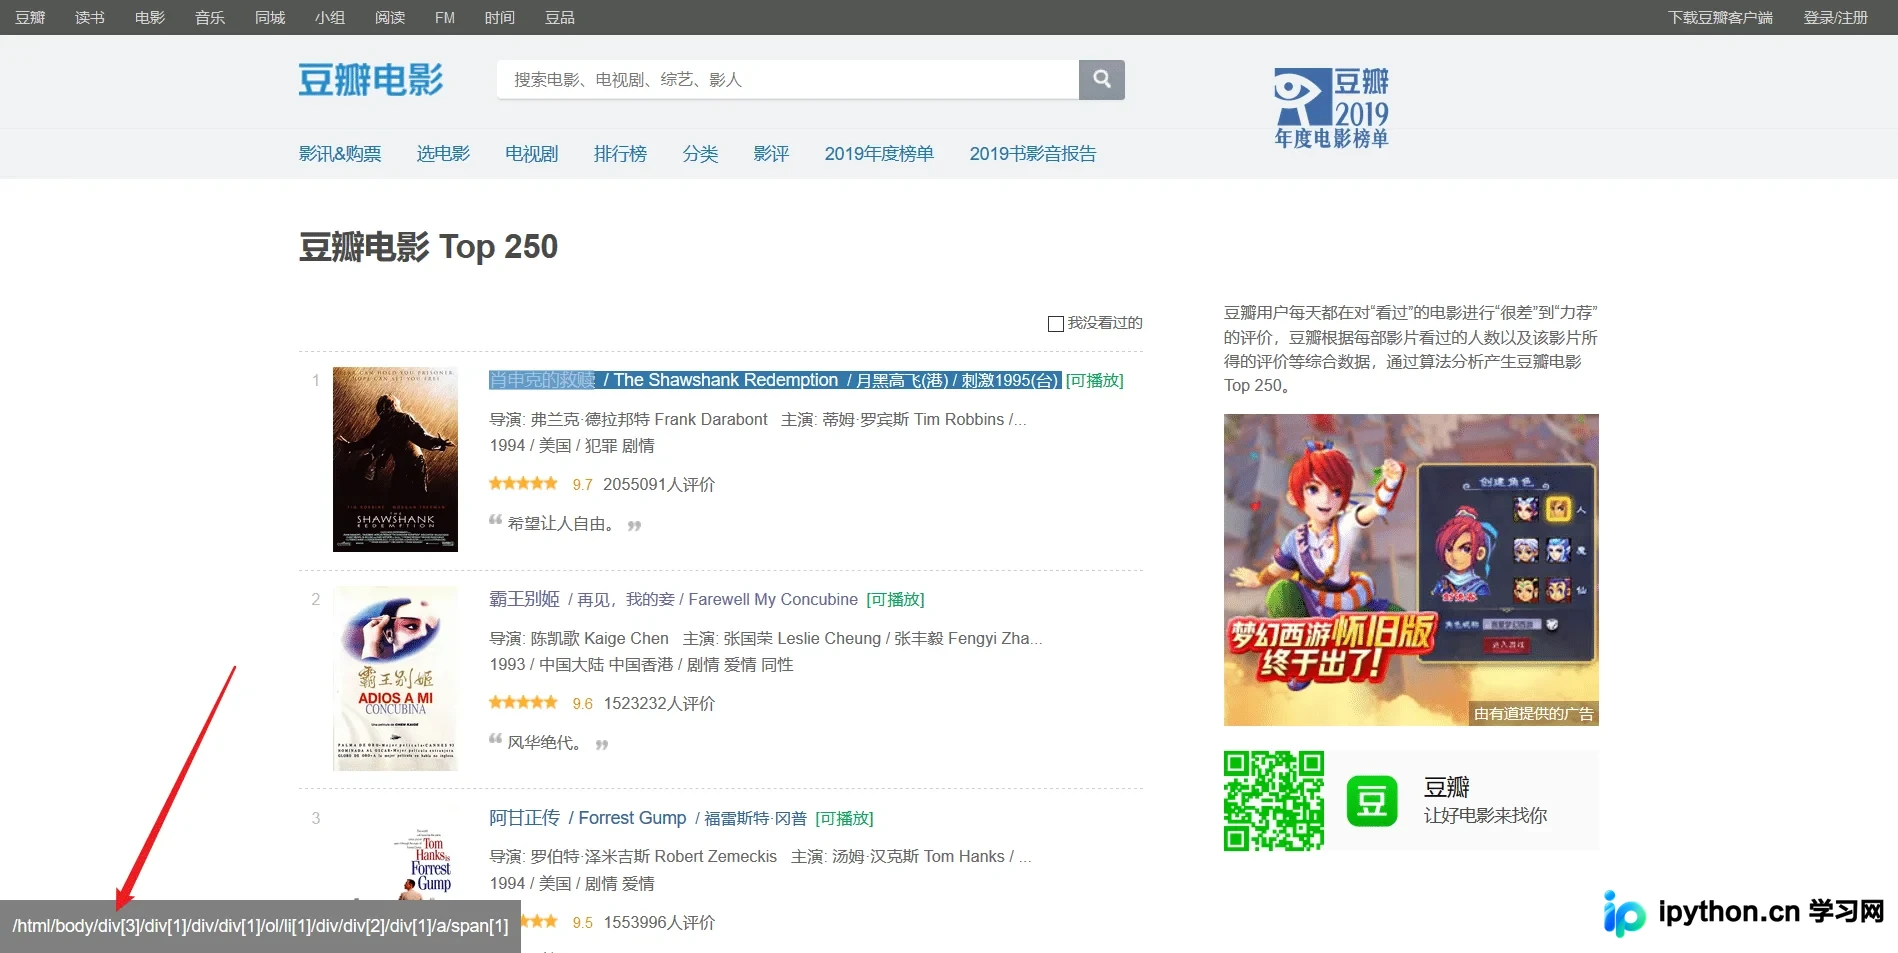
接下来使用lxml.etree模块,通过XPath解析页面源码。可借助浏览器插件xpath finder快速定位目标元素。
import requests
import lxml.etree as etree
url = 'https://movie.douban.com/top250?start=0'
headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'}
res = requests.get(url=url, headers=headers)
print(res.text)

html = etree.HTML(res.text)
name = html.xpath("/html/body/div[3]/div[1]/div/div[1]/ol/li[1]/div/div[2]/div[1]/a/span[1]")
print(name)
然而,直接解析得到的结果如下所示:
[<Element span at 0x20b2f0cc488>]
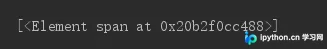
关于该对象的具体含义,已有文章进行了详细解释:https://www.jb51.net/article/132145.htm。
此处直接给出解决方案:在使用XPath解析时,需在路径末尾添加/text()以提取文本内容。
name = html.xpath("/html/body/div[3]/div[1]/div/div[1]/ol/li[1]/div/div[2]/div[1]/a/span[1]/text()")
修正后,再次使用xpath finder插件逐步定位,即可获取电影的所有相关数据。
数据封装与异常处理
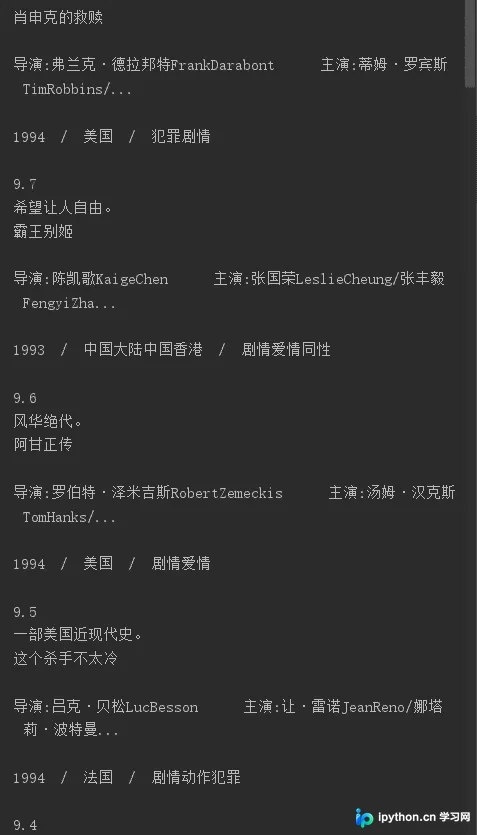
最后将上述逻辑封装为函数,并在外部套用上文提到的循环结构,即可完成数据抓取。
 # -*- coding: utf-8 -*-

import requests
import lxml.etree as etree


def get_source(page):
  url = 'https://movie.douban.com/top250?start={}'.format(page)
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'}
  print(url)
  res = requests.get(url=url, headers=headers)
  print(res.status_code)
  html = etree.HTML(res.text)
  for i in range(1, 26):
    name = html.xpath("/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[1]/a/span[1]/text()".format(i))
    info = html.xpath("/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[2]/p[1]/text()".format(i))
    score = html.xpath(
      "/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[2]/div/span[2]/text()".format(i))
    slogan = html.xpath(
      "/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[2]/p[2]/span/text()".format(i))
    print(name[0])
    print(info[0].replace(' ', ''))
    print(info[1].replace(' ', ''))
    print(score[0])
    print(slogan[0])


n = 1
for i in range(0, 250, 25):
  print('第%d页' % n)
  n += 1
  get_source(i)
  print('==========================================')
在定位过程中发现,有4部电影的简介中缺少slogan(宣传语),导致获取到的信息为空列表,进而引发list.append()报错。因此增加了几个异常处理步骤,虽然解决方法略显笨拙,但能解决问题。若有更优方案,欢迎交流。
相关代码可在文末查看。
利用xlwt库导出Excel文件
关于Excel保存部分的实现。
此处选用xlwt库进行操作。
book = xlwt.Workbook()
sheet = book.add_sheet(u'sheetname', cell_overwrite_ok=True)
上述代码用于创建一个Sheet表单。
将所有抓取到的数据存储在一个大列表中,采用列表嵌套列表的结构。
随后通过循环将数据逐行导入到Excel表单中。
r = 1
  for i in LIST: #有10页
    for j in i:  #有25条数据
      c = 2
      for x in j:    #有5组数据
        print(x)
        sheet.write(r, c, x)
        c += 1
      r += 1
最后执行保存操作。
book.save(r'douban.xls')
注意文件后缀必须使用.xls,若使用.xlsx可能导致文件无法打开。
至此,主要功能已完成。
打开生成的文件,手动添加排名等部分信息(这些也可在程序中实现,但因嫌麻烦未编写,直接手动添加更快捷)。
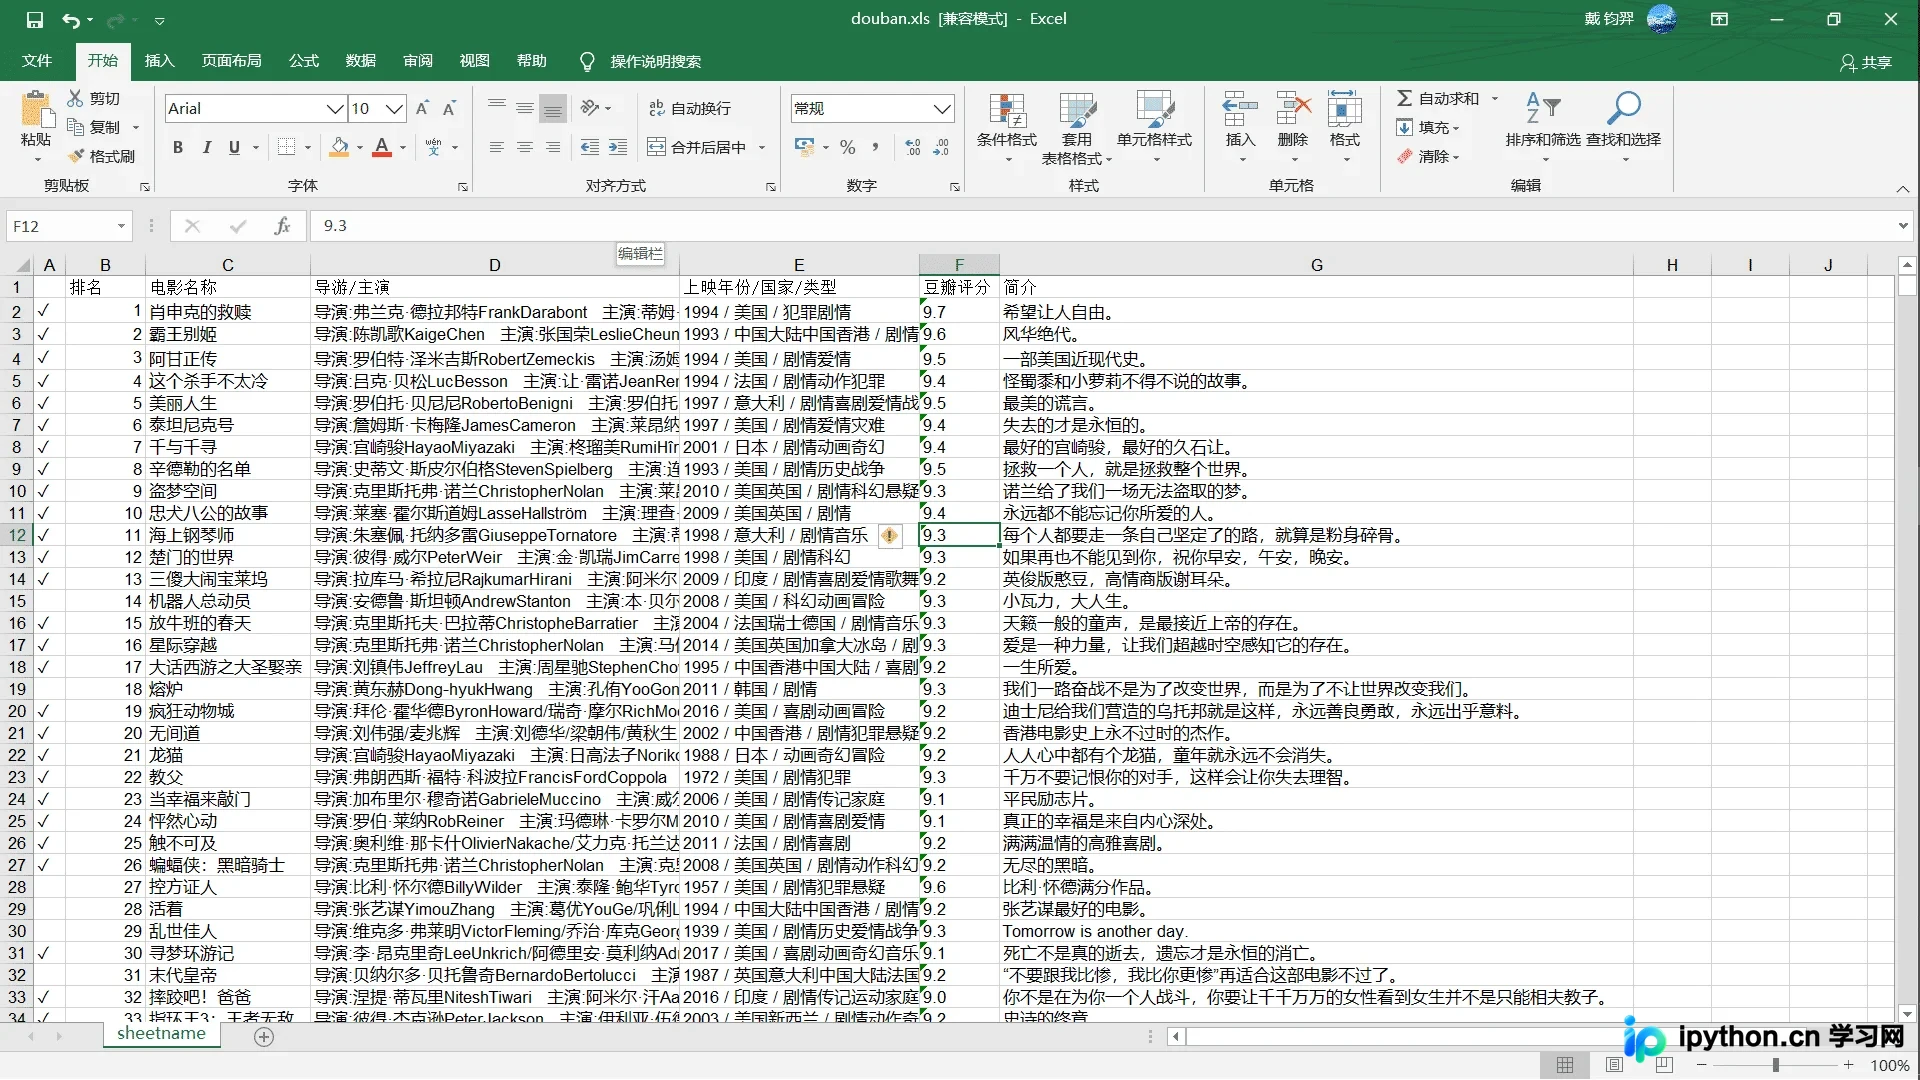
前文中的✓符号是我个人添加的,用于标记已观看或未观看的电影。
这也是编写该脚本的初衷。
完整代码附在下方,仅供参考。
# -*- coding: utf-8 -*-

import requests
import lxml.etree as etree
import xlwt

def get_source(page):
  List = []
  url = 'https://movie.douban.com/top250?start={}'.format(page)
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'}
  print(url)
  res = requests.get(url=url, headers=headers)
  print(res.status_code)
  html = etree.HTML(res.text)
  for i in range(1, 26):
    list = []
    name = html.xpath("/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[1]/a/span[1]/text()".format(i))
    info = html.xpath("/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[2]/p[1]/text()".format(i))
    score = html.xpath(
      "/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[2]/div/span[2]/text()".format(i))
    slogan = html.xpath(
      "/html/body/div[3]/div[1]/div/div[1]/ol/li[{}]/div/div[2]/div[2]/p[2]/span/text()".format(i))
    try:
      list.append(name[0])
    except:
      list.append('----')
    try:
      list.append(info[0].replace(' ', '').replace('\n', ''))
    except:
      list.append('----')
    try:
      list.append(info[1].replace(' ', '').replace('\n', ''))
    except:
      list.append('----')
    try:
      list.append(score[0])
    except:
      list.append('----')
    try:
      list.append(slogan[0])
    except:
      list.append('----')

    List.append(list)

  return List


n = 1
LIST = []
for i in range(0, 250, 25):
  print('第{}页'.format(n))
  n += 1
  List = get_source(i)
  LIST.append(List)


def excel_write(LIST):
  book = xlwt.Workbook()
  sheet = book.add_sheet(u'sheetname', cell_overwrite_ok=True)
  r = 1
  for i in LIST: #有10页
    for j in i:  #有25条数据
      c = 2
      for x in j:    #有5组数据
        print(x)
        sheet.write(r, c, x)
        c += 1
      r += 1

  book.save(r'douban1.xls')  #保存代码
excel_write(LIST)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















