


写Python爬虫违法吗?法律边界与robots.txt协议解读

robots.txt君子协议的规则语法、法律效力与代码实现。
一、核心结论:爬虫技术中立,行为决定性质
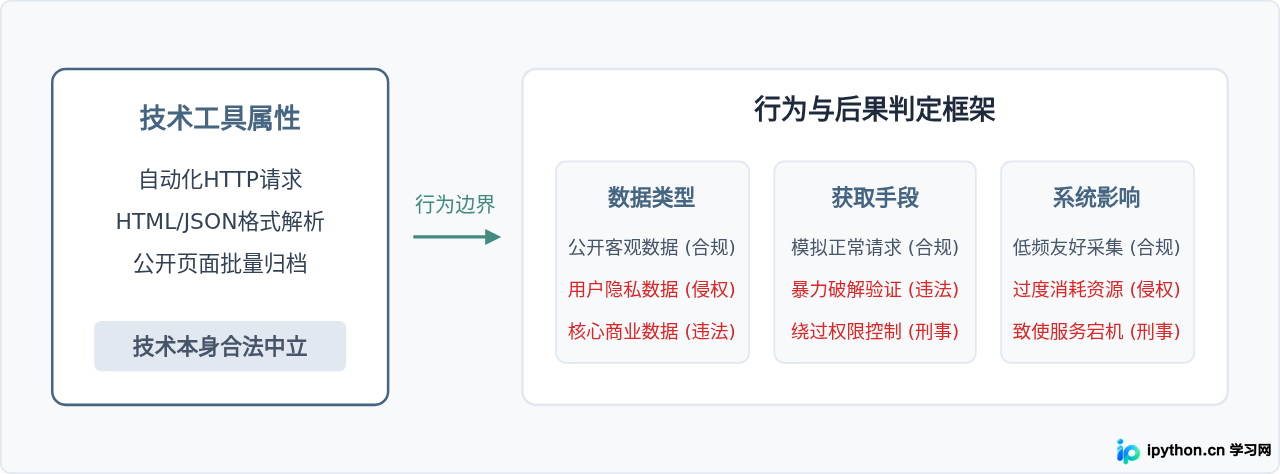
在计算机体系中,网络爬虫本质上是一个自动化发送HTTP请求并解析响应内容的脚本程序。从网络协议的层面看,爬虫发出的GET或POST请求与普通用户在浏览器中点击链接、浏览页面没有根本区别。
因此,司法实践中从未将“编写爬虫代码”或“拥有爬虫程序”定义为非法行为。让开发者承担民事赔偿甚至刑事责任的,往往是以下三种具体的行为表现:
- 爬取对象非法:抓取了受法律严格保护的个人敏感信息、商业秘密或未公开的国家数据。
- 获取方式非法:通过撞库、绕过反爬机制、破解鉴权接口或伪造凭据,非法入侵或破坏目标系统。
- 产生危害后果:高并发请求导致目标服务器瘫痪,或者将爬取的数据直接打包转售、不正当竞争牟利。
二、法律边界:不可触碰的三条法定红线
爬虫开发者需要清楚了解哪些法律条文经常出现在与数据采集相关的诉讼案件中。在我国现行司法框架下,主要涉及刑事责任、知识产权与不正当竞争、个人信息保护三个层面。
1. 刑事红线:非法侵入与破坏计算机信息系统
根据《中华人民共和国刑法》第285条、286条的规定,若爬虫使用非法技术突破网站的登录鉴权、IP封禁策略,或者通过破解加密算法、利用未授权接口抓取后台非公开数据,极易被定性为非法获取计算机信息系统数据罪。
此外,编写多线程高并发爬虫时,如果未做限速处理,短时间内向目标服务器发送海量请求,占满目标带宽或导致数据库崩溃,在客观上造成了系统瘫痪的后果,可能会触犯破坏计算机信息系统罪。
2. 民事与经济红线:不正当竞争与著作权侵权
若目标网站上的数据属于公开内容,但开发者将抓取到的内容(如房源信息、商家点评、原创文章、数据库目录)直接用于搭建与原网站业务高度重合的同质化产品,并以此赚取广告费或会员费,根据《反不正当竞争法》第二条,这种“不劳而获”的搭便车行为会被认定为不正当竞争行为。
3. 个人隐私红线:公民个人信息保护
按照《个人信息保护法》要求,未经用户明确授权,利用爬虫批量抓取用户的姓名、身份证号、手机号码、家庭住址、通讯录或行踪轨迹等个人隐私,属于严重违法行为。情节严重且达到一定抓取量级(如数千条以上敏感信息)的,将构成侵犯公民个人信息罪。
三、robots.txt 协议深度解读
在探讨法律责任时,经常有人提到网站根目录下的 robots.txt。这个文件究竟是什么,它能起到怎样的约束作用?
1. robots.txt 的定义与基本语法
robots.txt 诞生于1994年,全称为“机器人排除协议”(Robots Exclusion Protocol)。它是一个存放在网站根目录下的纯文本文件(例如 https://example.com/robots.txt),网站管理员通过该文件明确告知搜索引擎和自动化爬虫:网站的哪些目录允许爬取,哪些目录禁止抓取。
一个标准的 robots.txt 文件通常包含以下核心字段:
User-agent:指定规则适用的爬虫名称。例如Baiduspider、Googlebot,或者用*代表所有爬虫。Disallow:指定不允许抓取的URL路径前缀。Allow:在禁止路径的基础上,补充允许爬取的子路径。Crawl-delay:建议的抓取间隔时间(单位为秒),用于保护服务器负载。Sitemap:提供网站的站点地图XML地址,引导爬虫有效索引。
# 示例:典型的 robots.txt 结构
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /api/v1/user/
Allow: /api/v1/user/public/
Crawl-delay: 2

Sitemap: https://example.com/sitemap.xml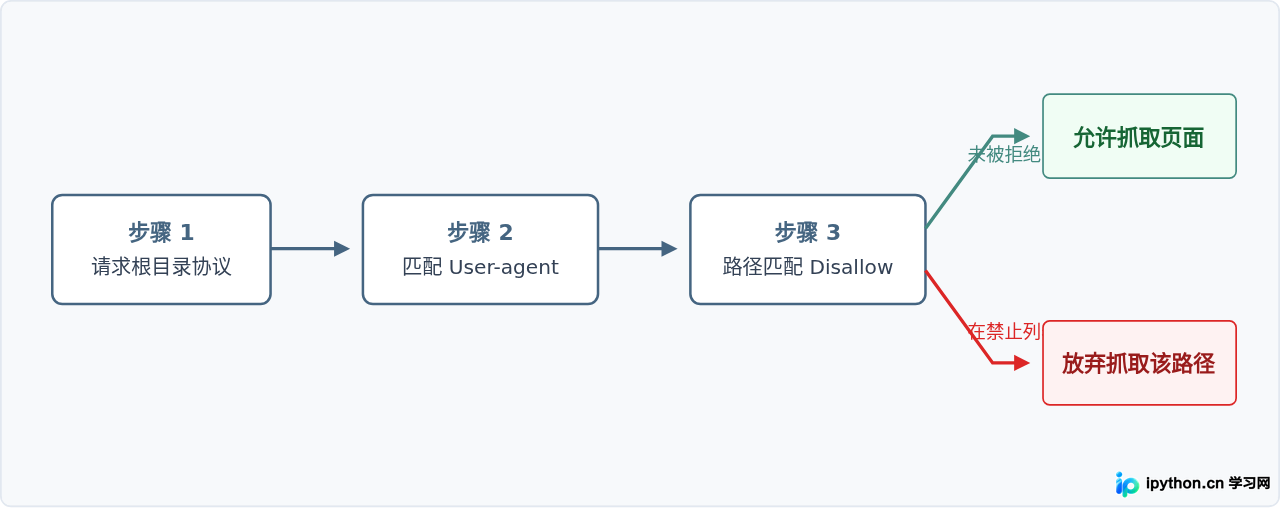
2. robots.txt 的法律效力分析
很多开发者常有一个误区:只要遵循了 robots.txt,爬虫就绝对合法;反之,只要违背了 robots.txt,就一定构成犯罪。这两种理解都不符合实际法律判例:
- 本质上是技术性行业惯例:
robots.txt没有国际强制标准,不具备直接的行政法规效力,技术上无法阻止任何直接发起的底层Socket连接。 - 是判断主观恶意的重要事实依据:在民事不正当竞争案件中,法院通常会将“目标网站是否配置了明确禁止爬取的robots.txt”以及“被告是否故意绕过协议”作为认定主观恶意和违背商业道德的重要参考依据。
- 不能豁免其他违法行为:即便目标网站的
robots.txt为空(允许所有抓取),爬虫抓取个人敏感隐私信息、盗版著作权作品或通过高频请求搞垮服务器,依然构成严重违法。
四、在Python代码中正确解析与遵守robots.txt
Python标准库自带了 urllib.robotparser 模块,开发者无需依赖第三方库,就可以方便地下载并校验目标URL是否在允许抓取的名单内。
在实际发起数据抓取前,标准的解析流程如下:
import urllib.robotparser
import urllib.parse
import requests

def check_crawl_permission(target_url, user_agent="MyBot"):
    """
    检查目标URL是否被 robots.txt 允许爬取
    """
    # 1. 自动提取网站主域名根路径并拼接 robots.txt
    parsed = urllib.parse.urlparse(target_url)
    robots_url = f"{parsed.scheme}://{parsed.netloc}/robots.txt"

    # 2. 初始化解析器
    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(robots_url)

    try:
        # 读取并解析远端 robots.txt 文件
        rp.read()
    except Exception as e:
        # 网络异常或无 robots.txt 时的容错处理
        print(f"无法获取 robots.txt ({e}),按照默认策略继续或终止")
        return True

    # 3. 判定当前 User-Agent 是否允许抓取该路径
    can_fetch = rp.can_fetch(user_agent, target_url)

    # 4. 可选:检查站长建议的访问延迟(秒)
    delay = rp.crawl_delay(user_agent)
    if delay:
        print(f"网站要求抓取间隔: {delay} 秒")

    return can_fetch

# 实际测试示例
url_to_test = "https://example.com/api/v1/user/private_data"
allowed = check_crawl_permission(url_to_test, user_agent="CustomPythonCrawler")

if allowed:
    print("协议允许访问,准备发送请求...")
    # response = requests.get(url_to_test, headers={"User-Agent": "CustomPythonCrawler"})
else:
    print("robots.txt 已明确拒绝访问该路径,脚本跳过本条URL。")
robots.txt 的HTTP状态码设为404(不存在)或403。根据通用网络规范,若 robots.txt 返回404,通常视为全站公开允许抓取;若直接返回403或500错误,稳妥的策略是暂停抓取或按保守规则处理。
五、安全合规爬取操作指南与避坑清单
为了让爬虫项目在合法合规的前提下运行,开发者可以参照下表对照自身代码的实现方式:
| 合规考量维度 | 高风险行为(应严厉避免) | 合规做法(推荐执行) |
|---|---|---|
| 目标数据 | 个人隐私、商业机密、付费墙内容 | 公开透明的客观数据、公开资讯 |
| 请求频控 | 无延迟死循环请求、突发大并发压测 | 设置随机时间延迟(如1~3秒)、限制连接池 |
| 身份标识 | 恶意伪造虚假来源、假冒大厂核心系统 | 如实设置User-Agent,可附带联系方式或标识 |
| 安全机制 | 暴力破解验证码、注入漏洞逆向授权 | 仅通过公开暴露的合法页面接口采集 |
| 数据应用 | 原样克隆并商业化运营、打包倒卖获利 | 学术研究、数据挖掘统计分析、内部参考 |
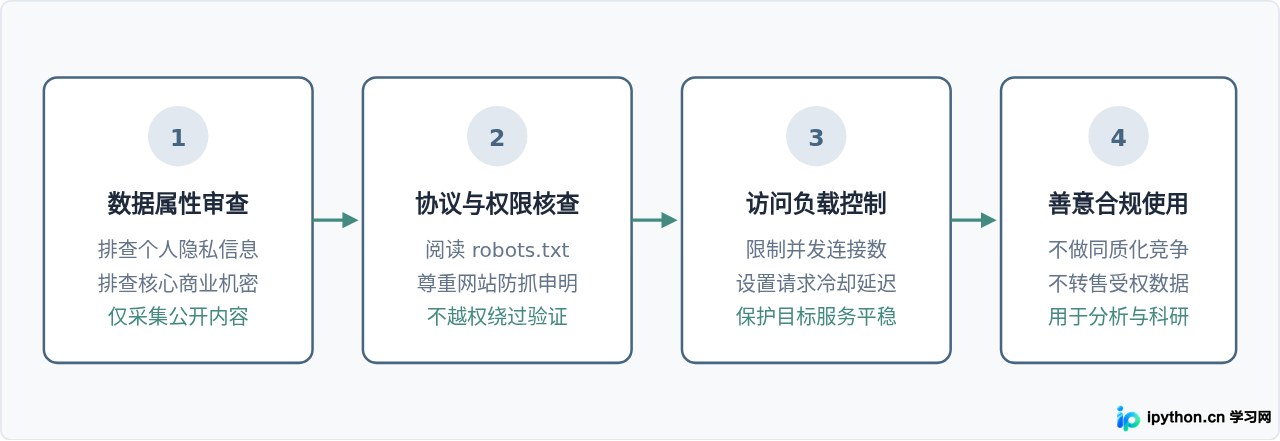
编写爬虫的技术门槛并不高,但对法律边界与工程规范的把控直接决定了一个项目的生命周期。将爬虫严格限定在公开信息、低频请求以及非竞争性使用的范围内,是每一位开发人员应当遵循的基本准则。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















