


Python Pandas实现一行拆多行与多行合并一行的两种方法

发布时间:2026-10-14 |
3人浏览过
本文介绍在Python Pandas中处理数据结构的两种常见操作:一行拆多行和多行并一行。通过Pandas.melt与str.split组合,以及新增的explode方法,分别实现拆分逻辑;利用groupby聚合函数完成合并。文章提供完整代码示例与关键参数说明,帮助开发者高效解决数据重塑问题。
Python Pandas实现一行拆多行与多行合并一行的两种方法
粉丝提问
今日有读者提出一个数据处理需求,涉及“一行拆多行”与“多行并一行”两个方向。虽然部分用户已通过Power Query解决,但本文重点探讨如何在Python环境下实现相同功能。
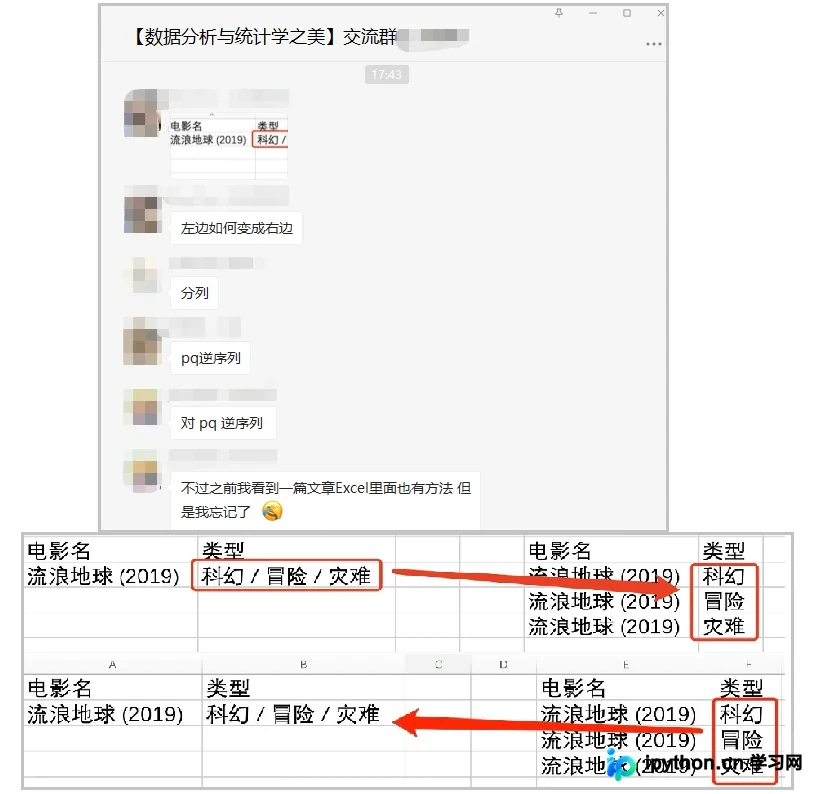
一行拆多行的两种实现思路
一行拆多行
针对上述拆分需求,本文提供两种不同的实现思路,供读者根据实际场景选择。推荐优先使用更简洁的方法,同时每种方案中均包含值得深入学习的技巧。
方法一
以下代码涉及多个关键知识点,建议读者结合实例深入理解。此处仅展示解决思路,具体函数的详细用法需读者自行查阅文档与实践。
- 掌握Pandas.melt()函数的使用;
- 理解Series.str.split("/",expand=True)中expand=True参数的作用;
- 学习Series.sort_values()对文本字段进行排序;
- 熟悉Python中enumerate()函数的遍历用法;
import pandas as pd
# 读取数据
df = pd.read_excel("test1.xlsx",sheet_name="Sheet1")
# 将一列炸裂成多列
df[["类型1","类型2","类型3"]] = df["电影类型"].str.split("/",expand=True)
# 选取想要的列
df_final = df[["电影名","类型1","类型2","类型3"]]
# 将行专列
df_final = df_final.melt(id_vars=["电影名"],value_name="类型")
# 对“电影名”字段进行排序
df_final = df_final[["电影名","类型"]]
df_final.sort_values(by="电影名",inplace=True)
# 删除“类型==None”的行
for index,value in enumerate(df_final["类型"]):
  if value == None:
    df_final.drop(df_final.index[index],inplace=True)
df_final
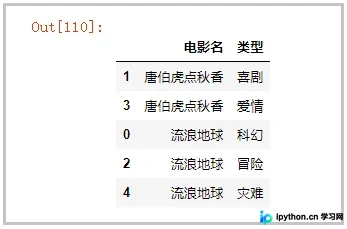
运行结果如下:
方法二
前述方法逻辑相对繁琐。若读者使用的Pandas版本低于0.25(如0.23.4),则无法使用explode()方法。该函数在Pandas 0.25版本中引入,专门用于将单行数据展开为多行。
掌握Pandas.explode()函数的使用;
import pandas as pd
# 读取数据
df = pd.read_excel("test1.xlsx",sheet_name="Sheet1")
# 将一行拆分成列表形式,注意:这里不需要使用expand=True参数
df["type"] = df["电影类型"].str.split("/")
# 直接炸裂指定列
df.explode("type")
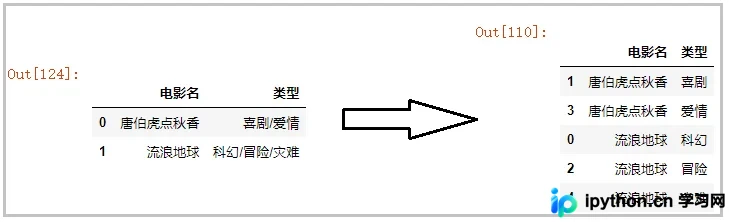
运行结果如下:
多行并一行的聚合处理
多行并一行
此部分无需复杂技巧,核心在于理解Pandas的分组聚合操作。通过定义聚合函数并应用于groupby结果,即可轻松实现多行数据合并为一行。
import pandas as pd
# 读取数据
df = pd.read_excel("test1.xlsx",sheet_name="Sheet2")
# 分组聚合,应用某个函数
def func(df):
  return ','.join(df.values)
df = df.groupby(by='电影名').agg(func).reset_index()
df
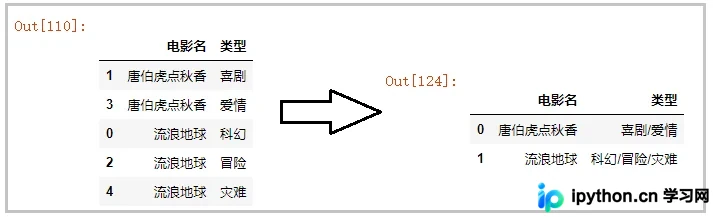
运行结果如下:
本文介绍了Python中实现一行拆多行和多行并一行的示例代码。更多相关Python 一行拆多行和多行并一行内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















