


Python 实现免费简历模板网站批量爬取与本地保存

本文详细介绍如何使用 Python 编写爬虫程序,从指定网站批量抓取免费简历模板。通过 requests 获取页面源码,利用 lxml 解析 HTML 结构提取下载链接,并结合 os 模块实现文件的自动创建与本地保存。代码包含分页处理、请求头伪装及异常处理逻辑,适用于学习网络爬虫基础及文件自动化操作。
Python 爬虫环境准备与基础配置
首先,我们需要导入必要的 Python 库,包括用于发送 HTTP 请求的 requests、处理 HTML 解析的 lxml 以及操作系统相关的 os 模块。接着,定义本地存储目录为 './resumeLibs',并检查该目录是否存在,若不存在则自动创建。为了模拟浏览器访问,避免被服务器拒绝,我们设置了包含 User-Agent 的请求头信息,指定为 Windows 10 系统下的 Chrome 浏览器版本。随后,定义目标网站的 URL 模板,用于处理分页逻辑。
核心爬取逻辑与文件保存实现
# 免费的简历模板进行爬取本地保存
# http://sc.chinaz.com/jianli/free.html
# http://sc.chinaz.com/jianli/free_2.html

import requests
from lxml import etree
import os

dirName = './resumeLibs'
if not os.path.exists(dirName):
  os.mkdir(dirName)

headers = {
  'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/85.0.4183.83 Safari/537.36'
}
url = 'http://sc.chinaz.com/jianli/free_%d.html'
for page in range(1,2):
  if page == 1:
    new_url = 'http://sc.chinaz.com/jianli/free.html'
  else:
    new_url = format(url%page)
  page_text = requests.get(url=new_url,headers=headers).text
  tree = etree.HTML(page_text)
  a_list = tree.xpath('//div[@id="container"]/div/p/a')

  for a in a_list:
    a_src = a.xpath('./@href')[0]
    a_title = a.xpath('./text()')[0]
    a_title = a_title.encode('iso-8859-1').decode('utf-8')
    # 爬取下载页面
    page_text = requests.get(url=a_src,headers=headers).text
    tree = etree.HTML(page_text)
    dl_src = tree.xpath('//div[@id="down"]/div[2]/ul/li[8]/a/@href')[0]

    resume_data = requests.get(url=dl_src,headers=headers).content
    resume_name = a_title
    resume_path = dirName + '/' + resume_name + '.rar'
    with open(resume_path,'wb') as fp:
      fp.write(resume_data)
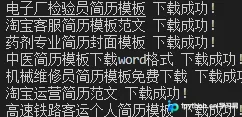
      print(resume_name,'下载成功!')
代码执行流程与结果说明
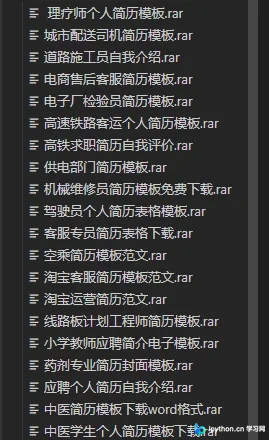
程序通过循环遍历页码(示例中仅处理第一页)来构建实际请求 URL。对于第一页,使用特定的静态链接;后续页面则通过格式化字符串生成动态链接。获取页面源码后,利用 etree.HTML 解析 DOM 树,并通过 XPath 表达式定位包含简历链接的 div 容器下的所有 a 标签。遍历这些链接,提取 href 属性作为详情页地址,同时获取链接文本作为简历标题。注意处理标题编码问题,确保文件名正确显示。进入详情页后,再次解析页面,通过特定的 XPath 路径定位到下载按钮的链接,获取实际的资源下载地址。最后,发送请求获取二进制数据,并在本地创建对应的 .rar 文件进行写入保存,打印下载成功信息以确认操作完成。
总结与扩展阅读
以上就是 Python 爬取免费简历模板网站的示例的详细内容,更多关于 Python 爬取网站的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















