


Python实现免费代理IP抓取与有效性验证

本文介绍使用Python爬取免费代理IP并验证其可用性的完整流程。通过Requests获取网页源码,利用BeautifulSoup解析提取IP与端口,再向百度发起带代理的请求测试状态码。代码支持自定义页数遍历,最终输出所有有效IP列表,解决手动测试效率低下的问题。
Python实现免费代理IP抓取与有效性验证
本文主要讲解如何爬取代理IP并测试其是否可用。
在进行网络爬虫开发时,为避免IP被封禁,常需从各类网站获取免费代理IP。由于并非所有公开IP均能正常使用,逐一手动验证效率极低。针对这一痛点,本文尝试编写程序自动从指定网站抓取免费代理IP,并逐一进行连通性测试,最终筛选出可用IP返回。
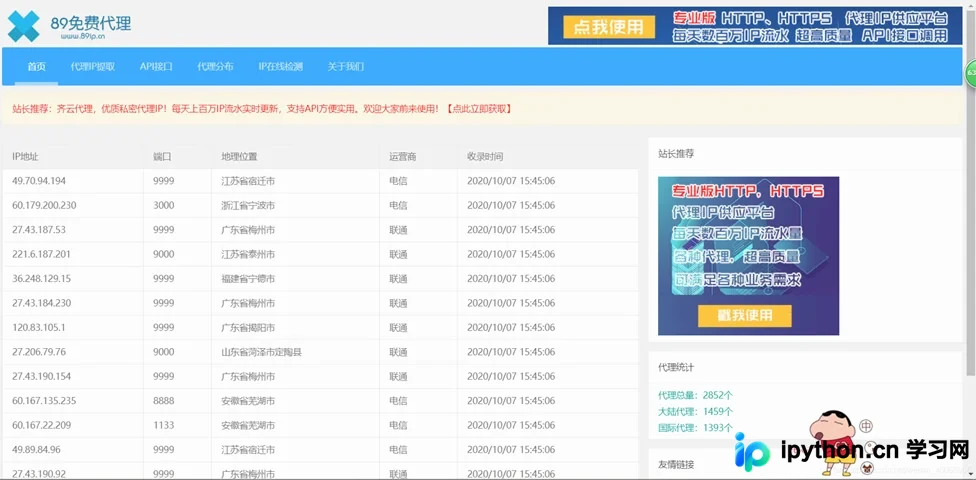
本示例选取89免费代理IP网站作为数据源,对抓取到的每一个IP执行比对测试,并将最终确认可用的IP保存至独立列表中。
目标网站地址:https://www.89ip.cn/
准备工作
一、准备工作
导入必要的Python库,并配置请求头信息。
import requests
from bs4 import BeautifulSoup

header = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/85.0.4183.121 Safari/537.36'
}
提取网页源码
二、提取网页源码
该步骤旨在获取目标网站的完整HTML源代码。
def getHtml(url):
  try:
    reponse = requests.get(url, headers=header)
    reponse.raise_for_status()
    reponse.encoding = reponse.apparent_encoding
    return reponse.text
  except:
    return "网页源码提取错误"
解析HTML并提取IP
三、解析HTML并提取IP
此函数接收两个参数:一是网页HTML源码,二是用于存储提取出的IP地址的列表。
# 解析网页,提取IP
def getIp(html, list):
  try:
    soup = BeautifulSoup(html, "html.parser")
    tr = soup.find("tbody").find_all_next("tr")
    for ip in tr:
      # 提取IP
      td = ip.find_next("td").string
      td = str(td).replace(" ", "").replace("\n", "").replace("\t", "")
      # 提取端口号
      dk = ip.find_all_next("td")[1].string
      dk = str(dk).replace(" ", "").replace("\n", "").replace("\t", "")
      # 将IP和端口号进行连接
      ip = td + ":" + dk
      list.append(ip) # 再进IP地址存放至指定列表中去
  except:
    print("获取IP失败")
测试IP是否可用
四、测试IP是否可用
IP有效性测试的基本原理是:使用Requests库向百度网站发起请求,并将待测IP作为代理传入。若服务器返回的状态码为200,则判定该IP有效;若出现其他状态码或异常,则判定为无效。
# 测试出可用IP
def ip_text(list, valid_IP):
  try:
    url = "https://www.baidu.com//"
    for ip in list:
      try:
        rep = requests.get(url, proxies={'https': ip}, headers=header, timeout=0.5)
        if rep.status_code == 200: # 如果放回的状态码是200,那么说明该IP地址可用
          valid_IP.append(ip)
          print("该代理IP有效:" + ip)
        else:
          print("该代理IP无效:" + ip)
      except:
        print("该代理IP无效:" + ip)
  except:
    print("IP测试失败")
主函数main
五、主函数main
主函数负责调用上述各功能模块,并允许用户自定义爬取页数以生成对应的URL序列。程序运行结束时,会打印输出所有经过测试的有效IP地址。
if __name__ == '__main__':

  valid_IP = [] # 有效IP地址
  for i in range(1, 90): # 可自定义页数
    ip_list = [] # 存放所有爬取到的ip
    url = "https://www.89ip.cn/index_" + str(i) + ".html"
    print(url)
    html = getHtml(url)
    getIp(html, ip_list)
    ip_text(ip_list, valid_IP)

  print("=" * 30)
  print("测试完成,有效IP如下:")
  print("-" * 30)
  for a in valid_IP:
    print(a)
  print("=" * 30)
至此,代码的整体框架已构建完成,以下是全部代码展示。
完整代码
# -*- coding: utf-8 -*-
# Author : YRH
# Data : 2020/10/07
# Project : 爬取代理IP并且测试可用IP
# Tool : PyCharm

import requests
from bs4 import BeautifulSoup

header = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/85.0.4183.121 Safari/537.36'
}


# 提取网页源码
def getHtml(url):
  try:
    reponse = requests.get(url, headers=header)
    reponse.raise_for_status()
    reponse.encoding = reponse.apparent_encoding
    return reponse.text
  except:
    return "网页源码提取错误"


# 解析网页,提取IP
def getIp(html, list):
  try:
    soup = BeautifulSoup(html, "html.parser")
    tr = soup.find("tbody").find_all_next("tr")
    for ip in tr:
      # 提取IP
      td = ip.find_next("td").string
      td = str(td).replace(" ", "").replace("\n", "").replace("\t", "")
      # 提取端口号
      dk = ip.find_all_next("td")[1].string
      dk = str(dk).replace(" ", "").replace("\n", "").replace("\t", "")
      # 将IP和端口号进行连接
      ip = td + ":" + dk
      list.append(ip) # 再进IP地址存放至指定列表中去
  except:
    print("获取IP失败")


# 测试出可用IP
def ip_text(list, valid_IP):
  try:
    url = "https://www.baidu.com//"
    for ip in list:
      try:
        rep = requests.get(url, proxies={'https': ip}, headers=header, timeout=0.5)
        if rep.status_code == 200: # 如果放回的状态码是200,那么说明该IP地址可用
          valid_IP.append(ip)
          print("该代理IP有效:" + ip)
        else:
          print("该代理IP无效:" + ip)
      except:
        print("该代理IP无效:" + ip)
  except:
    print("IP测试失败")


if __name__ == '__main__':

  valid_IP = [] # 有效IP地址
  for i in range(1, 90): # 可自定义页数
    ip_list = [] # 存放所有爬取到的ip
    url = "https://www.89ip.cn/index_" + str(i) + ".html"
    print(url)
    html = getHtml(url)
    getIp(html, ip_list)
    ip_text(ip_list, valid_IP)

  print("=" * 30)
  print("测试完成,有效IP如下:")
  print("-" * 30)
  for a in valid_IP:
    print(a)
  print("=" * 30)
到此这篇关于python爬取代理IP并进行有效的IP测试实现的文章就介绍到这了,更多相关python爬取代理IP内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















