


Python从PDF提取数据表并转换为CSV的完整流程

本文详细介绍如何利用Python从PDF文件中提取表格数据,并将其转换为适合分析的CSV格式。内容涵盖从原始数据导入、一维数据重塑、百分比符号去除到数据类型转换的全过程,通过具体代码示例展示如何清洗和导出最终数据,帮助数据科学家高效处理非结构化文档中的表格信息。
01
前言:PDF数据提取的重要性
前言
在数据科学领域,数据是任何分析工作的核心基础。大多数常规分析所依赖的数据集,通常是经过清洗、存储在逗号分隔值(CSV)表格中的结构化数据。然而,可移植文档格式(PDF)作为业界最广泛使用的文件格式之一,其内部往往包含大量未结构化的表格信息。因此,每一位数据科学家都必须掌握从PDF文件中提取数据的方法,并能将其转换为CSV等标准格式,以便进行后续的数据分析或模型构建。
本文主要聚焦于从PDF文件中提取数据表的技巧与方法。虽然类似的思路也可用于提取文本或图像,但我们将重点演示如何精准提取表格数据,并将其转换为适用于进一步分析和建模的标准格式。为了便于理解,文章将提供一个完整的实际操作案例。
02
Python从PDF提取表格数据实战
示例:使用Python从PDF文件中提取一个表格
数据预处理:从Excel到CSV
a) 将表复制到Excel并保存为table_1_raw.csv
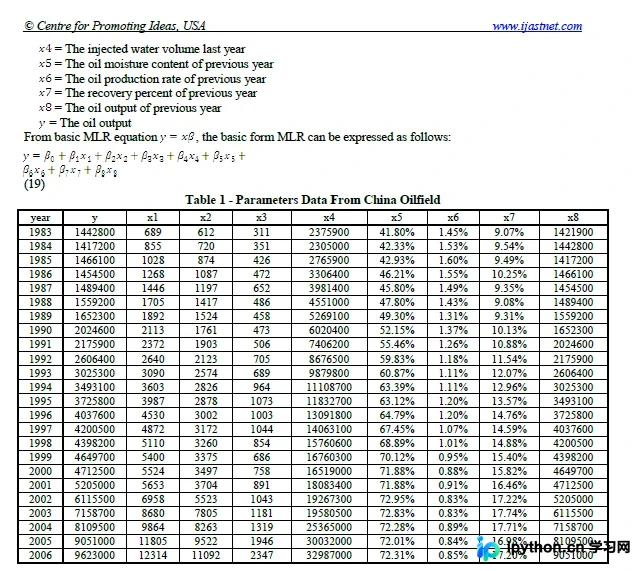
从PDF直接导出的数据通常以无序的一维格式存储,缺乏明确的行列结构。因此,在分析前必须对数据进行重塑、清理和格式转换,以恢复其表格结构。
环境配置与数据导入
b) 导入必要的库
import pandas as pd
import numpy as np
c) 导入原始数据,重新定义数据结构
df=pd.read_csv("table_1_raw.csv", header=None)
df.values.shape
df2=pd.DataFrame(df.values.reshape(25,10))
column_names=df2[0:1].values[0]
df3=df2[1:]
df3.columns = df2[0:1].values[0]
df3.head()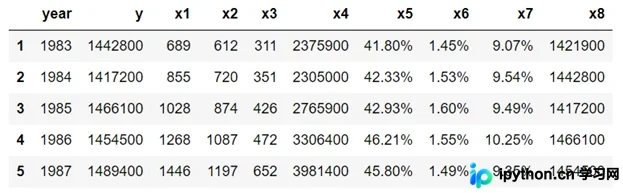
字符串清洗与格式转换
d) 使用字符串处理工具进行数据纠缠与清洗
观察上述表格数据可以发现,x5、x6和x7列的数值是以百分比形式表示的。为了进行数值计算,我们需要去除这些列中的百分号(%)符号。
df4['x5']=list(map(lambda x: x[:-1], df4['x5'].values))
df4['x6']=list(map(lambda x: x[:-1], df4['x6'].values))
df4['x7']=list(map(lambda x: x[:-1], df4['x7'].values))
数值类型转换与导出
e) 将数据转换为数字形式
经过初步处理后,我们注意到x5、x6和x7列的数据类型仍为字符串(string)。为了进行数学运算,必须将这些列强制转换为浮点型数值数据,具体操作如下所示:
df4['x5']=[float(x) for x in df4['x5'].values]
df4['x6']=[float(x) for x in df4['x6'].values]
df4['x7']=[float(x) for x in df4['x7'].values]
f) 查看转换数据的最终形式
df4.head(n=5)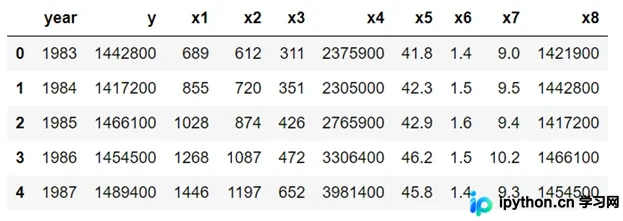
g) 导出最终数据到一个csv文件
df4.to_csv('table_1_final.csv',index=False)以上就是Python从PDF中提取数据的示例的详细内容,更多关于python 提取PDF数据的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















