


Python爬虫中Requests设置Headers请求头的方法与反爬策略

本文详解Python爬虫中Requests库设置Headers请求头的技巧。针对网页反爬限制,通过抓取浏览器真实请求头并模拟User-Agent等关键信息,有效绕过禁止爬取提示。文章提供从获取Headers到代码实现的完整步骤,帮助开发者解决爬虫访问被拒问题。
设置Headers的必要性
1、为什么要设置headers?
在进行网页数据爬取时,若返回的文本信息中包含“抱歉,无法访问”等提示,通常意味着目标网站启用了反爬机制。此时需要通过特定的技术手段来绕过这一限制,以获取所需数据。
Headers是应对Requests请求中反爬策略的有效手段之一。通过正确配置Headers,可以使得爬虫程序在服务器端看起来像是正常的浏览器访问,从而模拟真实用户的操作行为。
对于具备反爬虫机制的网页,设置详细的Headers信息可以模拟浏览器的访问特征,从而成功访问目标网站,避免被识别为恶意爬虫。
获取Headers的方法
2、headers在哪里找?
在谷歌或火狐浏览器中,打开目标网页后点击右键选择“检查”,随后按照界面提示进行操作。为了获取最新的请求数据,通常需要按Fn+F5刷新页面以触发网络请求。
部分浏览器可能提供“右键->查看元素”的选项,操作后同样需要刷新页面以获取完整的请求头信息。
Python中Requests设置Headers的具体实现
3、Python爬虫中Requests设置请求头Headers的方法
需要注意的是,Headers包含大量字段,其中最常用的是user-agent和host。这两个字段以键值对形式呈现。如果仅将user-agent以字典形式作为Headers内容,通常足以通过反爬验证;若仍被拦截,则需添加Headers下的更多键对信息,以完全模拟浏览器环境。
具体实现代码如下:
import re
# 下方引号内添加替换掉请求头内容
headers_str = """
Accept: application/json, text/javascript, */*; q=0.01
Accept-Encoding: gzip, deflate, br
Accept-Language: zh-CN,zh;q=0.9,en;q=0.8
Cache-Control: no-cache
Connection: keep-alive
Content-Length: 77
Content-Type: application/json
User-Agent: Mozilla/5.0 (iPhone; CPU iPhone OS 13_2_3 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/13.0.3 Mobile/15E148 Safari/604.1
X-Apple-App-Id: 632
X-Apple-Frame-Id: daw-10beaddd-c22f-4fd4-8aba-ef4909a721dd
X-Requested-With: XMLHttpRequest
"""
pattern = '^(.*?):(.*)$'
for line in headers_str.splitlines():
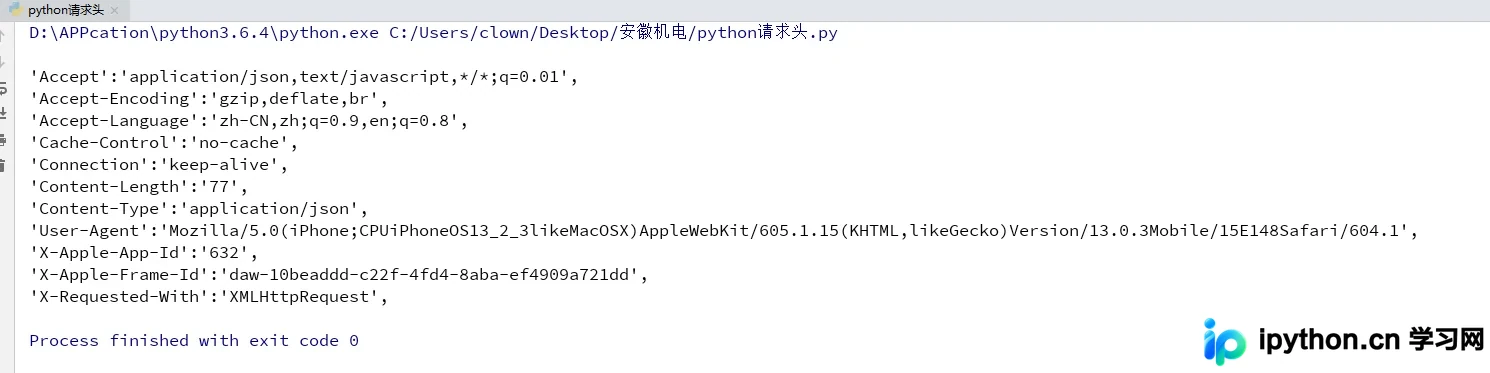
  print(re.sub(pattern,'\'\\1\':\'\\2\',',line).replace(' ',''))
运行上述代码后,可得到处理后的Headers字典结构,便于直接用于Requests请求中。
以上内容为本文的核心知识点,旨在帮助读者掌握Python爬虫中Headers的设置技巧,提升爬取成功率。希望本文对大家的学习有所帮助,欢迎持续关注本站获取更多技术分享。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















