


Python爬虫网络请求:IP代理、Cookie与异常处理详解

发布时间:2026-10-15 |
5人浏览过
本文详解Python爬虫中的三大核心要素:IP代理(透明、匿名、高匿)用于规避频率限制;Cookie机制解决HTTP无状态问题,通过MozillaCookieJar实现持久化存储;以及urllib.error模块对URLError和HTTPError的捕获与属性解析,帮助开发者构建稳定的网络请求程序。
1. IP代理
部分网站会监控特定IP在单位时间内的访问频次,若超出阈值则禁止访问。为此需配置代理服务器,并实现定期更换代理IP的策略。IP代理主要分为以下三类:
- ① 透明代理:目标网站能够识别使用了代理,并获取源IP地址,此类代理无法满足隐蔽需求;
- ② 匿名代理:目标网站知晓使用了代理,但无法获取源IP地址;
- ③ 高匿代理:最为安全的方式,目标网站既无法识别代理存在,也无法获取源IP地址。
2. Cookie
为了解决http协议的无状态特性,首次向服务器发起请求时,服务器会生成Cookie并将其作为请求头的一部分存储至浏览器中;后续浏览器再次发送请求时,将自动携带该Cookie信息。
import urllib.request
from http import cookiejar
filename = 'cookie.txt'
#获取Cookie
def get_cookie():
    #实例化一个MozillaCookieJar用于存储cookie
    cookie = cookiejar.MozillaCookieJar(filename)
    #创建handler对象
    handler = urllib.request.HTTPCookieProcessor(cookie)
    #创建opener对象
    opener = urllib.request.build_opener(handler)
    #请求网址
    url = 'https://tieba.baidu.com/index.html?traceid=#'
    resp = opener.open(url) #发送请求
    #存储cookie文件
    cookie.save()

#读取cookie
def use_cookie():
    #实例化MozillaCookieJar
    cookie = cookiejar.MozillaCookieJar()
    #加载cookie文件
    cookie.load(filename)
    print(cookie)

get_cookie()
use_cookie()
3. 异常处理
① urllib.error.URLError:用于捕获由urllib.request模块产生的异常,通过reason属性可获取具体的错误原因。
import urllib.request
import urllib.error

url = 'http://www.google.com'
try:
    resp = urllib.request.urlopen(url)
except urllib.error.URLError as e:
    print(e.reason)
输出结果示例:
[WinError 10060] 由于连接方在一段时间后没有正确答复或连接的主机没有反应,连接尝试失败。
② urllib.error.HTTPError:专门用于处理HTTP与HTTPS请求过程中出现的错误。
该异常对象包含三个关键属性:
code:请求返回的状态码reason:返回错误的具体原因headers:请求返回的响应头信息
import urllib.request
import urllib.error

url = 'https://movie.douban.com/'
try:
    resp = urllib.request.urlopen(url)
except urllib.error.HTTPError as e:
    print('原因:',e.reason)
    print('响应状态码:',str(e.code))
    print('响应头数据:',e.headers)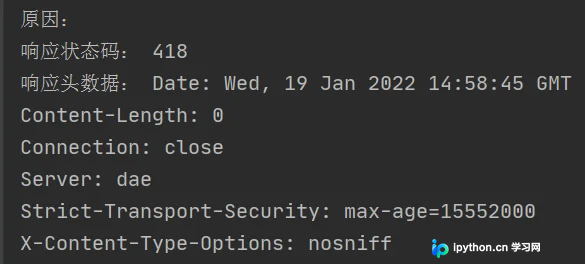
至此,关于Python爬虫网络请求中IP代理、Cookie及异常处理的内容介绍完毕。如需了解更多Python网络请求相关内容,请查阅本站往期文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















