


Python实现反向传播算法:原理、代码与实战详解

发布时间:2026-10-14 |
2人浏览过
本文深入解析神经网络中的反向传播算法,阐述其通过计算成本函数对权重和偏置的偏导数来优化模型的核心原理。结合Python代码示例,详细演示Sigmoid与ReLU激活函数的导数计算,并提供完整的BP算法实现案例,帮助开发者掌握深度学习的基础训练机制。
反向传播算法核心原理
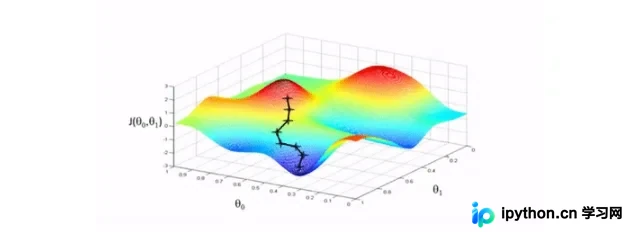
反向传播算法的核心目标在于计算成本函数C相对于网络中任意权重w或偏置b的偏导数。获取这些偏导数后,算法利用常数α(学习率)与偏导数的乘积来更新网络中的权重和偏差,这一过程构成了广泛使用的梯度下降算法。由于偏导数指示了成本函数增长最快的方向,反向传播通过沿此方向的反方向调整参数,从而最小化误差。
通过沿最大上升方向的相反方向移动,即最大下降方向,算法能够引导模型参数逐步逼近成本函数的局部最小值,从而实现模型的有效训练。
以下图示直观展示了反向传播过程中的数据流向与误差反向传递机制。
激活函数及其导数实现
在反向传播算法中,Sigmoid激活函数的实现及其导数计算至关重要。Sigmoid函数将输入映射到0到1之间,其导数用于计算梯度。
# 实现 sigmoid 函数
return 1 / (1 + np.exp(-x))
def sigmoid_derivative(x):
# sigmoid 导数的计算
return sigmoid(x)*(1-sigmoid(x))
ReLU(Rectified Linear Unit)函数的导数计算同样关键,它决定了正负区间的梯度传递。
def relu_derivative(x): # ReLU 函数的导数
d = np.array(x, copy=True) # 用于保存梯度的张量
d[x < 0] = 0 # 元素为负的导数为 0
d[x >= 0] = 1 # 元素为正的导数为 1
return d
为了更清晰地理解反向传播的实际应用,下面通过一个具体的Python实例进行扩展说明。
Python反向传播代码实战
以下是使用Python简单实现的BP(Backpropagation)反向传播算法代码,展示了从初始化到权重更新的全过程。
import numpy as np

# "pd" 偏导
def sigmoid(x):
  return 1 / (1 + np.exp(-x))

def sigmoidDerivationx(y):
  return y * (1 - y)


if __name__ == "__main__":
  #初始化
  bias = [0.35, 0.60]
  weight = [0.15, 0.2, 0.25, 0.3, 0.4, 0.45, 0.5, 0.55]
  output_layer_weights = [0.4, 0.45, 0.5, 0.55]
  i1 = 0.05
  i2 = 0.10
  target1 = 0.01
  target2 = 0.99
  alpha = 0.5 #学习速率
  numIter = 10000 #迭代次数
  for i in range(numIter):
    #正向传播
    neth1 = i1*weight[1-1] + i2*weight[2-1] + bias[0]
    neth2 = i1*weight[3-1] + i2*weight[4-1] + bias[0]
    outh1 = sigmoid(neth1)
    outh2 = sigmoid(neth2)
    neto1 = outh1*weight[5-1] + outh2*weight[6-1] + bias[1]
    neto2 = outh2*weight[7-1] + outh2*weight[8-1] + bias[1]
    outo1 = sigmoid(neto1)
    outo2 = sigmoid(neto2)
    print(str(i) + ", target1 : " + str(target1-outo1) + ", target2 : " + str(target2-outo2))
    if i == numIter-1:
      print("lastst result : " + str(outo1) + " " + str(outo2))
    #反向传播
    #计算w5-w8(输出层权重)的误差
    pdEOuto1 = - (target1 - outo1)
    pdOuto1Neto1 = sigmoidDerivationx(outo1)
    pdNeto1W5 = outh1
    pdEW5 = pdEOuto1 * pdOuto1Neto1 * pdNeto1W5
    pdNeto1W6 = outh2
    pdEW6 = pdEOuto1 * pdOuto1Neto1 * pdNeto1W6
    pdEOuto2 = - (target2 - outo2)
    pdOuto2Neto2 = sigmoidDerivationx(outo2)
    pdNeto1W7 = outh1
    pdEW7 = pdEOuto2 * pdOuto2Neto2 * pdNeto1W7
    pdNeto1W8 = outh2
    pdEW8 = pdEOuto2 * pdOuto2Neto2 * pdNeto1W8

    # 计算w1-w4(输出层权重)的误差
    pdEOuto1 = - (target1 - outo1) #之前算过
    pdEOuto2 = - (target2 - outo2) #之前算过
    pdOuto1Neto1 = sigmoidDerivationx(outo1)  #之前算过
    pdOuto2Neto2 = sigmoidDerivationx(outo2)  #之前算过
    pdNeto1Outh1 = weight[5-1]
    pdNeto2Outh2 = weight[7-1]

    pdEOuth1 = pdEOuto1 * pdOuto1Neto1 * pdNeto1Outh1 + pdEOuto2 * pdOuto2Neto2 * pdNeto1Outh1
    pdOuth1Neth1 = sigmoidDerivationx(outh1)
    pdNeth1W1 = i1
    pdNeth1W2 = i2
    pdEW1 = pdEOuth1 * pdOuth1Neth1 * pdNeth1W1
    pdEW2 = pdEOuth1 * pdOuth1Neth1 * pdNeth1W2
    pdNeto1Outh2 = weight[6-1]
    pdNeto2Outh2 = weight[8-1]
    pdOuth2Neth2 = sigmoidDerivationx(outh2)
    pdNeth2W3 = i1
    pdNeth2W4 = i2
    pdEOuth2 = pdEOuto1 * pdOuto1Neto1 * pdNeto1Outh2 + pdEOuto2 * pdOuto2Neto2 * pdNeto2Outh2
    pdEW3 = pdEOuth2 * pdOuth2Neth2 * pdNeth2W3
    pdEW4 = pdEOuth2 * pdOuth2Neth2 * pdNeth2W4
    #权重更新
    weight[1-1] = weight[1-1] - alpha * pdEW1
    weight[2-1] = weight[2-1] - alpha * pdEW2
    weight[3-1] = weight[3-1] - alpha * pdEW3
    weight[4-1] = weight[4-1] - alpha * pdEW4
    weight[5-1] = weight[5-1] - alpha * pdEW5
    weight[6-1] = weight[6-1] - alpha * pdEW6
    weight[7-1] = weight[7-1] - alpha * pdEW7
    weight[8-1] = weight[8-1] - alpha * pdEW8
    # print(weight[1-1])
    # print(weight[2-1])
    # print(weight[3-1])
    # print(weight[4-1])
    # print(weight[5-1])
    # print(weight[6-1])
    # print(weight[7-1])
    # print(weight[8-1])
至此,关于Python中反向传播算法的详细解析已介绍完毕。如需了解更多相关内容,建议查阅本站过往文章或继续浏览后续教程。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















