


Python urllib.request模块详解:从基础请求到高级处理器的完整指南

本文深入解析Python标准库urllib.request模块。详细讲解Request类的构造参数与数据编码,阐述Handler与Opener的协作机制。通过身份验证、代理配置及Cookie持久化(Mozilla与LWP格式)的完整代码示例,展示如何灵活构建HTTP请求处理器,适用于Python网络编程与爬虫开发场景。
Request参数详解
本节主要介绍Request()方法中涉及的各项参数。
import urllib.request
request=urllib.request.Request('https://python.org') response=urllib.request.urlopen(request) print(response.read().decode('utf-8'))
通过构建该数据结构,一方面可以将请求独立封装为对象,另一方面能够更加丰富且灵活地配置相关参数。
其构造方法如下所示:
class.urllib.request.Request(url,data=None,headers={},origin_rep_host=None,unverifiable=False,method=None)
参数说明:
1. url为必传参数。
2. data参数必须传递bytes类型数据。若传入字典,需先使用urllib.parse模块中的urlencode()函数进行转换。
3. headers参数为字典类型,用于设置请求头,可直接在构造时传入,或通过add_header()方法添加。
4. origin_rep_host用于指定请求方的名称或IP地址。
5. unverifiable默认为false,表示该请求是否无法验证。若抓取权限不足,该值将变为true。
6. method用于指示请求所使用的方法类型。
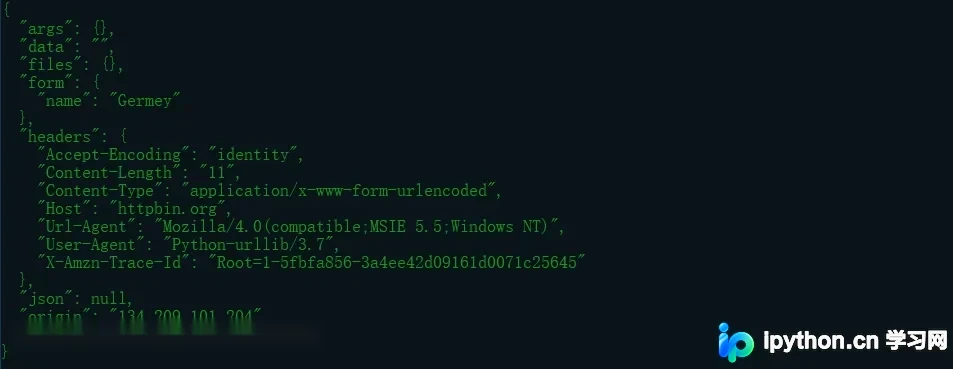
下面尝试传入多个参数来构建一个请求对象:
from urllib import request,parse

url='http://httpbin.org/post'
headers={
  'Url-Agent':'Mozilla/4.0(compatible;MSIE 5.5;Windows NT)',
  'Host':'httpbin.org'
}#也可以使用add_header()方法添加headers:#req=request.Request(url=url,data=data,method='POST')#req.add_header('User-Agent','Mozilla/4.0(compatible;MSIE 5.5;Windows NT)')
dict={
  'name':'Germey'
}
data=bytes(parse.urlencode(dict),encoding='utf-8')#用urlencode()将dict转换成bytes类型,传递给data
req=request.Request(url=url,data=data,headers=headers,method='POST')
response=request.urlopen(req)
print(response.read().decode('utf-8'))
运行结果如下:
Handler与Opener机制
接下来介绍Handler与Opener的相关概念。
Handler(处理器):
Handler是各种处理器的统称,几乎可以处理HTTP请求中的所有事务。
urllib.request模块中的BaseHandler类是所有其他Handler的父类,它提供了最基础的方法实现。
Opener(打开器):
例如urlopen()就是一个Opener,它是urllib库为我们提供的默认实现。
它们之间的关系是:使用Handler来构建Opener。
以下是具体的用法演示。
身份验证与代理配置
身份验证示例:
创建一个需要身份验证的网站环境,此处使用的是IIS服务器。
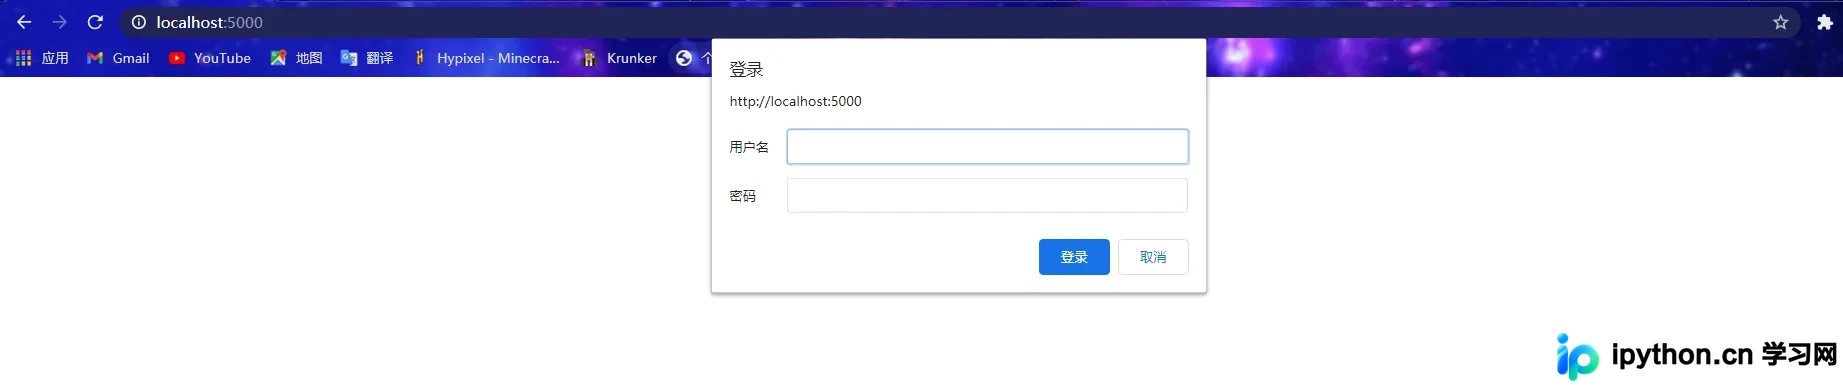
在配置过程中可能遇到的问题:
IIS怎样安装与配置-百度经验 (baidu.com)
IIS网站如何设置基本身份验证-百度经验 (baidu.com)
window10家庭版解决IIS中万维网服务的安全性中无Windows身份验证 - enjoryWeb - 博客园 (cnblogs.com)
相关实现代码如下:
from urllib.request import HTTPPasswordMgrWithDefaultRealm,HTTPBasicAuthHandler,build_opener
from urllib.error import URLError

username='username'#填上自己的用户名和密码
password='password'
url='http://localhost:5000/'

p=HTTPPasswordMgrWithDefaultRealm()
p.add_password(None,url,username,password)#添加用户名和密码,建立了一个处理验证的Handler
auth_handler=HTTPBasicAuthHandler(p)#基本认证
opener=build_opener(auth_handler)#利用Handler构建一个Opener

try:
  result=opener.open(url)#打开链接
  html=result.read().decode('utf-8')
  print(html)#结果打印html源码内容
except URLError as e:
  print(e.reason)
代理配置示例:
添加代理设置,在本地搭建一个代理服务,监听端口为9743。
相关实现代码如下:
from urllib.request import ProxyHandler,build_opener
from urllib.error import URLError

proxy_handler=ProxyHandler({
  'http':'http://127.0.0.1:9743',
  'https':'https://127.0.0.1:9743'
})#构建一个Handler
opener=build_opener(proxy_handler)#构建一个Opener
try:
  response=opener.open('https://www.baidu.com')
  print(response.read().decode('utf-8'))
except URLError as e:
  print(e.reason)
Cookie持久化与读取
Cookie处理示例:
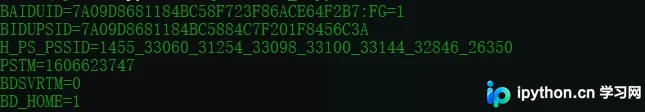
获取网站的Cookie信息:
相关实现代码如下:
import http.cookiejar,urllib.request

cookie=http.cookiejar.CookieJar()#声明一个CookieJar对象
handler=urllib.request.HTTPCookieProcessor(cookie)#构建一个Handler
opener=urllib.request.build_opener(handler)#构建一个Opener
response=opener.open('http://www.baidu.com')
for item in cookie:
  print(item.name+"="+item.value)
运行结果如下:
将Cookie保存为文件形式:
相关实现代码如下:
import http.cookiejar,urllib.request
filename='cookies.txt'
cookie=http.cookiejar.MozillaCookieJar(filename) #MozillaCookieJar()生成文件时用到,用来处理Cookie和文件相关的事件 #如果要保存LWP格式的Cookies文件,可以改为: #cookie=http.cookiejar.LWPCookieJar(filename)
handler=urllib.request.HTTPCookieProcessor(cookie) opener=urllib.request.build_opener(handler) response=opener.open('http://www.baidu.com') cookie.save(ignore_discard=True,ignore_expires=True)
运行结果如下:
# Netscape HTTP Cookie File
# http://curl.haxx.se/rfc/cookie_spec.html
# This is a generated file! Do not edit.

.baidu.com  TRUE  /  FALSE  1638359640  BAIDUID  9BB1BA4FDD840EBD956A3D2EFB6BF883:FG=1
.baidu.com  TRUE  /  FALSE  3754307287  BIDUPSID  9BB1BA4FDD840EBD25D00EE8183D1125
.baidu.com  TRUE  /  FALSE    H_PS_PSSID  1445_33119_33059_31660_33099_33101_26350_33199
.baidu.com  TRUE  /  FALSE  3754307287  PSTM  1606823639
www.baidu.com  FALSE  /  FALSE    BDSVRTM  7
www.baidu.com  FALSE  /  FALSE    BD_HOME  1
LWP格式示例:
#LWP-Cookies-2.0
Set-Cookie3: BAIDUID="DDF5CB401A1543ED614CE42962D48099:FG=1"; path="/"; domain=".baidu.com"; path_spec; domain_dot; expires="2021-12-01 12:04:18Z"; comment=bd; version=0
Set-Cookie3: BIDUPSID=DDF5CB401A1543ED00860C3997C3282C; path="/"; domain=".baidu.com"; path_spec; domain_dot; expires="2088-12-19 15:18:25Z"; version=0
Set-Cookie3: H_PS_PSSID=1430_33058_31254_33098_33101_33199; path="/"; domain=".baidu.com"; path_spec; domain_dot; discard; version=0
Set-Cookie3: PSTM=1606824257; path="/"; domain=".baidu.com"; path_spec; domain_dot; expires="2088-12-19 15:18:25Z"; version=0
Set-Cookie3: BDSVRTM=0; path="/"; domain="www.baidu.com"; path_spec; discard; version=0
Set-Cookie3: BD_HOME=1; path="/"; domain="www.baidu.com"; path_spec; discard; version=0
以LWP格式的文件为例,展示读取和利用的方法:
相关实现代码如下:
import http.cookiejar,urllib.request
cookie=http.cookiejar.LWPCookieJar() #如果文件保存为Mozilla型浏览器格式,可以改为: #cookie=http.cookiejar.MozillaCookieJar()
cookie.load('cookies.txt',ignore_discard=True,ignore_expires=True) #调用load()方法来读取本地的Cookies文件,获取Cookies的内容
handler=urllib.request.HTTPCookieProcessor(cookie) opener=urllib.request.build_opener(handler) response=opener.open('http://www.baidu.com') print(response.read().decode('utf-8'))
运行结果:输出网页源代码。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















