


Scrapy框架教程:构建大规模Python分布式爬虫项目

单机运行的 Scrapy 依赖本地内存管理调度队列,当面对千万级目标页面时,会受限于单台服务器的带宽、连接数与算力上限。构建大规模分布式爬虫项目的核心,在于剥离调度与去重逻辑,将其委托给共享的高性能缓存服务,让多台工作节点协同消费任务、上报数据。本文将从分布式调度机制、依赖环境搭建、核心代码改造、集群配置到节点部署与维护,完整演示标准分布式爬虫系统的搭建全流程。
分布式爬虫的核心运作原理
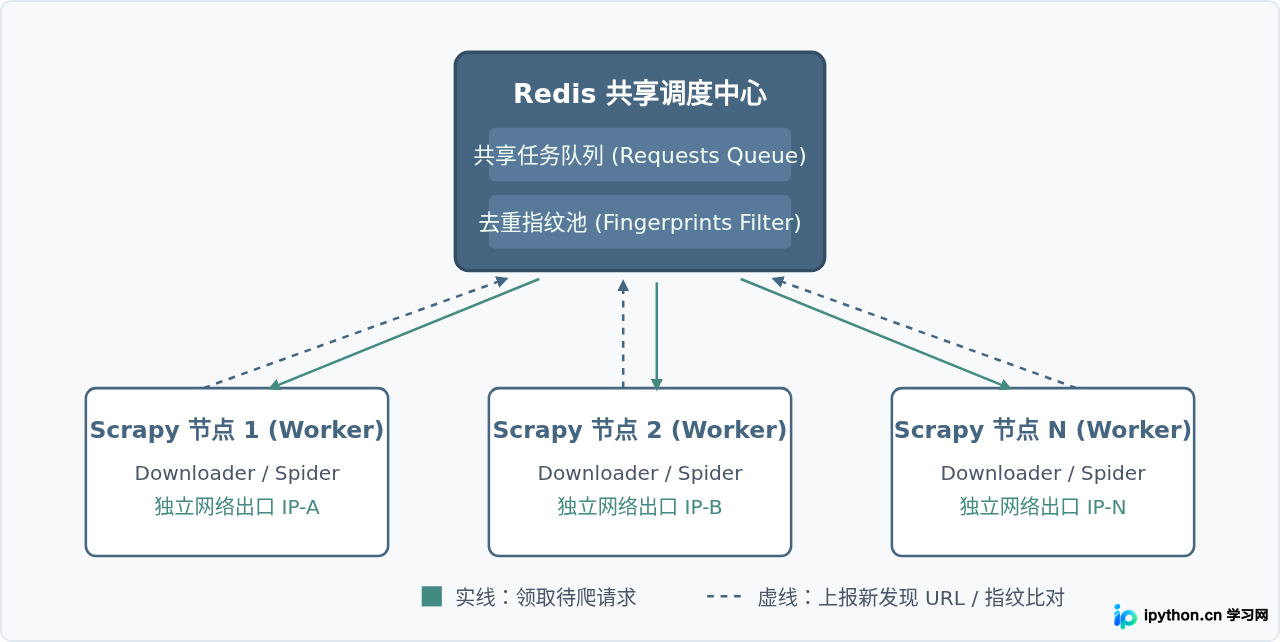
标准单机 Scrapy 架构中,Scheduler(调度器)负责维护请求队列,并在内存中通过集合进行指纹去重(RFPDupeFilter)。分布式架构的核心是将单节点的内存任务队列与去重集合移出,托管到公共的 Redis 实例中,最成熟的工程实践方案是结合 Scrapy-Redis 扩展。
在分布式模式下,主控节点或任意生成爬取任务的程序将初始 URL 写入 Redis 列表(List)或有序集合(ZSet)。所有接入同一 Redis 实例的 Scrapy Worker 节点共享该队列,按预定优先级弹出请求、下载网页、解析数据。当提取出新的链接时,再次经由公共 Redis 集合去重过滤,符合要求的新任务直接推回 Redis 调度池。解析产出的实体数据则按需导入持久化数据库。
项目初始化与依赖配置
在任意开发终端安装支持组件。需要确保 Python 运行环境为 3.8 及以上版本:
pip install scrapy scrapy-redis redis初始化基础工程骨架:
scrapy startproject distributed_crawler
cd distributed_crawler
scrapy genspider target_spider example.com
生成项目后,核心改造工作集中在两处:一是将爬虫主类的继承对象调整为分布式基类,二是在项目配置文件 settings.py 中替换原生的调度器与去重管道。
爬虫代码与配置改造
在普通爬虫中,爬虫类继承自 scrapy.Spider 或 CrawlSpider,初始请求从 start_urls 读取。在分布式场景中,应继承 scrapy_redis.spiders.RedisSpider,并将起始触发源换为 redis_key。爬虫启动后会处于常驻监听状态,随时等待 Redis 注入新种子。
修改 distributed_crawler/spiders/target_spider.py:
import scrapy
from scrapy_redis.spiders import RedisSpider

class TargetSpider(RedisSpider):
    name = "target_spider"

    # 动态监听的 Redis 队列键名,而非静态 start_urls
    redis_key = "target_spider:start_urls"

    def parse(self, response):
        # 提取目标数据
        for item_node in response.css("div.post-card"):
            title = item_node.css("h2.title::text").get()
            url = item_node.css("a::attr(href)").get()
            if title and url:
                yield {
                    "title": title.strip(),
                    "url": response.urljoin(url)
                }

        # 发现下一页并提交抓取(自动进入分布式去重与排队)
        next_page = response.css("a.next-page::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
紧接着,在 distributed_crawler/settings.py 中重构调度器组件,使节点脱离本地内存调度:
# 启用 Scrapy-Redis 去重过滤器与调度器
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 允许暂停与恢复:爬虫重启时不清理 Redis 中的待爬队列与去重集
SCHEDULER_PERSIST = True

# 队列优先级模式:默认为优先级队列 (SpiderPriorityQueue)
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderPriorityQueue"

# 配置 Redis 连接参数
REDIS_HOST = "192.168.1.100"  # 替换为主控 Redis 服务器的公网或内网 IP
REDIS_PORT = 6379
REDIS_PARAMS = {
    'password': 'YourSecurePasswordHere',
    'db': 0
}

# 管道配置:如果需要将抓取结果直接暂存至 Redis,可启用此 Pipeline
ITEM_PIPELINES = {
    'scrapy_redis.pipelines.RedisPipeline': 300,
}

# 大规模抓取时的限速与并发调优
CONCURRENT_REQUESTS = 32
DOWNLOAD_DELAY = 0.25
COOKIES_ENABLED = False
ROBOTSTXT_OBEY = False注意:生产环境中 Redis 绝不可在公网上处于无密码监听状态。除配置强密码外,应使用内网 VPC 或通过防火墙限制仅允许指定 Worker 节点 IP 访问 6379 端口。
从单机走向集群的操作步骤
将单机工程部署为多机集群协同作业,需要经历环境打包、节点同步、服务启动与种子注入四个标准阶段。
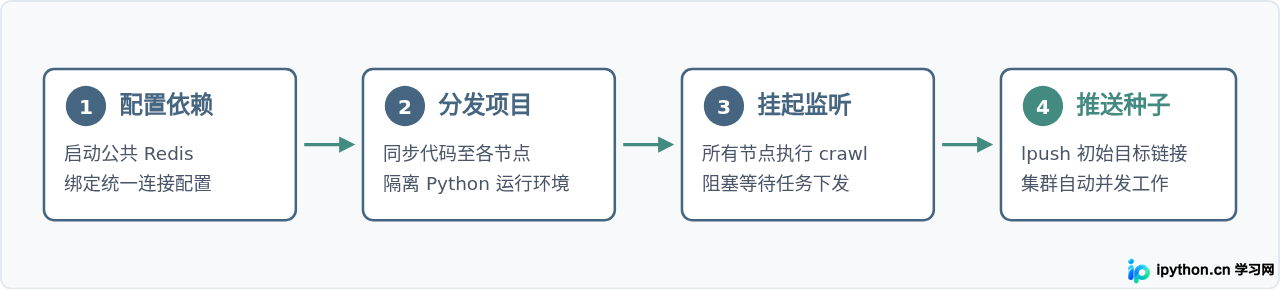
步骤一:分发代码至多台机器
保证所有 Worker 机器安装相同版本的 Python、Scrapy 和 Scrapy-Redis。通过 Git 或自动化工具拉取完全一致的爬虫代码。
步骤二:在所有节点启动爬虫
在每台服务器的工作目录下执行启动命令:
scrapy crawl target_spider此时控制台会输出日志并处于静默等待状态:
[scrapy_redis.spiders] Listening for blocks on 'target_spider:start_urls'这表明各节点已就绪,正在阻塞式拉取 Redis 队列。
步骤三:向 Redis 注入种子链接
进入 Redis 命令行工具 redis-cli,或者通过外部脚本向指定队列推入一个或多个种子 URL:
redis-cli -h 192.168.1.100 -a YourSecurePasswordHere
192.168.1.100:6379> lpush target_spider:start_urls "https://example.com/category/1"
种子注入后,某一个空闲节点会立即通过 RPOP 或 BLPOP 取得该任务并执行,随后抽取的新链接会自动在 Redis 中完成去重与分派,驱动整套集群协同运转。
大规模任务中的性能与稳定性保障
当分布式爬虫项目从几万测试抓取扩展到千万级别时,单靠加机器无法解决所有瓶颈。系统必须在内存占用、网络代理和防封策略上做针对性设计。
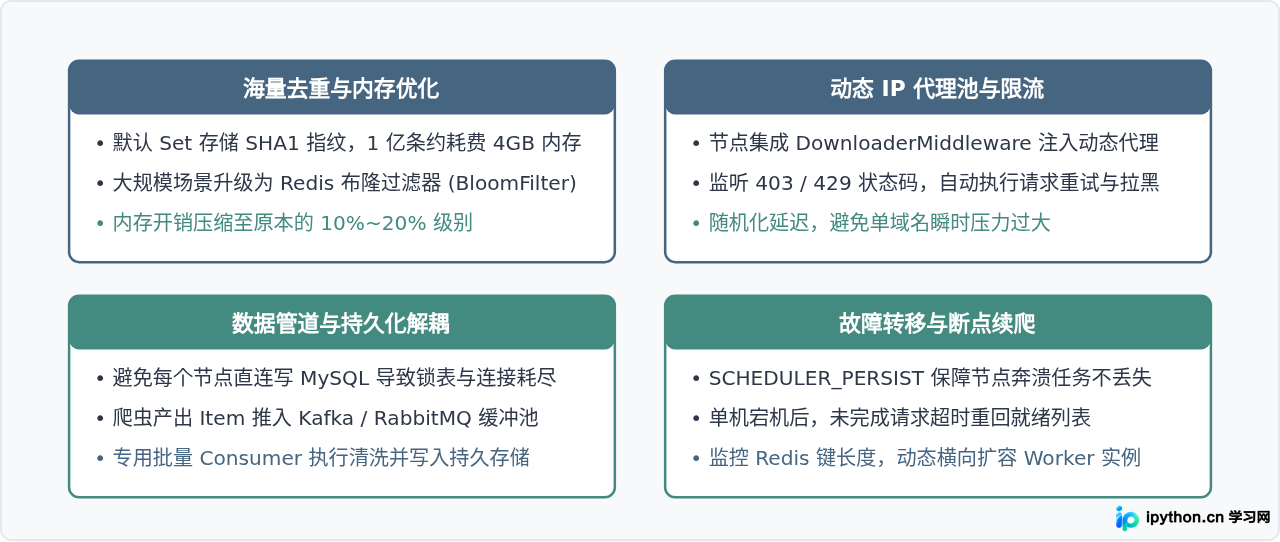
在海量数据采集项目中,通常会遇到以下三个核心技术瓶颈与解决方案:
- 去重指纹体积爆炸:Scrapy-Redis 默认采用 SHA1 计算 URL 指纹并放入 Redis Set。一个指纹占用几十个字节,上亿条记录将直接吞噬数吉字节的高速缓存。解决方式是替换为布隆过滤器(如集成
scrapy-redis-bloomfilter),在容忍微小误判率的前提下,节约 80% 以上的 Redis 内存消耗。 - 数据库写入阻塞:若每个 Worker 节点在 Item Pipeline 中直接同步写入关系型数据库(如 MySQL),并发过高会导致数据库连接池耗尽或死锁。规范做法是将数据打包抛入消息中间件(Kafka 或 Redis 队列),由独立的数据清洗服务执行批量异步写入。
- 网络封控应对:必须在中间件(Middleware)层集中实现动态 IP 轮换,并合理设置
DOWNLOAD_TIMEOUT(推荐 10~15 秒),防止无效连接长时间霸占 Twisted 事件循环通道。
项目全生命周期与实施总结
成功搭建分布式爬虫系统并不是单一代码仓库的调整,而是涵盖从基础架构到后期运维的完整闭环。
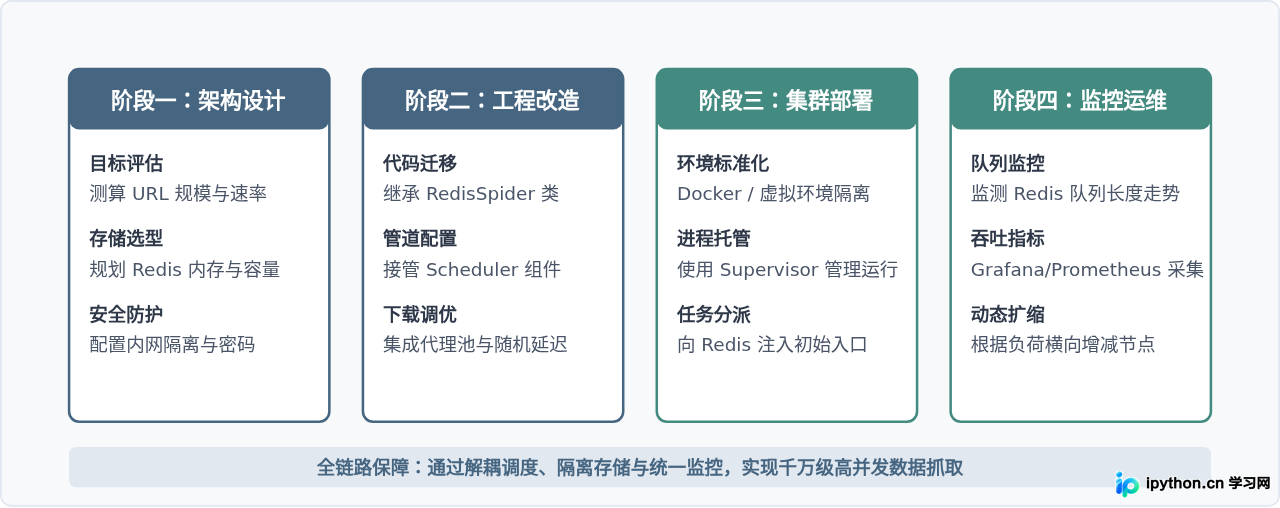
掌握了基于 Scrapy-Redis 的分布式核心后,项目可在任意时刻根据采集规模灵活扩容。新增机器只需要拉取代码、填入相同的 Redis 连接地址并启动 scrapy crawl,即可在秒级融入现有集群提供吞吐算力。结合合理的代理策略与异步存储,整套架构足以稳定应对企业级的大规模数据抓取需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















