


Scrapy框架实战:构建高效分布式Python新闻爬虫
深入讲解如何使用 Python Scrapy 框架与 Scrapy-Redis 组件构建高并发、高可用、可断点续爬的分布式新闻爬虫系统,包含架构解析、实战代码与运维调优。
单机网络爬虫在抓取高频更新、数据量庞大的现代新闻门户时,经常遭遇内存占用过高、网络请求瓶颈以及单点故障中断等现实问题。构建高效分布式新闻爬虫的根本路径,在于利用集中式的 Redis 数据库接管 Scrapy 原生的单机内存调度器与指纹去重机制,使分布在不同服务器上的多个爬虫节点协同工作、共享抓取任务并自动去重,从而在保障低延迟的同时实现数倍于单机的采集吞吐量。
一、从单机到分布式:新闻采集的核心痛点与架构跃迁
新闻类网站通常具备鲜明的内容特征:突发性快讯更新频繁、历史资讯归档量巨大、各垂直频道层级纵深分明。如果仅依靠单台机器运行 Scrapy,受限于单节点 CPU 核心数、出网带宽与内存容量,爬虫往往面临三个不可调和的矛盾:
- 内存瓶颈与数据丢失:Scrapy 默认将待抓取 Request 队列和已抓取 URL 指纹保存在本地内存中。当爬取规模达到数百万级新闻列表时,内存极易告罄;一旦进程崩溃,未完成的队列状态全部丢失。
- IP 频次限制与单点风险:单机出网 IP 固定,高频爬取新闻列表页极易触发目标服务器的防爬机制导致 IP 被封禁。此外,单台主机故障会导致整个采集链路全线中断。
- 算力与吞吐不可线性横向扩容:多台机器各自运行单机爬虫时,无法自动共享待抓取 URL,容易产生重复采集与资源浪费。
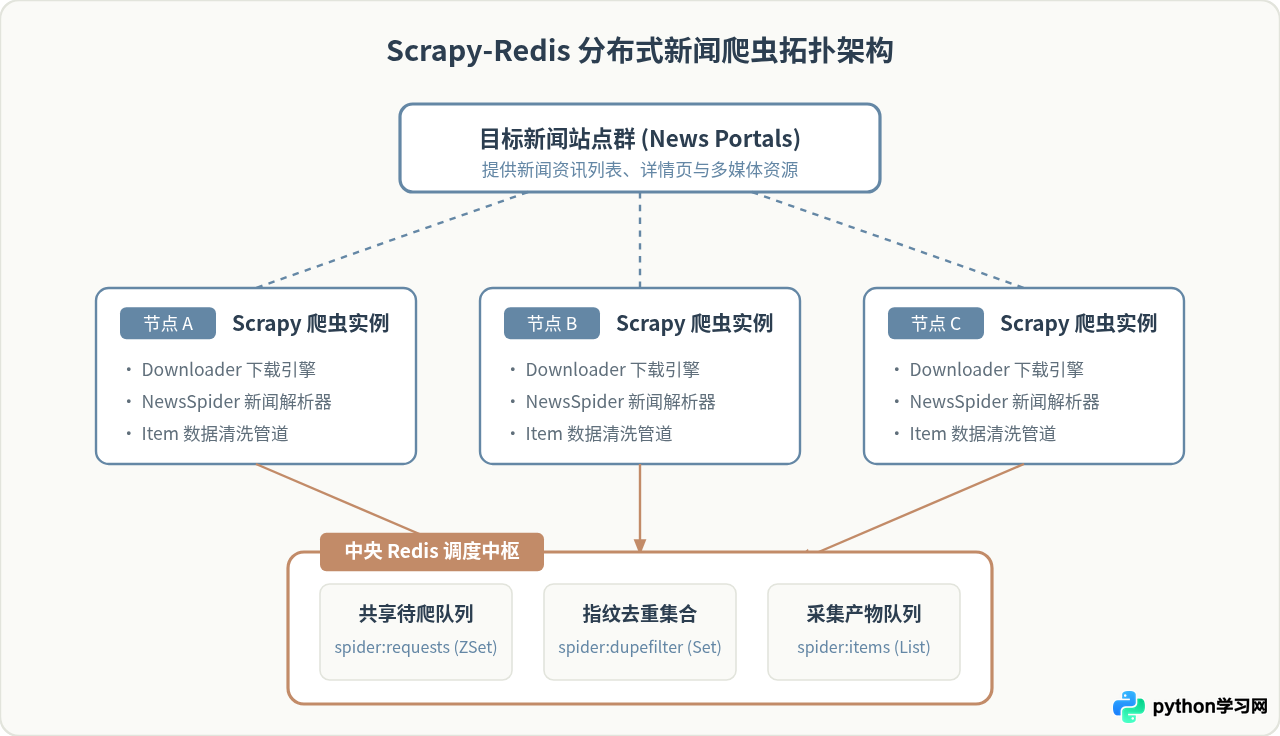
通过引入 Scrapy-Redis 扩展组件,可以将原生调度器改造成由 Redis 支持的集中式调度中枢。爬虫节点(Worker)只需专注负责页面下载与解析,所有的调度任务分发、URL 指纹去重及结构化数据临时暂存均由中央 Redis 完成,架构拓扑如下图所示。
二、核心机制:Redis 调度器与 URL 指纹去重原理
Scrapy-Redis 之所以能够无缝集成到现有 Scrapy 项目中,是因为它严格遵守了 Scrapy 内部组件的标准接口,重点重写了以下两个核心模块:
1. 分布式调度器 (Scheduler)
原生 Scrapy 调度器使用 Python 内存队列(如 collections.deque)存放待抓取请求。Scrapy-Redis 实现了自定义的 Scheduler 类,将内存队列替换为 Redis 数据结构:
- 优先队列 (SpiderPriorityQueue):默认采用 Redis 的
zset(有序集合)。请求的优先级priority作为 score,确保高权重的新闻快讯或一级频道首页优先被弹出抓取。 - 先进先出 / 后进先出 (SpiderQueue / SpiderStack):利用 Redis 的
list结构,支持广度优先或深度优先抓取策略。
2. SHA-1 指纹去重过滤器 (RFPDupeFilter)
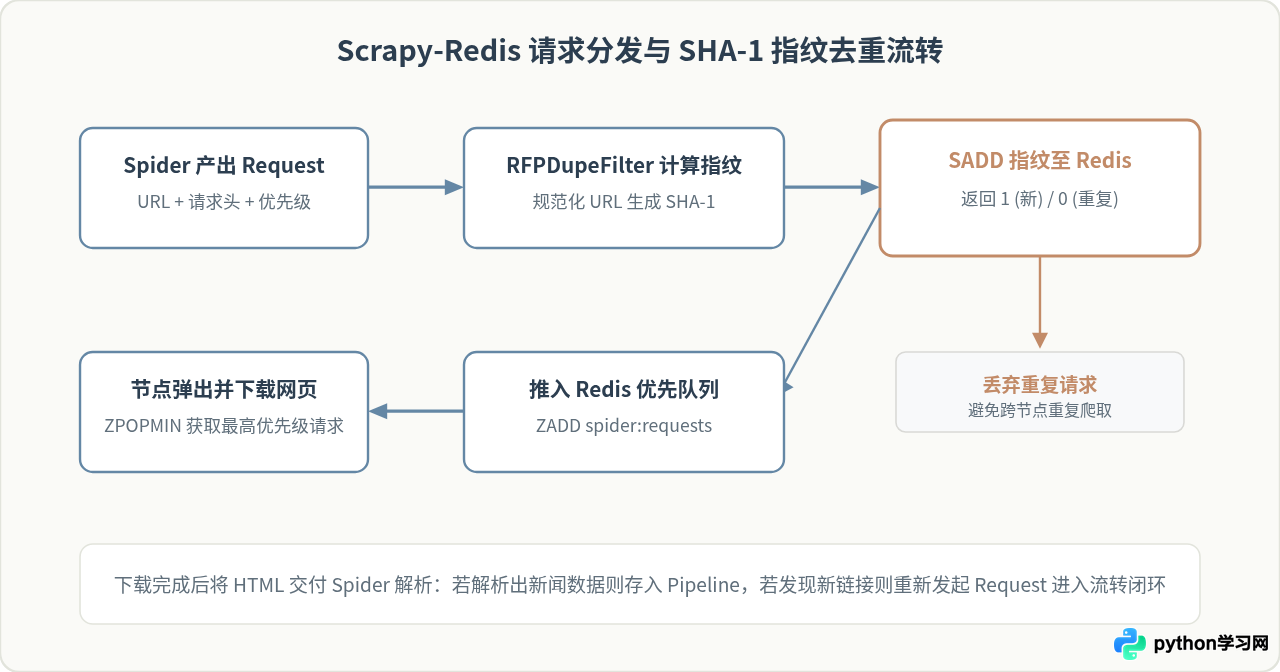
在分布式环境下,多个节点同时解析出同篇新闻链接时,必须在入队前被拦截。Scrapy-Redis 使用基于 Redis Set 的去重机制。其工作流程如下:
- 请求规范化:提取 Request 的 Method、标准化 URL(自动去除无序的 query 参数差异)以及 Request Body。
- 生成唯一哈希:对规范化文本计算 40 位的 SHA-1 十六进制摘要,即“请求指纹”。
- 原子性判断与记录:执行 Redis 的
SADD命令。若返回 1,说明该指纹尚未抓取过,请求被放行并推入待爬队列;若返回 0,说明已存在相同指纹,直接丢弃该重复请求。
三、实战步骤:四步搭建高可用分布式新闻爬虫
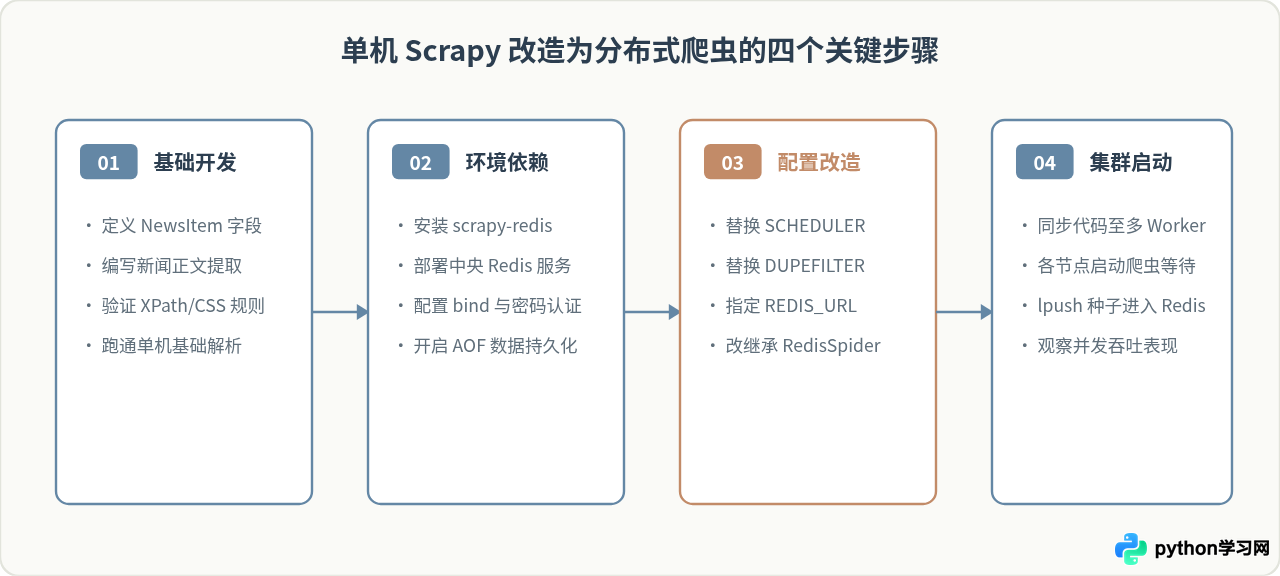
将单机 Scrapy 爬虫升级为分布式架构,遵循标准化的实施流程。整体步骤包括环境准备、爬虫与 Item 编写、全局配置切换以及多节点集群启动。
步骤 1:安装依赖与配置 Redis 服务器
在所有参与爬取的机器上安装 Scrapy 与 Scrapy-Redis:
pip install scrapy scrapy-redis redis准备一台专用的 Redis 服务器(建议内网环境),编辑 redis.conf 配置文件:
# 允许局域网内所有爬虫节点连接
bind 0.0.0.0

# 设置连接密码以保障数据安全
requirepass StrongNewsCrawlerAuthPass2026

# 开启 AOF 持久化,防止突发断电导致待爬队列丢失
appendonly yes
appendfsync everysec

# 建议配置合理的内存淘汰策略,避免内存溢出直接宕机
maxmemory 4gb
maxmemory-policy noeviction
步骤 2:定义新闻数据模型 (items.py)
新闻内容结构相对固定,包含标题、正文、发布时间、来源、作者及抓取时间戳等核心字段:
import scrapy

class NewsArticleItem(scrapy.Item):
    url = scrapy.Field()          # 新闻原文链接
    title = scrapy.Field()        # 新闻标题
    publish_time = scrapy.Field() # 发布时间
    source = scrapy.Field()       # 新闻来源媒体
    content = scrapy.Field()      # 正文清洗后的纯文本
    crawl_time = scrapy.Field()   # 采集入库时间
步骤 3:编写分布式爬虫 (news_redis_spider.py)
单机爬虫通常继承 scrapy.Spider 并显式指定 start_urls。而在分布式中,我们需要继承 scrapy_redis.spiders.RedisSpider,并将起始 URL 委托给 Redis 的动态键 redis_key:
import datetime
from scrapy_redis.spiders import RedisSpider
from news_crawler.items import NewsArticleItem

class DistributedNewsSpider(RedisSpider):
    name = "distributed_news"
    # 在 Redis 中等待种子任务的键名
    redis_key = "distributed_news:start_urls"

    def parse(self, response):
        """解析新闻列表页,提取新闻详情页链接并跟进"""
        # 提取当前列表页中的详情链接(以常见新闻列表为例)
        detail_links = response.xpath('//ul[@class="news-list"]//a/@href').getall()
        for link in detail_links:
            detail_url = response.urljoin(link)
            # 发起详情页抓取请求,由分布式调度器自动进行 SHA-1 去重
            yield response.follow(detail_url, callback=self.parse_detail)

        # 提取下一页链接继续爬取
        next_page = response.xpath('//a[contains(text(), "下一页")]/@href').get()
        if next_page:
            yield response.follow(response.urljoin(next_page), callback=self.parse)

    def parse_detail(self, response):
        """解析新闻详情页正文"""
        item = NewsArticleItem()
        item["url"] = response.url
        item["title"] = response.xpath('//h1/text()').get(default="").strip()
        item["publish_time"] = response.xpath('//span[@class="time"]/text()').get(default="").strip()
        item["source"] = response.xpath('//span[@class="source"]/text()').get(default="").strip()

        # 提取所有段落并清洗空格换行
        paragraphs = response.xpath('//div[@class="article-content"]//p//text()').getall()
        item["content"] = "\n".join([p.strip() for p in paragraphs if p.strip()])
        item["crawl_time"] = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")

        # 仅当标题和正文有效时产出数据
        if item["title"] and item["content"]:
            yield item
步骤 4:配置分布式核心参数 (settings.py)
编辑项目的 settings.py,替换 Scrapy 调度与去重核心组件,并指定 Redis 服务连接参数:
# 1. 替换 Scrapy 默认调度器为 Scrapy-Redis 调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 2. 替换默认去重过滤器为 Scrapy-Redis 过滤器
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 3. 设置队列持久化(任务中断后保留队列与指纹,支持断点续爬)
SCHEDULER_PERSIST = True

# 4. 设置默认调度队列类型(PriorityQueue 优先队列)
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderPriorityQueue"

# 5. 配置中央 Redis 连接串 (格式: redis://:password@host:port/db)
REDIS_URL = "redis://:StrongNewsCrawlerAuthPass2026@192.168.1.100:6379/0"

# 6. 配置 Item 管道(可选:将解析出的数据存入 Redis 列表供下游消费)
ITEM_PIPELINES = {
    "scrapy_redis.pipelines.RedisPipeline": 300,
}

# 7. 并发与限速调节
CONCURRENT_REQUESTS = 32
DOWNLOAD_DELAY = 0.25
COOKIES_ENABLED = False
ROBOTSTXT_OBEY = False
步骤 5:启动集群并注入初始任务
在所有 Worker 服务器节点上,进入爬虫工程目录并启动爬虫进程:
scrapy crawl distributed_news启动后,由于尚未提供起始 URL,终端会显示 Listening to key: distributed_news:start_urls 并进入静默监听状态。此时,在任意一台能够访问 Redis 的机器上使用 redis-cli 注入新闻列表页起始种子:
redis-cli -h 192.168.1.100 -a StrongNewsCrawlerAuthPass2026 lpush distributed_news:start_urls "https://news.example.com/finance" "https://news.example.com/tech"Redis 监听到新推入的 URL 后,各 Worker 节点将立即并发拉取任务,自动分配抓取并执行协同采集。
四、生产级优化:反爬绕过、限速与断点续爬
在新闻网站的高并发分布式采集场景下,仅完成代码联调并不足以支撑长期稳定运行。必须在反爬穿透、速度协调与故障容灾方面采取针对性策略:
1. 动态代理 IP 池集成
高并发访问新闻列表极易导致 IP 被封。通过编写自定义 DownloaderMiddleware,在请求发送前动态注入代理 IP:
import random

class DistributedProxyMiddleware:
    def __init__(self, proxy_pool):
        self.proxy_pool = proxy_pool

    @classmethod
    def from_crawler(cls, crawler):
        # 可从 settings 或 Redis 中拉取活跃代理池
        return cls(crawler.settings.get("PROXY_LIST", []))

    def process_request(self, request, spider):
        if self.proxy_pool:
            selected_proxy = random.choice(self.proxy_pool)
            request.meta["proxy"] = selected_proxy
            # 标记代理重试次数上限
            request.meta["download_timeout"] = 8
2. 自适应限速控制 (AutoThrottle)
不同新闻网站服务器承载能力差异巨大。开启 Scrapy 的 AutoThrottle 机制,能够根据目标服务器的响应延迟自动动态调整抓取速率:
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 0.5
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 2.0
3. 断点续爬与容灾机制
SCHEDULER_PERSIST = True。当某个 Worker 节点因内存耗尽、操作系统更新或网络抖动崩溃时,Redis 中存储的请求队列与已爬指纹集合完全不受影响。新节点启动或旧节点重启后,会无缝接管剩余队列继续抓取,既不会漏抓,也不会重复请求已入库新闻。
五、生产环境运维与常见故障排查
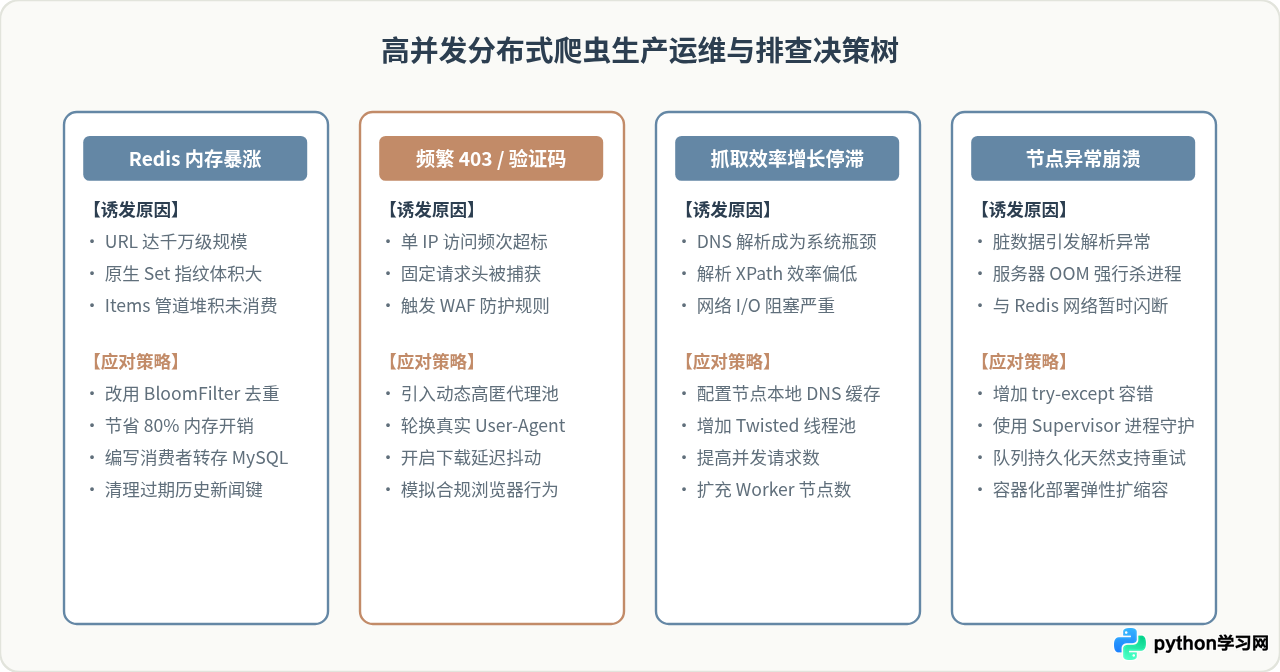
分布式新闻爬虫在长周期运行过程中,常面临 Redis 内存增长、网络波动及反爬封锁等挑战。运维排查路径与调优策略如下图决策矩阵所示:
六、总结与选型建议
构建基于 Scrapy-Redis 的分布式新闻爬虫,本质上是通过集中式的共享存储解决爬虫协同过程中的状态共享与数据去重问题。在实际工程落地中,应关注以下几个核心原则:
- 小步改造:优先在单机上完整跑通新闻列表与正文的清洗逻辑,确认字段提取稳定后再接入 Redis 分布式组件。
- 去重成本平衡:对于千万级以下的新闻采集任务,Scrapy-Redis 原生的 Set 去重性能稳定且实现直接;当目标量级上升至亿级网页时,应升级为布隆过滤器(BloomFilter)以防止 Redis 内存耗尽。
- 计算与存储解耦:爬虫节点专注于页面的下载、清洗与结构化抽取,解析完成的数据及时推入持久化存储(如 PostgreSQL、MongoDB 或 ElasticSearch),避免在 Redis 内存中长时间积压原始大对象。
遵循上述架构与实践规范,能够构建起兼具高并发吞吐能力与强容灾特性的现代化分布式 Python 新闻爬虫系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















