


使用Scrapy框架构建高效Python数据抓取项目:从安装到分布式部署
本文系统讲解如何使用Scrapy框架构建稳定、高效的Python数据抓取项目。内容涵盖虚拟环境搭建、项目骨架初始化、数据提取与清洗管道编写、中间件反爬调优,以及基于Redis的分布式集群部署与运维实践。
在面对大规模网页数据抽取需求时,基于常规单线程循环请求的脚本往往因网络阻塞、内存管理失当及容错不足而难以维系。Scrapy作为基于Twisted异步事件驱动架构构建的高性能爬虫框架,通过非阻塞IO、内置调度器与管道机制,能够以极低的资源开销实现高并发吞吐。本文将详细演示如何规范搭建Scrapy开发环境,完成从爬虫逻辑设计、数据清洗持久化到中间件反爬配置的全流程,并最终落地基于Redis的分布式集群部署方案。
一、Scrapy核心架构与事件驱动原理
要构建高效、低故障的抓取项目,首先需要厘清Scrapy各核心组件的职能及其协同机制。Scrapy并非单向线性的同步请求链,而是围绕引擎(Scrapy Engine)运转的高并发事件分发中枢。
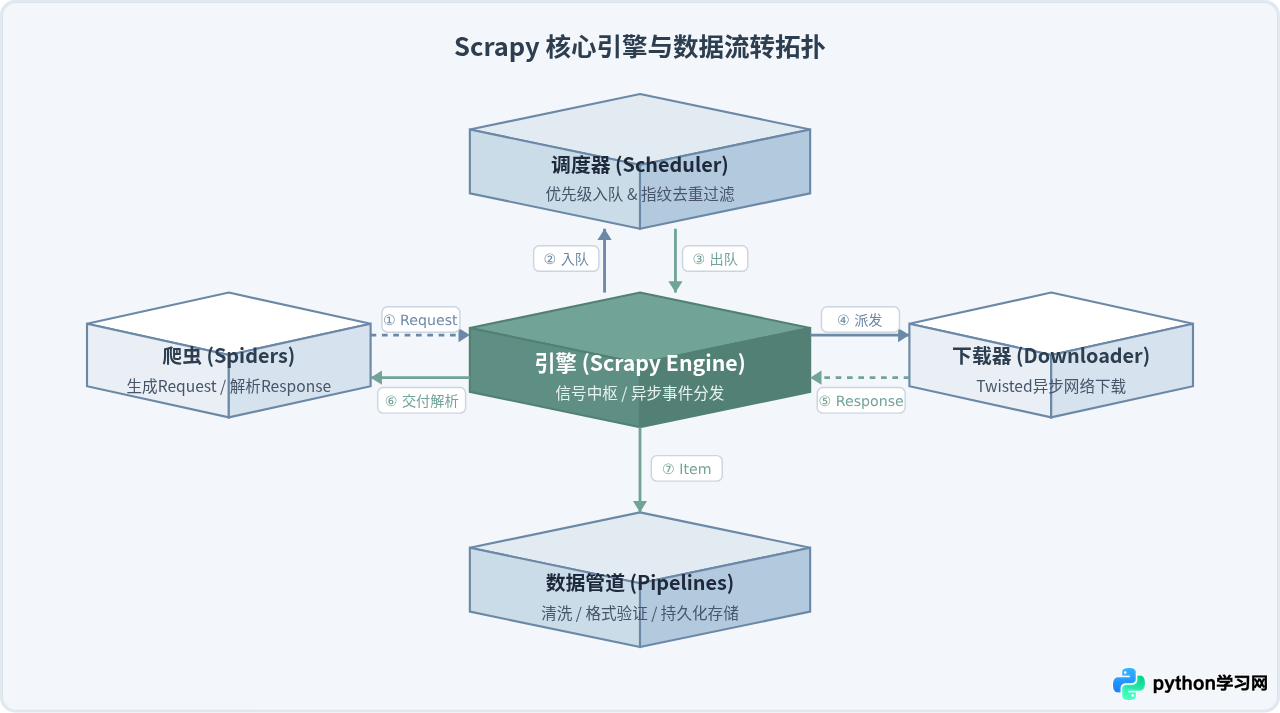
在整个生命周期中,各个组件各司其职:
- Scrapy Engine(引擎):控制整个系统的数据流,并在特定动作发生时触发系统事件。
- Scheduler(调度器):接收引擎发送的Request请求,将它们排入优先级队列,并在引擎空闲时弹出下一个待抓取请求。调度器内部维护指纹去重集合,自动丢弃重复请求。
- Downloader(下载器):基于Twisted非阻塞套接字下载网页内容,将HTML响应打包为Response对象交还给引擎。
- Spiders(爬虫逻辑):由开发者定制,负责解析Response、抽取有效字段生成Item,或进一步提取新的URL并生成后续Request。
- Item Pipeline(数据管道):对Spider产出的Item进行集中清洗、格式校验、去重及存储(如写入文件或数据库)。
二、开发环境准备与脚手架搭建
在开始编写抓取代码前,需建立隔离的Python运行环境,避免不同项目间的C扩展模块(如lxml或cryptography)版本冲突。
1. 虚拟环境配置与依赖安装
在终端中执行以下命令创建独立虚拟环境并安装Scrapy:
# 创建工作目录并进入
mkdir -p ~/spider_workspace && cd ~/spider_workspace

# 创建基于Python 3的虚拟环境
python3 -m venv venv

# 激活虚拟环境
source venv/bin/activate

# 升级pip并安装Scrapy
pip install --upgrade pip
pip install scrapy注意:在Linux系统(如Ubuntu/Debian)上,若编译依赖报错,通常是由于缺失底层开发库,可通过 sudo apt-get install python3-dev libxml2-dev libxslt1-dev zlib1g-dev libffi-dev libssl-dev 安装必备系统库后再执行pip安装。
2. 初始化Scrapy工程与项目结构
通过Scrapy官方命令行工具生成标准骨架项目:
# 创建名为 quote_crawler 的项目
scrapy startproject quote_crawler
cd quote_crawler

# 自动生成针对目标站点的Spider文件
scrapy genspider quotes quotes.toscrape.com
创建完成后的标准项目目录树如下所示:
quote_crawler/
├── scrapy.cfg            # 项目部署与配置入口
└── quote_crawler/
    ├── __init__.py
    ├── items.py          # 抓取数据模型定义(数据结构)
    ├── middlewares.py    # 爬虫与下载器中间件(代理、UA处理)
    ├── pipelines.py      # 数据清洗与入库管道
    ├── settings.py       # 运行参数、并发及速率控制
    └── spiders/          # 爬虫核心逻辑目录
        ├── __init__.py
        └── quotes.py     # 自动生成的Spider类
三、核心采集逻辑:从数据建模到管道清洗
掌握标准五步操作法,能够确保项目代码在扩展性、健壮性和维护性方面达到工程规范。
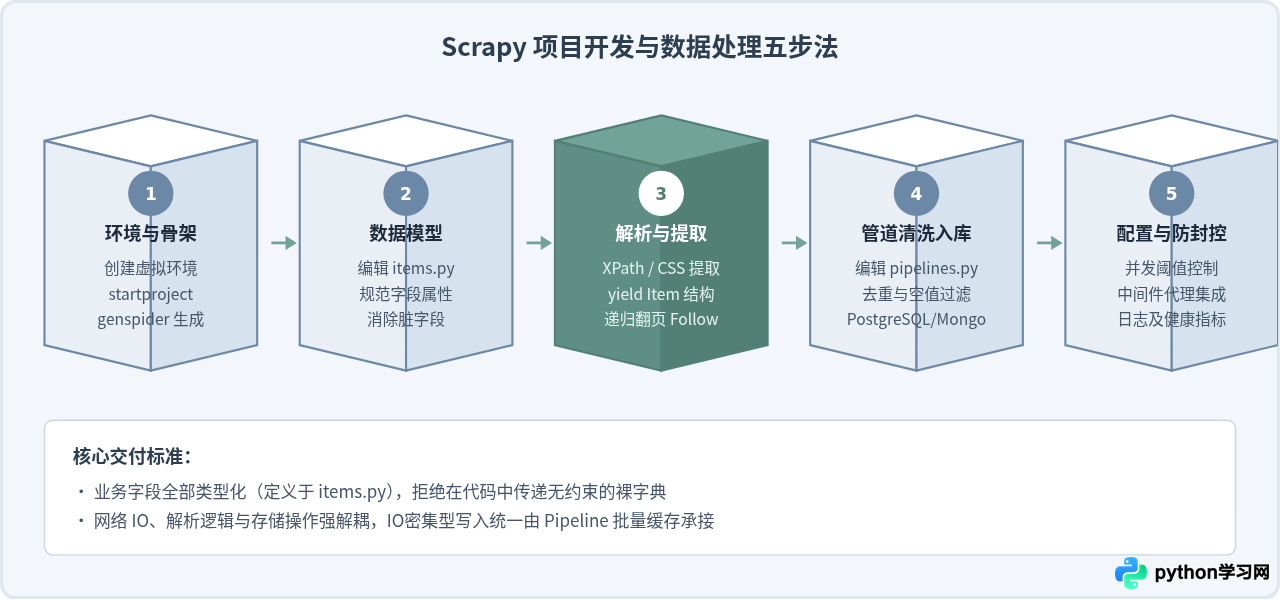
1. 定义数据结构(items.py)
在 quote_crawler/items.py 中定义结构化字段,避免在代码流转中任意混用字典键名:
import scrapy

class QuoteItem(scrapy.Item):
    text = scrapy.Field()      # 名言正文
    author = scrapy.Field()    # 作者姓名
    tags = scrapy.Field()      # 标签列表
    crawl_time = scrapy.Field() # 抓取时间戳
2. 编写Spider解析逻辑(spiders/quotes.py)
在 Spider 中实现页面字段抽取、Item 生成及下一页递归跟踪:
import scrapy
from datetime import datetime
from quote_crawler.items import QuoteItem

class QuotesSpider(scrapy.Spider):
    name = "quotes"
    allowed_domains = ["quotes.toscrape.com"]
    start_urls = ["https://quotes.toscrape.com/"]

    def parse(self, response):
        # 遍历页面中的所有名言卡片
        quotes = response.css("div.quote")
        for q in quotes:
            item = QuoteItem()
            item["text"] = q.css("span.text::text").get(default="").strip("“”")
            item["author"] = q.css("small.author::text").get(default="").strip()
            item["tags"] = q.css("div.tags a.tag::text").getall()
            item["crawl_time"] = datetime.utcnow().isoformat()
            yield item

        # 提取下一页链接并自动发起后续请求
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            yield response.follow(next_page, callback=self.parse)
3. 实现数据清洗与存储管道(pipelines.py)
数据可能包含脏字符或重复项。在 quote_crawler/pipelines.py 中编写管道对数据进行规范化:
import json
from scrapy.exceptions import DropItem

class CleanAndValidatePipeline:
    def process_item(self, item, spider):
        # 丢弃文本为空的无效数据
        if not item.get("text"):
            raise DropItem(f"缺失必要正文数据: {item}")

        # 清洗特殊空白符
        item["text"] = " ".join(item["text"].split())
        return item

class JsonLinesExportPipeline:
    def open_spider(self, spider):
        self.file = open("quotes_cleaned.jsonl", "a", encoding="utf-8")

    def close_spider(self, spider):
        self.file.close()

    def process_item(self, item, spider):
        line = json.dumps(dict(item), ensure_ascii=False) + "\n"
        self.file.write(line)
        return item
四、网络调优与防封控策略(Middlewares与Settings)
未经调优的爬虫可能会以极高频率冲击目标服务器,导致触发对方防火墙规则被封禁IP。合理的策略是在提升整体下载吞吐的同时,模拟自然流量特征。
1. 关键参数调优(settings.py)
# 1. 并发调控:单引擎全局最大并发请求数
CONCURRENT_REQUESTS = 32

# 2. 单域名并发限制(避免单站点击穿)
CONCURRENT_REQUESTS_PER_DOMAIN = 16

# 3. 下载超时设定(防止阻塞在慢速连接)
DOWNLOAD_TIMEOUT = 15

# 4. 禁用Cookies(若无需登录态,能降低被追踪特征)
COOKIES_ENABLED = False

# 5. 自动限速扩展(根据对方服务器响应延迟动态调速)
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 1.0
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 2.0

# 6. 激活自定义数据管道
ITEM_PIPELINES = {
    "quote_crawler.pipelines.CleanAndValidatePipeline": 300,
    "quote_crawler.pipelines.JsonLinesExportPipeline": 400,
}
2. 自定义 Downloader Middleware 实现代理池轮换
在 quote_crawler/middlewares.py 中定义代理中转层:
import random

class RandomProxyMiddleware:
    def __init__(self, proxy_list):
        self.proxy_list = proxy_list

    @classmethod
    def from_crawler(cls, crawler):
        # 从 settings 读取配置的代理池列表
        proxies = crawler.settings.getlist("PROXY_POOL", [
            "http://10.0.0.101:8080",
            "http://10.0.0.102:8080",
            "http://10.0.0.103:8080"
        ])
        return cls(proxies)

    def process_request(self, request, spider):
        # 为每个外发请求分配动态代理
        proxy = random.choice(self.proxy_list)
        request.meta["proxy"] = proxy
五、架构演进:基于 Redis 的分布式集群部署
当抓取规模达到千万级或亿级页面时,单台主机的 CPU、内存带宽和出口 IP 资源将成为系统硬瓶颈。分布式架构的核心思想是将原本存储在单机内存中的“待爬取队列(Request Queue)”和“已访问指纹库(Fingerprint Dupefilter)”剥离出来,统一迁移到外部高性能内存键值数据库(Redis)中。
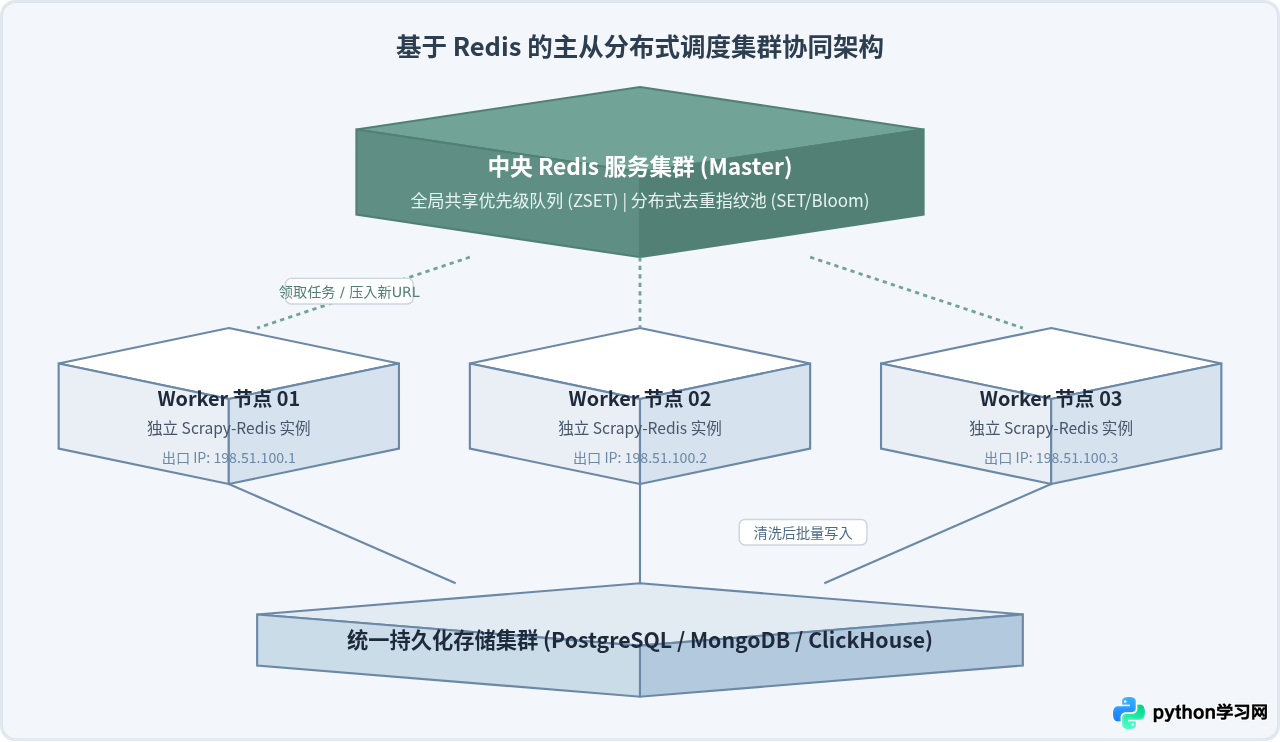
1. 引入 Scrapy-Redis 核心依赖
在各节点均安装扩展包:
pip install scrapy-redis redis2. 修改 Spider 继承体系
将传统的 scrapy.Spider 替换为 RedisSpider(或 RedisCrawlSpider),爬虫将不再通过静态属性 start_urls 读取入口,而是动态监听 Redis 中的种子键:
from scrapy_redis.spiders import RedisSpider
from quote_crawler.items import QuoteItem

class QuotesDistributedSpider(RedisSpider):
    name = "quotes_distributed"
    # 替换静态 start_urls,监听 Redis 中的种子列表键
    redis_key = "quotes:start_urls"

    def parse(self, response):
        for q in response.css("div.quote"):
            item = QuoteItem()
            item["text"] = q.css("span.text::text").get(default="").strip("“”")
            item["author"] = q.css("small.author::text").get(default="").strip()
            item["tags"] = q.css("div.tags a.tag::text").getall()
            yield item

        next_page = response.css("li.next a::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
3. 配置分布式调度器与去重器(settings.py)
# 启用 Scrapy-Redis 提供的调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 启用 Scrapy-Redis 提供的全局指纹去重器
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 爬取完成后是否持久化保留队列与指纹(True表示支持断点续爬,False表示运行结束后清空)
SCHEDULER_PERSIST = True

# 调度队列顺序:优先队列(默认)、先进先出队列或后进先出队列
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.PriorityQueue"

# 配置集中式 Redis 连接地址
REDIS_URL = "redis://:YourStrongPassword@192.168.1.100:6379/0"

# 将输出的 Item 发送给 Redis(可选:若统一在Redis暂存后消费入库)
# ITEM_PIPELINES = {
#     'scrapy_redis.pipelines.RedisPipeline': 300,
# }
4. 分布式任务启动与分发
在各个服务器节点(Worker 01, Worker 02 ...)上分别启动抓取进程:
# 在各 Worker 节点上执行(此时爬虫处于阻塞监听状态)
scrapy crawl quotes_distributed
在控制机或运维主机上,向 Master Redis 压入起始种子 URL,所有处于空闲等待状态的节点将同时开始消费并并行拉取:
# 使用 redis-cli 向对应键推入起始 URL
redis-cli -h 192.168.1.100 -a YourStrongPassword lpush quotes:start_urls https://quotes.toscrape.com/
六、生产级性能调优与运维监控总结
在生产环境下保障分布式爬虫长周期稳定运转,需在并发调优、异常熔断、资源监控三个维度制定清晰的规范。
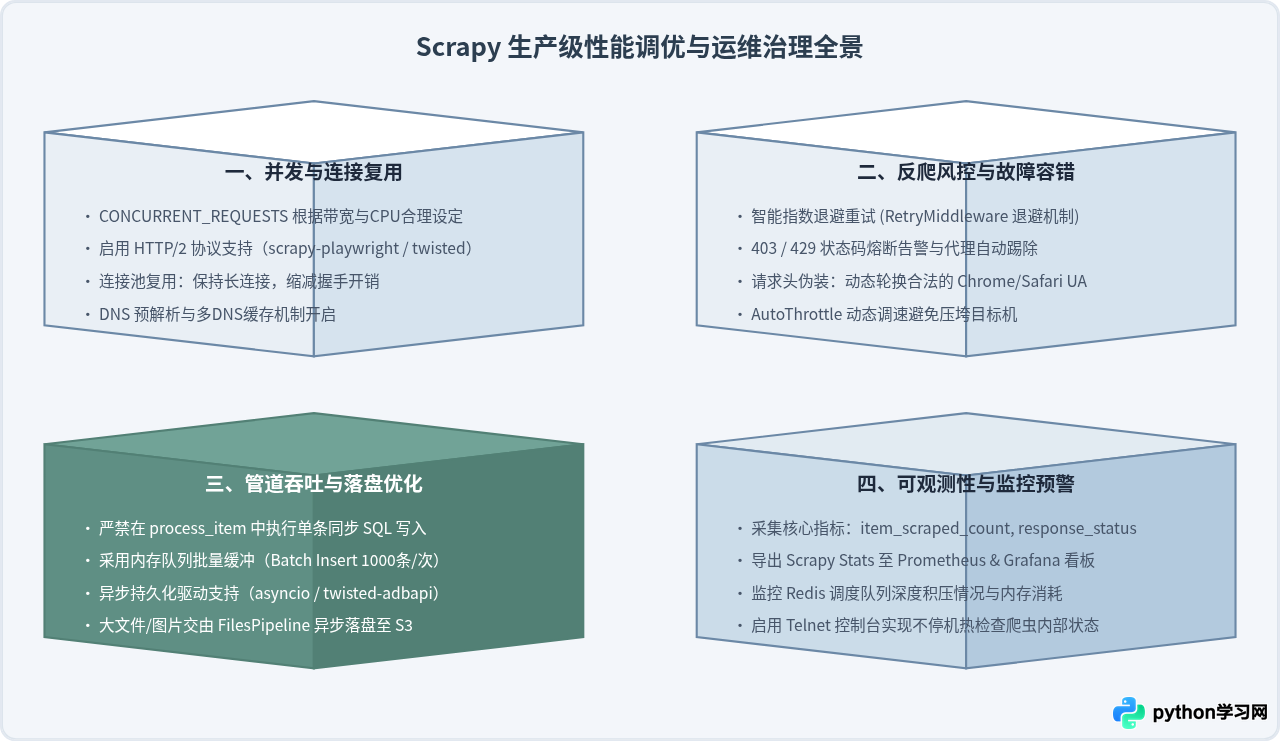
常见问题与排错指引
| 故障表现 | 可能根因 | 针对性解决方案 |
|---|---|---|
403 Forbidden |
缺失合法 User-Agent、缺少必要 Referer,或单个出口 IP 请求频率超出目标限制。 | 在中间件中增加随机请求头,接入轮换代理池,并调低单个域名的并发上限。 |
| 内存持续上涨不释放 | 在 Spider 或全局闭包中堆积了未释放的大型 Response 对象;或异步回调引用了过长的请求链路。 | 使用 scrapy.utils.trackref 排查驻留对象,避免在 Request 的 meta 中传递未序列化的大型数据实体。 |
| 数据抓取速度逐渐降低 | 数据库单条同步写入耗尽数据库连接池;或目标网站根据连接特征开启了慢速响应降级。 | 在 Pipeline 中引入批量缓存写入机制(如每次积攒500条或间隔2秒执行一次写入),启用 AutoThrottle 自动平抑速度。 |
| Redis 队列积压且指纹库过大 | URL 参数包含无序时间戳导致每次哈希指纹均不一致,进而使去重器失效。 | 在入队前规范化 URL(剥离无用跟踪参数 utm_* 及时间戳),海量规模下将 RFPDupeFilter 替换为布隆过滤器(BloomFilter)。 |
通过合理结合 Scrapy 核心架构设计、精细化管道清洗与 Redis 分布式调度改造,数据抓取工程能够平稳应对从万级到亿级的高并发吞吐挑战,同时兼备极佳的容错与横向扩展能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















