


Python 使用 chunksize 参数逐块读取大型 CSV 文件

本文介绍如何利用 pandas 的 read_csv 函数中的 chunksize 参数,实现对大型 CSV 文件的逐块读取与处理。通过示例代码演示了 TextParser 对象的迭代使用、Series 对象的 value_counts 统计以及 add 方法的累加合并技巧,有效解决内存溢出问题,适用于海量数据清洗与分析场景。
背景
在《利用Python进行数据分析》第6章关于数据加载的操作 read_xxx 中,提到了一个关键参数 chunksize,该参数支持对数据进行分块加载处理。
经过实际测试,该机制的核心逻辑是将文本文件分割为多个数据块,每次仅读取并处理 chunksize 行的数据。处理完成后,系统会返回一个 TextParser 对象。通过对该对象进行迭代遍历,可以实现对分块数据的统计与合并处理。
示例代码
以下是对文中示例代码的详细分析:
from pandas import DataFrame,Series
import pandas as pd

path='D:/AStudy2018/pydata-book-2nd-edition/examples/ex6.csv'
# chunksize return TextParser
chunker=pd.read_csv(path,chunksize=1000)

# an array of Series
tot=Series([])
chunkercount=0
for piece in chunker:
	print '------------piece[key] value_counts start-----------'
	#piece is a DataFrame,lenth is chunksize=1000,and piece[key] is a Series ,key is int ,value is the key column
	print piece['key'].value_counts()
	print '------------piece[key] value_counts end-------------'
	#piece[key] value_counts is a Series ,key is the key column, and value is the key count
	tot=tot.add(piece['key'].value_counts(),fill_value=0)
	chunkercount+=1

#last order the series
tot=tot.order(ascending=False)
print chunkercount
print '--------------'
流程分析
首先,示例数据文件 ex6.csv 包含总共 10000 行数据。当调用 chunksize=1000 参数后,read_csv 函数返回一个 TextParser 对象。该对象共包含10个元素,通过遍历过程中打印变量 chunkercount 可以验证这一结果。
其次,在迭代过程中,每个 piece 对象实际上是一个 DataFrame 对象。通过访问 piece['key'] 获取的是一个 Series 对象,其默认采用数值索引,对应的值为 CSV 文件中 key 列的具体字符串内容。
接着,将每个 Series 对象的 value_counts 结果视为一个独立的 Series,并与上一轮统计得到的 tot 结果执行 add 操作。通过这种方式,最终汇总计算出所有数据块中各个 key 的累加值。
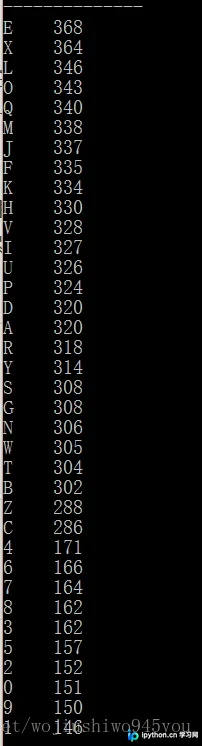
最后,对累加结果 tot 执行 order 排序操作,按降序排列,从而得出各个 key 在 CSV 文件中出现的总频次。
此处的巧妙之处在于使用了 Series 对象的 add 方法。当对两个 Series 执行 add 操作时,系统会自动合并具有相同 key 的记录,将对应值累加;对于不存在的 key,则设置填充值为 0,确保了统计的完整性。
最终输出结果如下:
至此,关于 Python 数据分析中利用 chunksize 逐块读取文本的实现方法介绍完毕。如需了解更多 Python 分块读取文本的相关内容,建议查阅本站过往文章或继续浏览后续技术分享,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















