


Pandas缺失数据处理全解:统计、删除、填充与插值

本文系统讲解Pandas中缺失数据的处理流程。涵盖isna/isnull统计逻辑、dropna删除策略及thresh参数、fillna填充方法(含ffill/bfill与分组填充)、interpolate插值算法(线性、最邻近、索引插值)。同时解析np.nan与pd.NA的类型差异及Nullable类型优势,结合分类检验与KNN回归示例,提供完整代码实现与参数说明。
前言
本章重点介绍Pandas库中缺失数据的处理机制,核心内容涵盖以下方面:
- 针对np.nan的操作:包括统计、删除、填充及插值方法;
- Pandas引入的Nullable类型及其相关操作特性;
除非另有说明,本章示例均基于以下df数据框,不再重复展示:
df = pd.read_csv('./data/learn_pandas.csv',usecols=['Grade','Name','Gender','Height','Weight','Transfer'])
df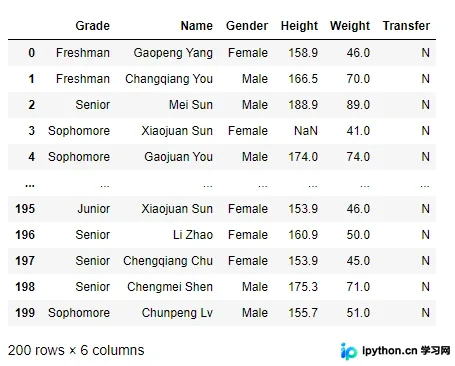
一、缺失值的统计与删除
1. 缺失值的统计
可以使用isna()和isnull()方法来识别数据中的np.nan元素:
df.isna()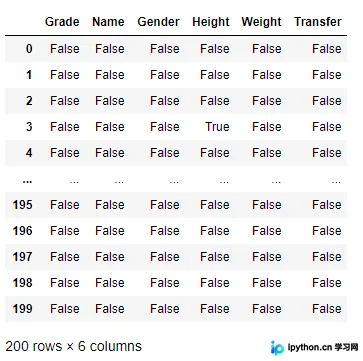
返回结果与原数据形状一致,非np.nan元素返回False,否则返回True。
接下来验证这两种方法的等效性:
>>> df.isna().equals(df.isnull())
True
notna()和notnull()方法与isna()相反,对非缺失值返回True,对缺失值返回False:
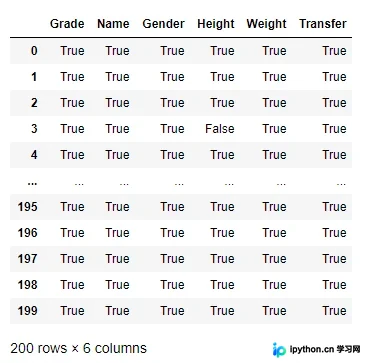
同样验证它们之间的关系:
>>> df.notna().equals(df.notnull())
True
>>> df.notna().equals(~df.isna())
True
证明这四个方法确实两两相同(isna/isnull互等,notna/notnull互等)且两组间互为反逻辑。
1)配合其他统计方法使用
可将isna()与其他统计函数结合,例如统计每行缺失值数量:
df.isna().sum(axis = 1)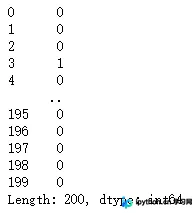
axis = 1表示沿列方向统计,结果返回每行的缺失值计数
也可统计每列缺失值所占比例:
df.isna().sum(axis = 0)/df.shape[0]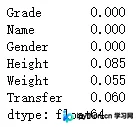
其中,axis = 0表示沿行方向统计,结果返回每列的缺失值数量,df.shape[0]表示数据总行数。
2)配合索引使用
结合索引可筛选特定缺失行,例如返回体重为缺失值的行:
df[df['Weight'].isna()]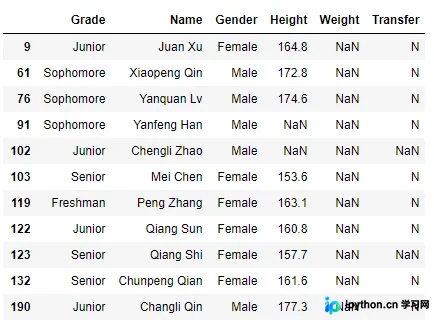
3)配合逻辑方法使用
若要返回身高和体重同时缺失的行,需结合逻辑运算:
df[df[['Height','Weight']].isna().all(axis = 1)]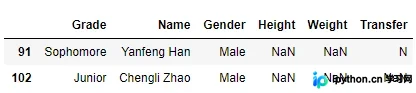
也可统计包含缺失值的列:
df.isna().any(axis = 0)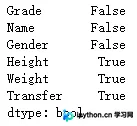
返回False表示该列无缺失值,True表示该列至少有一个缺失值。
总结规律如下:
| 缺失值方法 | 逻辑方法 | 结果 | 含义 |
|---|---|---|---|
| isna() or isnull() | all | True | 都是缺失值 情况4 |
| isna() or isnull() | all | False | 不都是缺失值 情况3 |
| isna() or isnull() | any | True | 至少有一个缺失值 情况2 |
| isna() or isnull() | any | False | 都不是缺失值 情况1 |
| notna() or notnull() | all | True | 都是非缺失值 情况1 |
| notna() or notnull() | all | False | 不都是非缺失值 情况2 |
| notna() or notnull() | any | True | 至少有一个非缺失值 情况3 |
| notna() or notnull() | any | False | 都不是非缺失值 情况4 |
进一步归纳,上述含义可划分为4种情况,即isna()和notna()在不同逻辑判断(all/any)下的结果对应不同含义。
2. 缺失值的删除
在Pandas中利用dropna方法删除缺失值:
res = df.dropna(how = 'all',subset=['Height','Weight'])
res
how参数可设置为'all'或'any',默认为'any';subset参数指定参与判断的列名,作用等同于通过df索引访问。
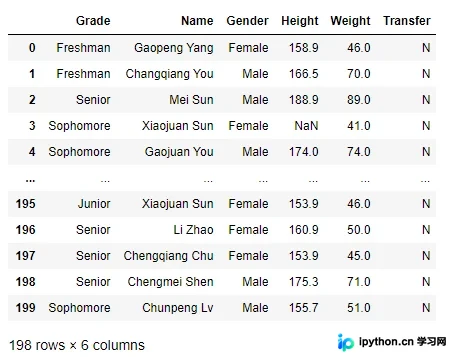
结合前述示例,查看行索引为91和102的同学记录:
>>> res.loc[91]
KeyError: 91
>>> res.loc[102]
KeyError: 102
可以看到确实已成功删除。
1)thresh参数
thresh参数指定数据不被删除所需的最少非缺失值数量:
df.dropna(axis = 1,thresh = df.shape[0] - 15)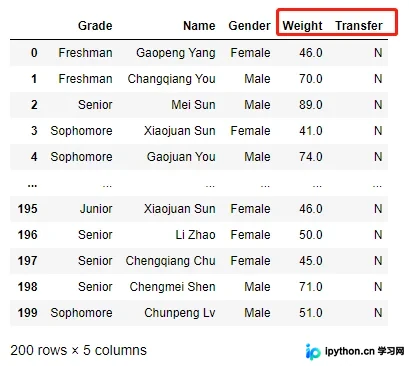
此处的axis参数与sum方法中的axis含义不同。sum中axis=1表示沿列求和返回每行和,而dropna中axis=1仅表示对每列的非缺失值数量与thresh比较,意义不同。这提醒我们不应将所有方法的axis参数统一看待,需视具体情况而定。
2)自定义方法代替dropna
dropna的返回结果可理解为按条件筛选,因此可利用缺失值统计方法进行自定义替代:
#删除身高体重均为缺失值的行(保留身高体重至少有一个为非缺失值的行)
>>> res2 = df[df[['Height','Weight']].notna().any(axis = 1)]
>>> res2.equals(res)
True
>>> res = df.dropna(how = 'any',subset=['Height','Weight'])
>>> res2 = df[df[['Height','Weight']].notna().all(axis = 1)]
>>> res2.equals(res)
True
对于无thresh参数的简单dropna使用,总结如下:
| dropna的how参数 | 对应的缺失值统计方法和逻辑方法 |
|---|---|
| all | notna + any |
| any | notna + all |
这是因为dropna()代表删除isna()在all判断下为True的数据,等价于保留notna()在any判断下为True的数据。
再看如何代替带有thresh参数的dropna方法:
df.loc[:,df.notna().sum(axis = 0) >= df.shape[0]-15]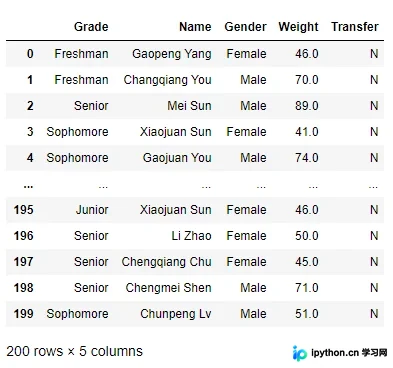
即利用notna方法和loc索引,返回非缺失值数量大于等于thresh的列。
二、缺失值的填充和插值
1. 填充
利用fillna方法对缺失值进行填充,以Series为例,重要参数包括:
- value:标量或字典(索引到元素的映射)
- method:'ffill'代表由前一个非缺失值填充,'bfill'代表由后一个非缺失值填充,默认为None
- limit:限制连续缺失值最多填充次数
- inplace:是否直接替换原数据
此处使用的Series数据如下:
>>> s = pd.Series([np.nan,2,np.nan,np.nan,0,np.nan],list('Xiaomy'))
>>> s
X  NaN
i  2.0
a  NaN
o  NaN
m  0.0
y  NaN
dtype: float64
1)利用value参数进行填充
#使用标量进行填充
>>> s.fillna(1)
X  1.0
i  2.0
a  1.0
o  1.0
m  0.0
y  1.0
dtype: float64

#使用字典进行填充
>>> s.fillna({'X':1,'y':100,'c':1})
X   1.0
i   2.0
a   NaN
o   NaN
m   0.0
y  100.0
dtype: float64
使用字典填充时,字典无需包含所有缺失值的索引,且可包含非索引键。
2)利用method方法进行填充
也可利用method进行连续填充:
#由前面的非缺失值向后填充
>>> s.fillna(method='ffill')
X  NaN
i  2.0
a  2.0
o  2.0
m  0.0
y  0.0
dtype: float64

#由后面的非缺失值向前填充
>>> s.fillna(method='bfill')
X  2.0
i  2.0
a  0.0
o  0.0
m  0.0
y  NaN
dtype: float64
可见,对于ffill方式,起始的缺失值无法填充;对于bfill方式,结尾的缺失值也无法填充。
3)分组和缺失值填充的配合
对于df数据中身高的缺失项,最好利用对应年级和相同性别的平均身高来填充:
>>> df.groupby(['Grade','Gender'])['Height'].transform(lambda x:x.fillna(x.mean()))
0   158.900000
1   166.500000
2   188.900000
3   158.363158
4   174.000000
     ...
195  153.900000
196  160.900000
197  153.900000
198  175.300000
199  155.700000
Name: Height, Length: 200, dtype: float64
此处利用分组中的自定义变换方法配合缺失值填充使用。
另外,limit参数可限制填充次数,以配合method参数为例:
>>> s.fillna(method='ffill',limit=1)
X  NaN
i  2.0
a  2.0
o  NaN
m  0.0
y  0.0
dtype: float64
当然,limit参数也可配合其他参数使用,此处不再赘述。
练一练
题目:对一个序列按如下规则填充缺失值:若单独出现的缺失值,用前后均值填充;若连续出现的缺失值则不填充,即序列[1, NaN, 3, NaN, NaN]填充后为[1, 2, 3, NaN, NaN],请利用fillna函数实现。(提示:利用`limit`参数)
>>> s = pd.Series([1,np.nan,3,np.nan,np.nan])
>>> res = (s.fillna(method='ffill',limit=1)+s.fillna(method='bfill',limit=1))/2
>>> res
0  1.0
1  2.0
2  3.0
3  NaN
4  NaN
dtype: float64
思路:对于不满足题设条件的位置(包括两端),利用np.nan与其他值相加仍为np.nan的特性保持原状;对于左右均为非缺失值的位置,求左右两侧之和后除以2即可。
2. 插值方法
在Pandas中一般使用interpolate方法进行插值,重要参数包括:
- limit_direction:'forward'代表由前一个非缺失值进行插值,'backward'代表由后一个非缺失值进行插值,'both'代表二者兼有
- method:插值方法,包括'nearest', 'zero', 'slinear', 'quadratic', 'cubic', 'spline', 'barycentric', 'polynomial',默认为'linear'
- inplace:是否替换原数据
- limit:插值次数
本节使用的Series数据如下:
>>> s = pd.Series([np.nan, np.nan, 1, np.nan, np.nan, np.nan, 2, np.nan, np.nan])
>>> s
0  NaN
1  NaN
2  1.0
3  NaN
4  NaN
5  NaN
6  2.0
7  NaN
8  NaN
dtype: float64
1)线性插值
>>> s.interpolate(limit_direction='backward')
0  1.00
1  1.00
2  1.00
3  1.25
4  1.50
5  1.75
6  2.00
7   NaN
8   NaN
dtype: float64

>>> s.interpolate(limit_direction='both')
0  1.00
1  1.00
2  1.00
3  1.25
4  1.50
5  1.75
6  2.00
7  2.00
8  2.00
dtype: float64
此处举例向前和向两端分别进行线性插值。注意,若缺失值左侧或右侧完全没有非缺失值,它将无法被填充(保持NaN)。
2)最邻近插值
注意需提前安装scipy库,否则会报错:

>>> s.interpolate(method = 'nearest')
0  NaN
1  NaN
2  1.0
3  1.0
4  1.0
5  2.0
6  2.0
7  NaN
8  NaN
dtype: float64
注意,此处会忽略两端,且距离两侧非缺失值相等的位置默认插入前一个非缺失值。
3)索引插值
索引插值可理解为不等比线性插值,它根据索引的相对距离进行插入,类似百分位数的概念:
>>> s = pd.Series([0,np.nan,100],index=[0,1,10])
>>> s.interpolate(method = 'index')
0    0.0
1   10.0
10  100.0
dtype: float64

>>> s.interpolate()
0    0.0
1   50.0
10  100.0
dtype: float64
注意它和线性插值的区别。
三、Nullable类型
1. 缺失值的本质和缺陷
Python中用None表示缺失值,Numpy中用np.nan表示缺失值。二者共同点是与其他值不等,不同点在于后者与自己也不等且没有用于关键字,需通过numpy.nan来使用:
>>> None == True
False
>>> np.nan == True
False
>>> np.nan == []
False
>>> None == []
False
>>> np.nan == ''
False
>>> None == ''
False
>>> None == None
True
>>> np.nan == np.nan
False
>>> pd.Series([1, np.nan]) == pd.Series([1, np.nan])
True
虽然两个np.nan是不等的,但对于包含np.nan变量的s或df数据,它们会跳过比较对应位置的np.nan变量。
np.nan的缺陷在于,其本质是一种float类型的变量。当它和其他类型同时存在于数据中时,会改变整个数据的类型,如:
>>> pd.Series([100,np.nan]).dtype
dtype('float64')
>>> pd.Series(['1',np.nan]).dtype
dtype('O')
>>> pd.Series([False,np.nan]).dtype
dtype('O')
当np.nan和int型变量放在一起时,会使整个数据序列变成float64型;当np.nan和其他类型变量放在一起时,会使整个数据序列变成object型。
2. Pandas中的Nullable类型
Pandas设计了新的缺失类型pd.NA以及三种Nullable序列类型以尝试解决这些缺陷:
它们的作用之一是在比较时返回pd.NA本身而不是False:
>>> s = pd.Series(['a', 'b'])
>>> s_bool = pd.Series([True, np.nan])
>>> s_boolean = pd.Series([True, np.nan]).astype('boolean')
>>> s_bool & True
0   True
1  False
dtype: bool
>>> s_boolean & True
0  True
1  <NA>
dtype: boolean
即不会改变比较前后的结果类型。
3. 缺失数据的计算和分组
对np.nan和pd.NA进行标量运算时,除了1的np.nan次幂和np.nan的0次幂两种情况以外,均返回其自身:
>>> np.nan + 1
nan
>>> pd.NA + 1
<NA>
>>> np.nan * 10
nan
>>> pd.NA * 10
<NA>
>>> np.nan ** 0
1.0
>>> 1 ** np.nan
1.0
在对含有np.nan的数据进行操作时,默认会忽略它们,如:
>>> s = pd.Series([7,6,np.nan,5,4])
>>> s.sum()
22.0
注意虽然忽视了np.nan,但由于np.nan的存在,结果仍变为float类型。
练习
Ex1:缺失值与类别的相关性检验
在数据处理中,含有过多缺失值的列往往会被删除,除非缺失情况与标签强相关。下面有一份关于二分类问题的数据集,其中X_1, X_2为特征变量,y为二分类标签:
df = pd.read_csv('./data/missing_chi.csv')
df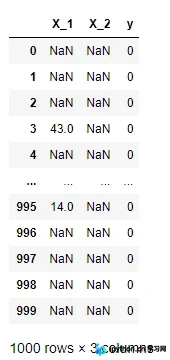
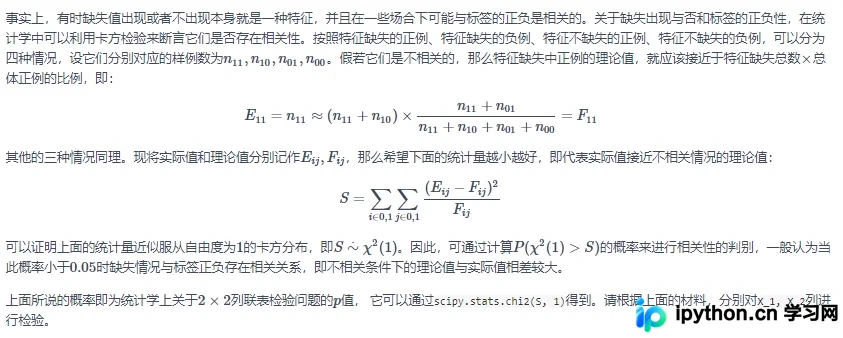
from scipy.stats import chi2
df = pd.read_csv('./data/missing_chi.csv')
#分别将两列的缺失值和非缺失值替换为字符‘NaN'和‘NotNaN'
cat_1 = df.X_1.fillna('NaN').mask(df.X_1.notna()).fillna("NotNaN")
cat_2 = df.X_2.fillna('NaN').mask(df.X_2.notna()).fillna("NotNaN")
#分别进行行列汇总 方便计算Eij和Fij
df_1 = pd.crosstab(cat_1, df.y, margins=True)
df_2 = pd.crosstab(cat_2, df.y, margins=True)
def compute_S(my_df):
	#双层遍历,利用列表推导生成式去做
  res = [((my_df.iat[i, j]-(my_df.iat[i, 2]*my_df.iat[2, j]/my_df.iat[2,2]))**2/(my_df.iat[i, 2]*my_df.iat[2, j]/my_df.iat[2,2])) for i in range(2) for j in range(2)]
  #返回总和
  return sum(res)
res1 = compute_S(df_1)
res2 = compute_S(df_2)
>>> print(chi2.sf(res1, 1) < 0.05)
False
>>> print(chi2.sf(res2, 1) < 0.05)
True
思路:参照参考答案编写,对每一步进行注释,并对循环进行了一定优化。
Ex2:用回归模型解决分类问题
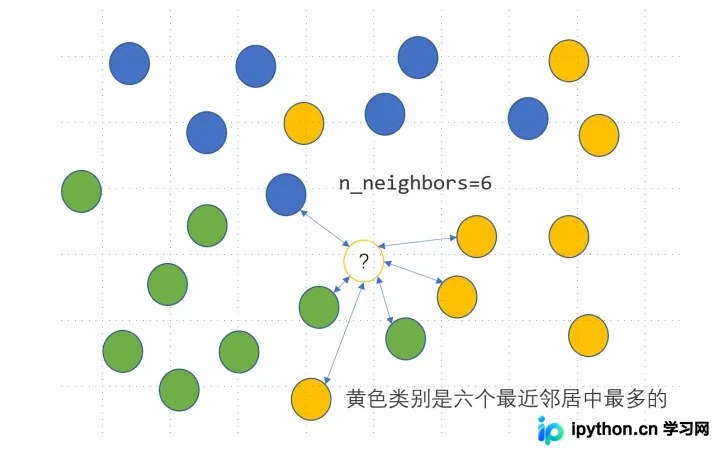
KNN是一种监督式学习模型,既可解决回归问题,也可解决分类问题。对于分类变量,利用KNN分类模型可实现其缺失值的插补。思路是度量缺失样本的特征与所有其他样本特征的距离,当给定模型参数n_neighbors=n时,计算离该样本距离最近的n个样本点中最多的那个类别,并将这个类别作为该样本的缺失预测类别,具体如下图所示,未知的类别被预测为黄色:
df = pd.read_excel('./data/color.xlsx')
df.head()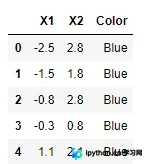
from sklearn.neighbors import KNeighborsClassifier
clf = KNeighborsClassifier(n_neighbors=6)
#传入前两列和预测值
clf.fit(df.iloc[:,:2], df.Color)
clf.predict([[0.8, -0.2]])
1. 分类转回归 2. 缺失值插补
df = pd.read_csv('./data/audit.csv')
df.head()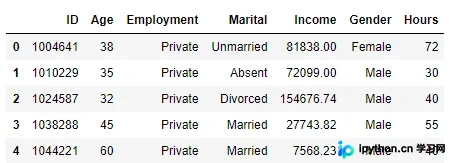
参考文献1. Pandas中Dataframe的查询方法([], loc, iloc, at, iat, ix)
到此这篇关于Pandas之缺失数据的实现的文章就介绍到这了,更多相关Pandas之缺失数据内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















