


Python结合mitmproxy与Appium实现抖音视频抓取实战

发布时间:2026-10-14 |
6人浏览过
本文详细解析如何利用Python结合mitmproxy进行流量抓包,以及使用Appium模拟Android手机操作来抓取抖音视频。通过启动Appium服务、创建Session驱动抖音App,并配合Python脚本处理请求,实现视频文件的自动下载与保存。
鉴于抖音目前极高的用户活跃度,许多开发者尝试通过网络爬虫技术获取平台内容。此前有案例表明,通过自动化工具可以成功实现抖音视频数据的抓取,且后续优化方案显示,即使去除Appium组件,仅依靠其他手段也能达成目标。下文将详细介绍具体的操作流程与实现细节。
环境准备与流量抓包
第一步:使用mitmproxy或mitmdump工具进行网络流量抓包分析。
import requests
path = 'D:/video/'
num = 1788
def response(flow):
 global num
 target_urls = ['url']
 for url in target_urls:
   if flow.request.url.startswith(url):
      filename = path + str(num) + '.mp4
   res = requests.get(flow.request.url, stream=True)
    with open(filename, 'ab') as f:
    f.write(res.content)
    f.flush()
    print(filename + '下载完成')
   num += 1
Appium自动化操作配置
第二步:利用Appium对Android手机进行模拟操作,以触发视频加载请求。
点击Start Server按钮即可启动Appium服务进程。
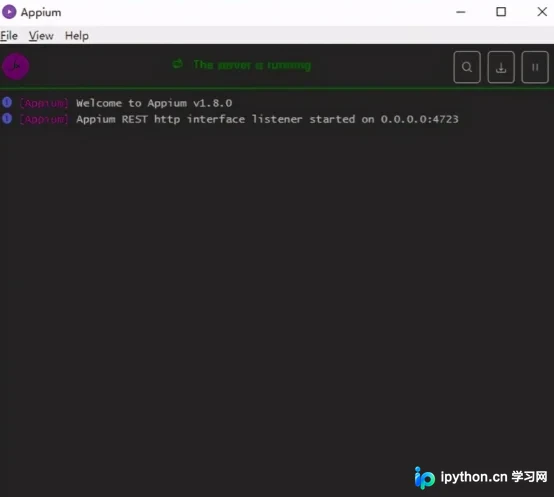
随后点击Start Session,系统将启动Android设备上的抖音App并进入启动页面,此时可监控相关网络请求。
第三步:编写Python脚本驱动Appium执行自动化操作,直接在PyCharm环境中运行脚本即可。
Python代码实现与扩展
实例扩展:
import requests
import json
import re
import os
from pprint import pprint as pp
import queue


class DouYin:
 header = {
  'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8',
  'accept-encoding': 'gzip, deflate, br',
  'accept-language': 'zh-CN,zh;q=0.9',
  'cache-control': 'max-age=0',
  'upgrade-insecure-requests': '1',
  'user-agent': 'Mozilla/5.0 (iPhone; CPU iPhone OS 11_0 like Mac OS X) AppleWebKit/604.1.38 (KHTML, like Gecko) Version/11.0 Mobile/15A372 Safari/604.1',
 }

 def __init__(self, url=None):
  self.url = self.get_RealAddress(url)
  # 获取用户视频的url
  self.user_video_url = 'https://www.douyin.com/aweme/v1/aweme/post/?{0}'
  self.user_id = re.search(r'user/(.*)\?', self.url).group(1)		# 用户id
  requests.packages.urllib3.disable_warnings()
  self.session = requests.Session()
  self.target_folder = ''		# 创建文件的路径
  self.queue = queue.Queue()		# 生成一个队列对象

 def user_info(self):
  self.mkdir_dir()
  p = os.popen('node fuck.js %s' % self.user_id) # 获取加密的signature
  signature = p.readlines()[0]

  user_video_params = {
   'user_id': str(self.user_id),
   'count': '21',
   'max_cursor': '0',
   'aid': '1128',
   '_signature': signature
  }

  # 获取下载视频的列表
  def get_aweme_list(max_cursor=None):
   if max_cursor:
    user_video_params['max_cursor'] = str(max_cursor)
   user_video_url = self.user_video_url.format(
    '&'.join([key + '=' + user_video_params[key] for key in user_video_params])) # 拼接参数
   response = requests.get(
    url=user_video_url, headers=self.header, verify=False)
   contentJson = json.loads(response.content.decode('utf-8')) # 将返回的进行utf8编码
   aweme_list = contentJson.get('aweme_list', [])
   for aweme in aweme_list:
    video_name = aweme.get(
     'share_info', None).get('share_desc', None)  # 视频的名字
    video_url = aweme.get('video', None).get('play_addr', None).get(
     'url_list', None)[0].replace('playwm', 'play')  # 视频链接
    self.queue.put((video_name, video_url)) # 将数据进队列
   if contentJson.get('has_more') == 1: # 判断后面是不是还有是1就是还有
    return get_aweme_list(contentJson.get('max_cursor')) # 有的话获取参数max_cursor
  get_aweme_list()

 # 下载视频
 def get_download(self):
  while True:
   video_name, video_url = self.queue.get()
   file_name = video_name + '.mp4'
   file_path = os.path.join(self.target_folder, file_name)
   if not os.path.isfile(file_path):
    print('download %s form %s.\n' % (file_name, video_url))
    times = 0
    while times < 10:
     try:
      response = requests.get(
       url=video_url, stream=True, timeout=10, verify=False) # 开启流下载
      with open(file_path, 'wb') as f:
       for chunk in response.iter_content(1024): # 返回迭代对象
        f.write(chunk)
       print('下载成功')
      break
     except:
      print('下载失败')
     times += 1

 # 创建对应的文件夹

 def mkdir_dir(self):
  current_folder = os.getcwd()
  self.target_folder = os.path.join(
   current_folder, 'download/%s' % self.user_id)
  if not os.path.isdir(self.target_folder):
   os.mkdir(self.target_folder)

 # 短链接转长地址
 def get_RealAddress(self, url):
  if url.find('v.douyin.com') < 0:
   return url
  response = requests.get(
   url=url, headers=self.header, allow_redirects=False) # allow_redirects 允许跳转
  return response.headers['Location']

if __name__ == '__main__':
 douyin = DouYin(url='http://v.douyin.com/J2B9Sk/')
 douyin.user_info()
 douyin.get_download()
至此,关于Python爬取抖音视频的技术分析已介绍完毕。如需了解更多相关技术细节,建议查阅本站往期文章或继续关注后续更新,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















