


Python分布式爬虫实战:从基础抓取到反监控策略详解

本文深入解析Python分布式爬虫的核心原理,从基础的网络请求、数据解析到存储全流程展开。重点探讨Cookie模拟登录、多编码格式转换、HTML清洗及JS渲染等常见技术难点,并详细阐述应对IP频率限制和账号封禁的反监控策略,包括代理池构建与随机延迟机制,旨在提供一套完整且高可用性的数据采集解决方案。
首先,我们需要了解人类获取网页内容的正常行为流程。
第一步,打开浏览器并输入目标URL,访问源网页。
第二步,筛选并提取所需内容,涵盖标题、作者、摘要及正文等关键信息。
第三步,将提取的数据保存至本地硬盘。
上述三个步骤在技术层面可映射为:网络请求、结构化数据抓取以及数据存储。
接下来,我们将使用Python编写一个简易程序,以实现上述基础抓取功能。
#!/usr/bin/python
#-*- coding: utf-8 -*-
'''''
Created on 2014-03-16

@author: Kris
'''
import urllib2, re, cookielib

def httpCrawler(url):
  '''''
  @summary: 网页抓取
  '''
  content = httpRequest(url)
  title = parseHtml(content)
  saveData(title)

def httpRequest(url):
  '''''
  @summary: 网络请求
  '''
  try:
    ret = None
    SockFile = None
    request = urllib2.Request(url)
    request.add_header('User-Agent', 'Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.2; SV1; .NET CLR 1.1.4322)')
    request.add_header('Pragma', 'no-cache')
    opener = urllib2.build_opener()
    SockFile = opener.open(request)
    ret = SockFile.read()
  finally:
    if SockFile:
      SockFile.close()

  return ret

def parseHtml(html):
  '''''
  @summary: 抓取结构化数据
  '''
  content = None
  pattern = '<title>([^<]*?)</title>'
  temp = re.findall(pattern, html)
  if temp:
    content = temp[0]

  return content

def saveData(data):
  '''''
  @summary: 数据存储
  '''
  f = open('test', 'wb')
  f.write(data)
  f.close()

if __name__ == '__main__':
  url = 'http://www.baidu.com'
  httpCrawler(url)
虽然代码看似简单,但这正是爬虫入门的基础程序。实现数据采集的核心步骤无非如此,但要构建一个强大的采集系统,你将面临以下挑战:
第一,访问时需携带Cookie信息。多数社交类软件要求用户登录后才能查看有价值的内容。解决方法是利用Python提供的cookielib模块,确保每次访问都携带源网站下发的Cookie。只要成功模拟登录,爬虫即可保持登录状态,从而采集到该用户可见的所有信息。以下是修改后的httpRequest()方法代码:
ckjar = cookielib.MozillaCookieJar()
cookies = urllib2.HTTPCookieProcessor(ckjar)     #定义cookies对象
def httpRequest(url):
  '''''
  @summary: 网络请求
  '''
  try:
    ret = None
    SockFile = None
    request = urllib2.Request(url)
    request.add_header('User-Agent', 'Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.2; SV1; .NET CLR 1.1.4322)')
    request.add_header('Pragma', 'no-cache')
    opener = urllib2.build_opener(cookies)    #传递cookies对象
    SockFile = opener.open(request)
    ret = SockFile.read()
  finally:
    if SockFile:
      SockFile.close()

  return ret
第二,编码兼容性问题。目前网站主要采用utf-8或gbk编码。当源网站编码(如163.com使用的gbk)与数据库存储编码(如utf-8)不一致时,需使用Python的encode()和decode()方法进行转换,示例如下:
content = content.decode('gbk', 'ignore')   #将gbk编码转为unicode编码
content = content.encode('utf-8', 'ignore')  #将unicode编码转为utf-8编码
在此过程中,需先转换为中间编码unicode,再进一步转换为gbk或utf-8。
第三,网页标签不完整问题。部分源代码存在起始标签但缺失结束标签的情况,这会影响结构化数据的抓取。可通过Python的BeautifulSoup模块对源代码进行清洗,随后再分析获取内容。
第四,部分网站使用JavaScript动态生成网页内容。直接查看源代码时可能看到大量JS代码。此时可使用mozilla、webkit等浏览器内核工具包来解析JS和Ajax请求,尽管执行速度可能稍慢。
第五,图片以Flash形式存在。若图片内容为文字或数字,可利用OCR技术实现自动识别;若仅为Flash链接,则直接存储该URL即可。
第六,单个网页包含多种网页结构的情况。单一抓取规则无法应对,需配置多套模拟规则协同配合抓取。
第七,应对源网站的监控机制。抓取他人数据往往受到限制,因此大多数网站都设有反爬虫策略。一个优秀的采集系统应具备“所见即所得”的能力,无论目标数据位于何处,只要用户可见,系统即可采集。鉴于大部分高价值信息需登录才能查看(如社交网站),系统需具备模拟用户登录的能力。然而,社会化网站倾向于形成数据闭环,不愿数据外流,因此会采取限制措施防止机器人爬取。通常,单个账号频繁爬取会被检测并封禁。但这并不意味着无法爬取,只要网站未关闭网页访问,正常人能访问的数据,爬虫也能通过模拟正常人类行为(即“反监控”技术)来获取。
源网站通常实施以下几种限制措施:
1、单位时间内单个IP的访问频率限制。正常用户不会在短时间内高频访问同一网站。对此,可构建大量不规则代理IP组成的代理池,随机选取代理进行访问。代理IP主要分为透明代理和匿名代理两种。
2、单位时间内单个账号的访问频率限制。若某账号24小时不间断高速访问数据接口,极可能是机器人行为。解决方案是使用大量行为正常的账号,模拟普通用户在社交网站的操作模式。关键在于控制单位时间内的URL访问数量,并在每次访问后引入随机睡眠间隔,再接续访问下一个URL。
若能妥善控制账号和IP的访问策略,基本可解决大部分问题。当然,目标网站运维人员也会动态调整策略,这是一场持续的博弈。爬虫系统需具备感知反监控影响的能力,并及时通知管理员处理。理想状态下,应通过机器学习智能实现反监控对抗,确保持续抓取。
以下是本人近期设计的一个分布式爬虫架构图,如图1所示:
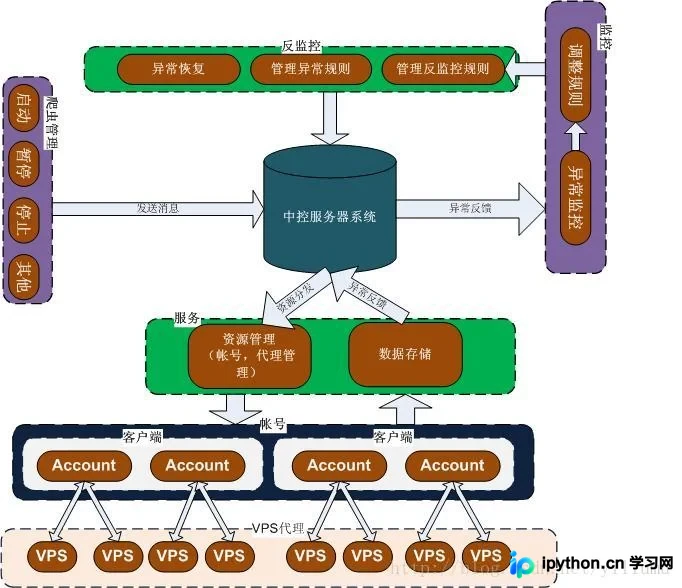
此为初步构思,目前正搭建服务器与客户端间的通信,主要利用Python的Socket模块实现通信。如有兴趣,欢迎单独联系,共同探讨更优方案。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















