


Selenium与XPath获取指定元素属性的差异解析

发布时间:2026-10-14 |
4人浏览过
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。
Selenium与XPath获取属性的差异
今天分享一个关于Selenium与XPath配合使用时的小技巧,特别是在爬取数据并获取指定位置元素时,两者的用法存在显著差异。
具体实现细节请参考下方的代码示例,这里以B站(bilibili)作为演示对象。
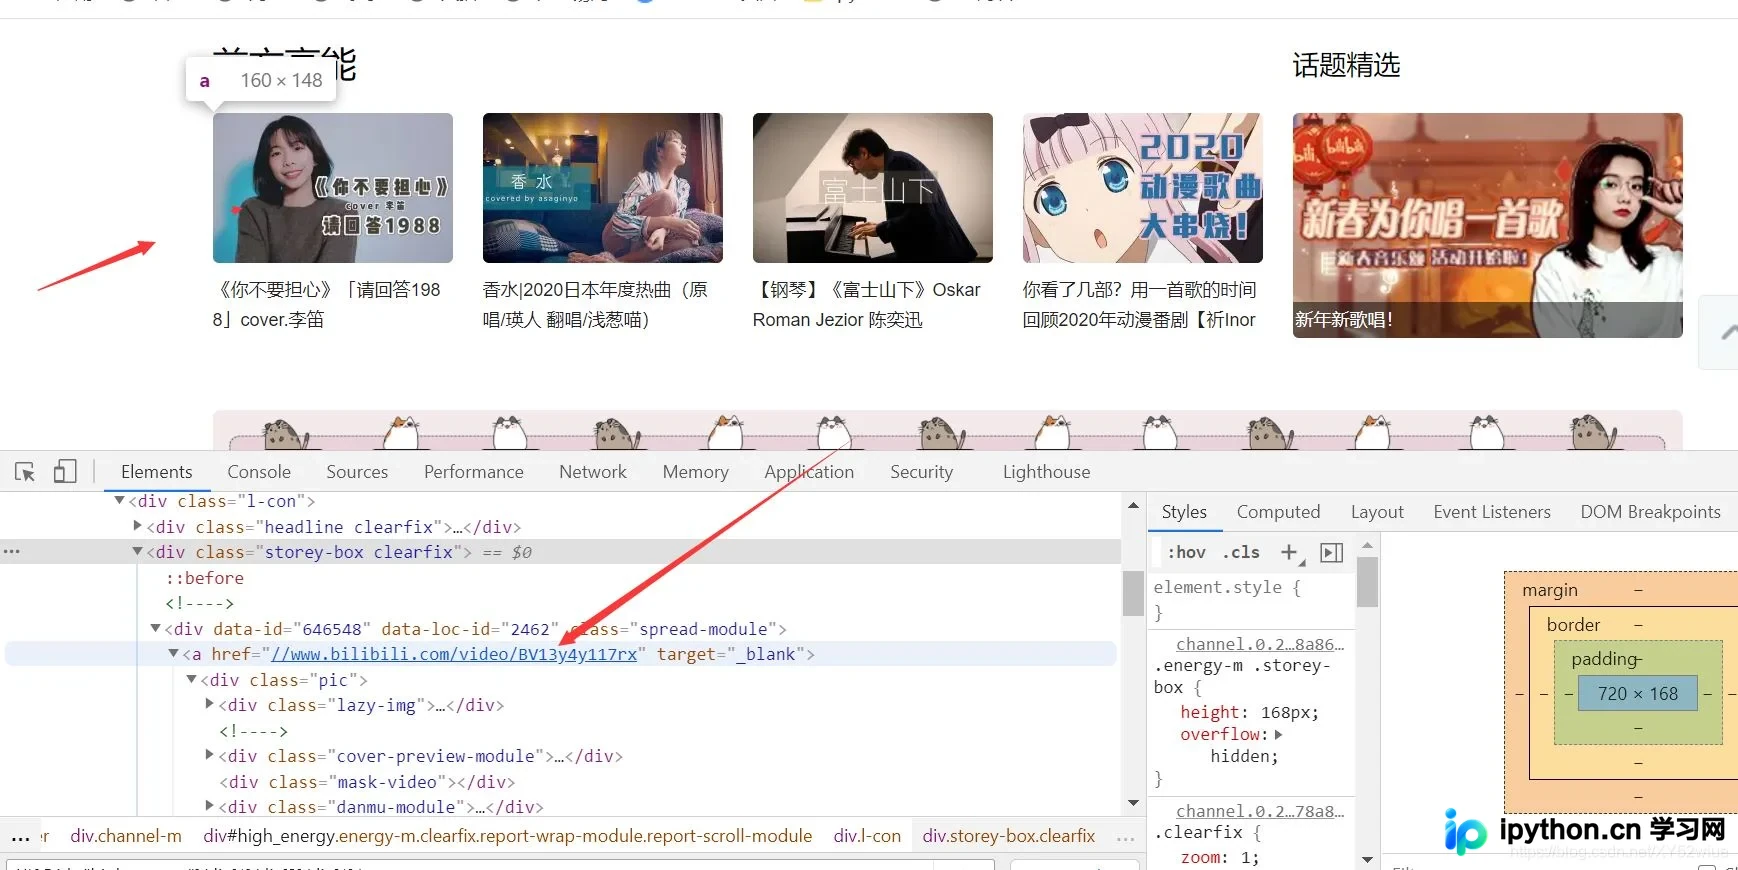
标准XPath与Selenium的写法对比
如果仅使用标准的XPath语法来查看href元素,写法如下通常没有问题:
i.find_element_by_xpath('./a/@href')然而,如果在Selenium环境中直接沿用这种XPath写法,程序会抛出错误。因此,我们需要调整获取方式,改为以下代码:
i.find_element_by_xpath('./a').get_attribute('href')
按照上述修改后,即可正确获取到目标数据。
B站爬虫实战案例
这是一个简单的B站音乐视频爬取案例。受限于当前技术水平,我尚未找到下载视频文件的方法,暂时无法完成下载操作。
如果您知道如何下载B站视频,欢迎在评论区留言分享,谢谢!
import requests
from selenium.webdriver import Chrome,ChromeOptions
#后面越来越多喜欢用函数来实现了
def get_webhot():  #热搜函数
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.141 Safari/537.36'
  }
  url ="https://www.bilibili.com/" # 微博的地址

  res = requests.get(url)
  #这个就是再后台上面运行那个浏览器,不在表面上占用你的
  option = ChromeOptions()
  option.add_argument('--headless')
  option.add_argument("--no-sandbox")
  #这里也要输入
  browser = Chrome(options=option)
  browser.get(url)
  #解析那个web热搜前,按住ctrl+f会在下面出现一个框框,然后改就完事
  browser.find_element_by_xpath('//*[@id="primaryChannelMenu"]/span[3]/div/a/span').click()
  c = browser.find_elements_by_xpath('//*[@id="high_energy"]/div[1]/div[2]/div')
  for i in c:
    #这里一定要注意,在selenium中不能像xpath那样写('./a/@href')来获取指定的位置,要报错,只能这么获取,查了很久
    detail_url = i.find_element_by_xpath('./a').get_attribute('href')
    name = i.find_element_by_xpath('./a/p').get_attribute('title')
    detail_page_text = requests.get(url=detail_url,headers = headers).text
    print(detail_url,name)
#运行完事
get_webhot()
以下是代码运行后的输出结果截图。
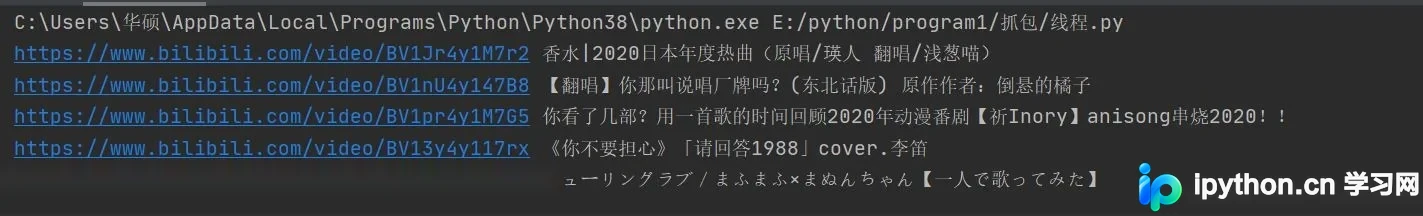
至此,关于Selenium与XPath获取指定位置元素的实现介绍完毕。如需了解更多相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















