


Python实现Excel批量转Word文档的自动化教程

发布时间:2026-10-15 |
4人浏览过
本文详细介绍如何使用Python将Excel文件批量转换为Word文档。通过结合xlrd读取Excel数据与python-docx生成Word内容,实现表格、标题及格式的自动化处理。文章涵盖模块安装、数据源格式要求及核心代码逻辑,适用于办公自动化场景下的文档生成需求。
在办公自动化场景中,Python的应用十分广泛,例如批量计算Excel数据并生成图表、按固定格式将多个Excel文件转换为Word文档,或定时生成文件并发送邮件等。本文通过一个具体示例,简要介绍利用Python进行Excel与Word互转的相关技术要点,仅供学习参考,欢迎指正不足。
相关知识点
本文旨在通过特定规则将Excel文件转换为Word文档,涉及的技术要点如下:
xlrd模块:用于读取Excel文件,具体功能包括:
- xlrd.open_workbook(self.excel_file):打开Excel文件并返回文档对象,参数为Excel文件的完整路径。
- book.sheet_by_name(self.sheet_name):通过指定名称获取对应的Sheet页,并返回Sheet对象。
- sheet.nrows:获取Sheet页的有效行数。
- sheet.ncols:获取Sheet页的有效列数。
- sheet.row_values(0):返回Excel中对应Sheet页第一行的值,结果以数组形式呈现。
- sheet.cell_value(row, col):返回指定行和列的单元格值。
python-docx模块:用于操作Word文档,包括表格、段落等,具体功能如下:
- Document:Word文档对象,代表整个Word文档。
- doc.sections[0]:获取当前章节。
- doc.add_section(start_type=WD_SECTION_START.CONTINUOUS):添加连续章节。
- doc.add_heading(third, level=2):添加标题,level参数表示标题级别(如二级标题),返回标题对象。
- doc.add_paragraph(text='', style=None):添加段落,返回段落对象。
- doc.add_table(rows=4, cols=5):添加表格并返回表格对象。
- doc_table.style = "Table Grid":设置表格样式。
- doc_table.rows[0].cells[1].merge(doc_table.rows[0].cells[4]):合并单元格。
- doc_table.rows[3].cells:获取表格某一行所有单元格,以数组形式返回。
- head_cells[0].width = Cm(1.9):设置列宽,单位为厘米(cm)。
- doc_table.rows[i].cells[j].vertical_alignment = WD_CELL_VERTICAL_ALIGNMENT.CENTER:设置表格内容垂直居中。
- doc_table.add_row():新增行并返回行对象。
插件安装
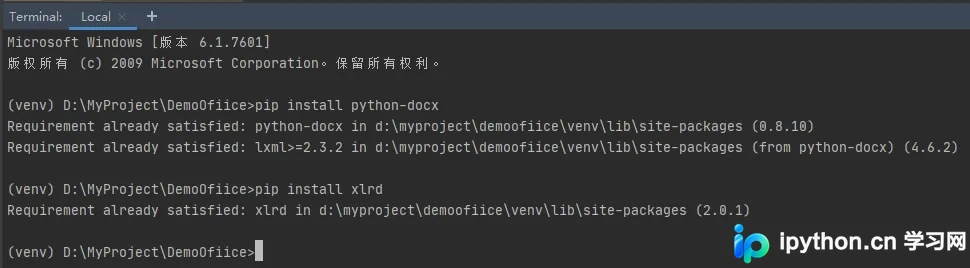
插件可在PyCharm的Terminal面板中安装。安装python-docx的命令为:pip install python-docx。
安装xlrd的命令为:pip install xlrd,效果如下所示:
数据源文件
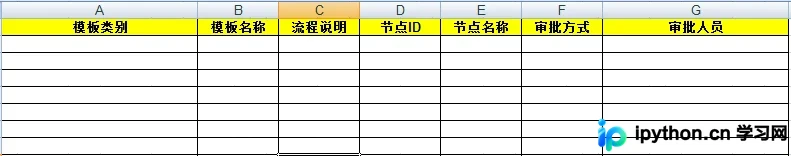
数据源为一系列格式相同的Excel文件,共七列。其中第一列需按【/】进行截取拆分,格式示例如下:
核心代码
本文核心源码主要分为三部分:
导入相关模块包,代码如下:
import xlrd
from docx import Document
from docx.enum.section import WD_ORIENTATION
from docx.enum.text import WD_PARAGRAPH_ALIGNMENT
from docx.shared import Pt, Cm, RGBColor
from docx.oxml.ns import qn
from docx.enum.table import WD_CELL_VERTICAL_ALIGNMENT
读取Excel数据,代码如下:
def read_excel(self):
    """读取Excel"""
    book = xlrd.open_workbook(self.excel_file)
    sheet = book.sheet_by_name(self.sheet_name)
    nrows = sheet.nrows # 行数
    ncols = sheet.ncols # 列数
    datas = [] # 存放数据
    # 第一列 标题
    keys = sheet.row_values(0)
    for row in range(1, nrows):
      data = {} # 每一行数据
      for col in range(0, ncols):
        value = sheet.cell_value(row, col) # 取出每一个单元格的数据
        # 替换到特殊字符
        value = value.replace('<', '').replace('>', '').replace('$', '')
        data[keys[col]] = value
        # 截取第一列元素
        if col == 0:
          first = '' # 截取元素 第1
          second = '' # 截取元素 第2
          third = '' # 截取元素 第3
          arrs = value.lstrip('/').split('/') # 去掉第一个/ 然后再以/分组
          if len(arrs) > 0:
            if len(arrs) == 1:
              first = arrs[0]
              second = first
              third = second
            elif len(arrs) == 2:
              first = arrs[0]
              second = arrs[1]
              third = second
            elif len(arrs) == 3:
              first = arrs[0]
              second = arrs[1]
              third = arrs[2]
            else:
              first = arrs[0]
              second = arrs[1]
              third = arrs[2]
          else:
            first = value.ltrip('/')
            second = first
            third = second
          data['first'] = first
          data['second'] = second
          data['third'] = third
        # 截取第一列结束
      datas.append(data)
    return datas
生成Word文档部分,代码如下:
def write_word(self, datas):
    """生成word文件"""
    if len(datas) < 1:
      print('Excel没有内容')
      return
    # 定义word文档对象
    doc = Document()
    # 添加横向
    section = doc.sections[0] # doc.add_section(start_type=WD_SECTION_START.CONTINUOUS) # 添加横向页的连续节
    section.orientation = WD_ORIENTATION.LANDSCAPE
    page_h, page_w = section.page_width, section.page_height
    section.page_width = page_w # 设置横向纸的宽度
    section.page_height = page_h # 设置横向纸的高度
    # 设置字体
    doc.styles['Normal'].font.name = u'宋体'
    doc.styles['Normal']._element.rPr.rFonts.set(qn('w:eastAsia'), u'宋体')
    # 获取第3部分(部门) 并去重
    data_third = []
    for data in datas:
      third = data['third']
      if data_third.count(third) == 0:
        data_third.append(third)
    for third in data_third:
      h2 = doc.add_heading(third, level=2) # 写入部门,二级标题
      run = h2.runs[0] # 可以通过add_run来设置文字,也可以通过数组来获取
      run.font.color.rgb = RGBColor(0, 0, 0)
      run.font.name = u'宋体'
      doc.add_paragraph(text='', style=None) # 增加空白行 换行
      # 开始获取模板
      data_template = []
      for data in datas:
        if data['third'] == third:
          template = {'first': data['first'], '模板名称': data['模板名称']}
          if data_template.count(template) == 0:
            data_template.append(template)
      # 获取模板完成
      # 遍历模板
      for template in data_template:
        h3 = doc.add_heading(template['模板名称'], level=3) # 插入模板名称,三级标题
        run = h3.runs[0] # 可以通过add_run来设置文字,也可以通过数组来获取
        run.font.color.rgb = RGBColor(0, 0, 0)
        run.font.name = u'宋体'
        doc.add_paragraph(text='', style=None) # 换行
        data_table = filter(
          lambda data: data['third'] == third and data['模板名称'] == template['模板名称'] and data['first'] ==
                 template['first'], datas)
        data_table = list(data_table)
        # 新增表格 4行5列
        doc_table = doc.add_table(rows=4, cols=5)
        doc_table.style = "Table Grid"
        doc_table.style.font.size = Pt(9)
        doc_table.style.font.name = '宋体'

        # 合并单元格 赋值
        doc_table.rows[0].cells[1].merge(doc_table.rows[0].cells[4])
        doc_table.rows[1].cells[1].merge(doc_table.rows[1].cells[4])
        doc_table.rows[2].cells[1].merge(doc_table.rows[2].cells[4])
        doc_table.rows[0].cells[0].text = '流程名称:'
        doc_table.rows[0].cells[1].text = data_table[0]['模板名称']
        doc_table.rows[1].cells[0].text = '使用人:'
        doc_table.rows[1].cells[1].text = data_table[0]['first']
        doc_table.rows[2].cells[0].text = '流程说明:'
        doc_table.rows[2].cells[1].text = data_table[0]['流程说明']

        # 设置标题
        head_cells = doc_table.rows[3].cells # 前面还有三行,特殊处理
        head_cells[0].text = '节点'
        head_cells[1].text = '节点名'
        head_cells[2].text = '处理人员'
        head_cells[3].text = '处理方式'
        head_cells[4].text = '跳转信息'
        # 设置列宽
        head_cells[0].width = Cm(1.9)
        head_cells[1].width = Cm(4.83)
        head_cells[2].width = Cm(8.25)
        head_cells[3].width = Cm(2.54)
        head_cells[4].width = Cm(5.64)
        # 第1 列水平居中,并设置行高,所有单元格内容垂直居中
        for i in range(0, 4):
          # 水平居中
          p = doc_table.rows[i].cells[0].paragraphs[0]
          p.alignment = WD_PARAGRAPH_ALIGNMENT.CENTER
          doc_table.rows[i].height = Cm(0.6) # 行高
          # 垂直居中
          for j in range(0, 5):
            doc_table.rows[i].cells[j].vertical_alignment = WD_CELL_VERTICAL_ALIGNMENT.CENTER

        # 生成表格并填充内容
        row_num = 0
        for data in data_table:
          row = doc_table.add_row()
          row_cells = row.cells
          row_cells[0].text = str(row_num + 1) # 序号,需要转换成字符串
          row_cells[1].text = data['节点名称']
          row_cells[2].text = data['审批人员']
          row_cells[3].text = data['审批方式']
          row_cells[4].text = ''
          # 水平居中
          p = row_cells[0].paragraphs[0]
          p.alignment = WD_PARAGRAPH_ALIGNMENT.CENTER
          row.height = Cm(0.6) # 行高
          # 垂直居中
          for j in range(0, 5):
            row_cells[j].vertical_alignment = WD_CELL_VERTICAL_ALIGNMENT.CENTER
          row_num = row_num + 1

        doc.add_paragraph(text='', style=None) # 换行
    doc.save(self.word_file)
以上即为Python将Excel转换为Word的完整示例,更多关于Python Excel转Word的资料,敬请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















