


Scrapy实现IP动态代理与定时更换的完整方案

本文详细介绍如何在Scrapy框架中实现IP动态代理及定时更换IP池的方法。通过配置settings文件定义IP池与计数器,利用start_requests初始化IP数据,并在下载器中间件的process_request中实现每次请求随机选取IP及达到阈值后自动刷新IP池的逻辑,确保爬虫的稳定运行。
Scrapy动态IP代理实现思路与配置
为了演示如何简单实现IP代理功能,同时避免推广特定商业服务,请读者自行准备一个可用的IP代理平台。例如,可以选择一个每次请求返回10个IP地址的服务接口。
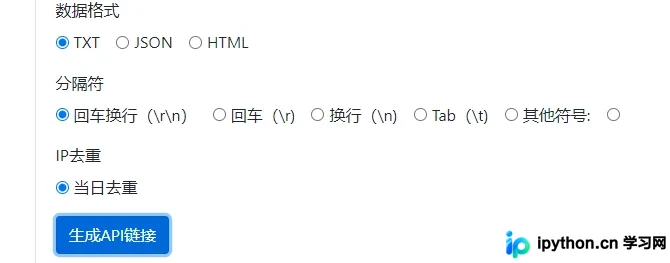
从上述平台获取的数据格式通常为纯文本,行分隔符为\r\n。访问该接口后,返回内容大致如下所示。需要注意的是,Scrapy框架中的代理IP必须包含协议前缀,例如:http://117.95.41.21:34854。
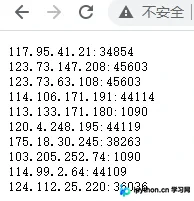
准备好IP数据源后,我们先梳理一下整体的实现思路。
首先,需要在Scrapy的settings配置文件中定义IP池变量以及用于记录请求次数的计数器。
由于需要在爬虫启动初期填充IP池,因此应在爬虫文件的start_requests函数中进行初始化操作。
更换IP的核心逻辑位于middlewares模块的下载器中间件类的process_request函数中。因为Scrapy在发起每个请求前都会经过此函数,所以在这里处理代理设置最为合适。
Settings配置与中间件启用
具体到settings文件的配置,只需添加两行关键代码即可定义全局的IP池和计数器变量。
count = {'count': 0}
ipPool = []
此外,必须在settings中启用对应的下载器中间件。请注意,务必启用的是处理下载的中间件类,只有正确启用该中间件,其process_request函数中的逻辑才会生效。
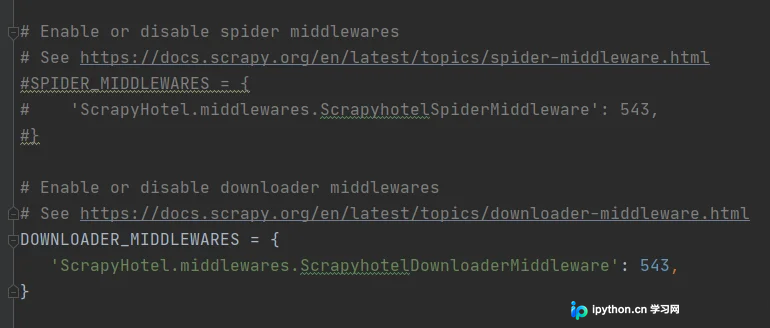
在下载器中间件的process_request函数中,主要执行两个任务:一是为当前请求设置IP代理,二是实现固定次数后自动更换整个IP池的逻辑。
中间件核心逻辑:随机代理与定时刷新
	# 记得导包
	from 你的项目.settings import ipPool, count
	import random
	import requests

  def process_request(self, request, spider):
    # 随机选中一个ip
    ip = random.choice(ipPool)
    print('当前ip', ip, '-----', count['count'])
    # 更换request的ip----------这句是重点
    request.meta['proxy'] = ip
    # 如果循环大于某个值,就清理ip池,更换ip的内容
    if count['count'] > 50:
      print('-------------切换ip------------------')
      count['count'] = 0
      ipPool.clear()
      ips = requests.get('你的ip获取的地址')
      for ip in ips.text.split('\r\n'):
        ipPool.append('http://' + ip)
    # 每次访问,计数器+1
    count['count'] += 1
    return None
最后,在爬虫文件的start_requests函数中,负责在第一次发送请求之前,预先从代理平台获取IP并填充到全局IP池中。
爬虫初始化:填充初始IP池
	# 记得导包
	from 你的项目.settings import ipPool
	import random
	import requests

  def start_requests(self):
    # 第一次请求发起前先填充一下ip池
    ips = requests.get('你的ip获取的地址')
    for ip in ips.text.split('\r\n'):
      ipPool.append('http://' + ip)
通过上述步骤,一个简单的支持动态代理且能固定次数后自动更换IP池的Scrapy爬虫配置即告完成。
至此,关于在Scrapy中实现IP动态代理与定时更换IP的方法介绍完毕。如需了解更多相关Scrapy IP动态代理与更换IP的内容,建议查阅本站过往文章或继续浏览后续相关教程。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















