


Python Scrapy框架核心原理与实战入门指南

本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
Scrapy框架简介
一、Scrapy框架简介
Scrapy是一个使用纯Python语言编写的、专门用于抓取网站数据并提取结构化信息的应用框架,其应用场景极为广泛。借助该框架,开发者仅需定制开发少量模块即可轻松构建爬虫程序,用于抓取网页内容及相关图片,操作便捷高效。该框架底层采用Twisted异步网络库处理网络通信,整体架构清晰,并内置多种中间件接口,能够灵活满足各类复杂需求。在Python生态中,Scrapy被视为功能最强大的爬虫框架之一,其完善程度远超BeautifulSoup;若将BeautifulSoup比作基础工具(轮子),Scrapy则更像是一辆完整的汽车,开发者无需关注底层细节即可直接使用。
Scrapy核心原理与组件
二、Scrapy原理
1. ScrapyEngine(引擎):作为核心控制中心,负责协调Spider、ItemPipeline、Downloader和Scheduler之间的通信、信号传递及数据流转。
2. Scheduler(调度器):负责接收来自引擎的Request请求,对其进行整理、排序并加入队列;当引擎需要时,将请求返还给引擎以供后续处理。
3. Downloader(下载器):负责执行由引擎发送的所有Request请求,获取响应数据(Responses)后将其交还给引擎,再由引擎传递给Spider进行处理。
4. Spider(爬虫):负责处理所有返回的Responses,从中分析并提取数据,获取Item字段所需的信息;同时,将需要进一步跟进的URL提交给引擎,使其重新进入Scheduler进行调度。
5. ItemPipeline(管道):负责处理Spider中提取到的Item数据,执行后期处理逻辑,包括详细分析、数据过滤以及存储等操作。
6. DownloaderMiddlewares(下载中间件):提供可自定义扩展的下载功能组件,用于在请求发送前或响应返回后对数据进行干预。
7. SpiderMiddlewares(Spider中间件):提供可自定义扩展的功能组件,用于操作引擎与Spider之间的通信,例如处理进入Spider的Responses或从Spider发出的Requests。
创建Scrapy项目
三、创建Scrapy项目
新建项目的具体命令如下:
scrapy startproject xxx
在开始执行爬取任务之前,必须首先创建一个新的Scrapy项目。进入自定义的项目目录后,执行以下命令:
scrapy startproject xxx
其中,xxx代表项目名称。执行命令后,系统将创建一个名为xxx的文件夹,其目录结构大致如下:
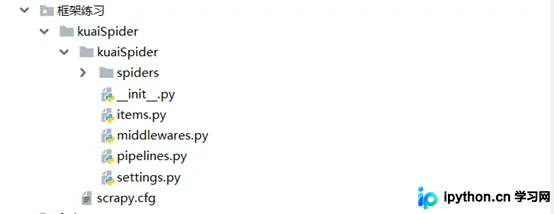
创建爬虫
四、创建爬虫
创建爬虫的具体命令格式为:
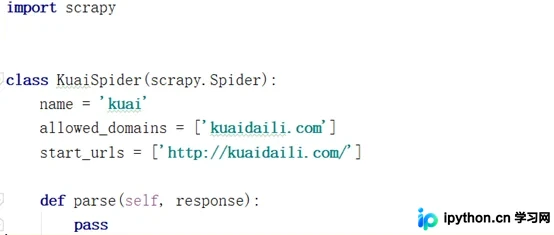
scrapy genspider 爬虫名字 网站域名
需要注意的是,爬虫名称不应与项目名称相同;网站域名是指允许该爬虫进行采集的目标域名,例如baidu.com或zhihu.com。创建完成后,生成的Python文件结构如下:
总结
五、总结
Scrapy框架相当于一辆已制造完成的汽车,只要掌握操作方法,即可利用它前往任何目标地点。相比之下,通常使用的Request方法类似于在出发前重新制造一辆车,过程繁琐且低效。熟练掌握Scrapy后,我们可以对网络上约80%的网站进行数据爬取。
以上就是关于Python Scrapy框架的详细内容,更多相关技术资料请关注本站其他文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















