


Pandas groupby中agg、apply与transform的区别详解

本文详细解析Pandas中groupby后的agg、apply和transform三个方法的核心区别。agg针对单列返回标量,apply接收整个DataFrame并支持复杂逻辑,transform则保持原索引进行广播。通过具体代码实例说明如何在不同场景下选择合适的方法,并解决groupby索引冗余等常见问题。
agg方法主要作用于单列数据,接收一个Series作为输入,执行聚合操作后返回一个标量值。这意味着每次调用时,它处理的是分组后的某一列数据,最终输出该列的聚合结果。
示例展示了如何对单一列应用多个不同的聚合函数。
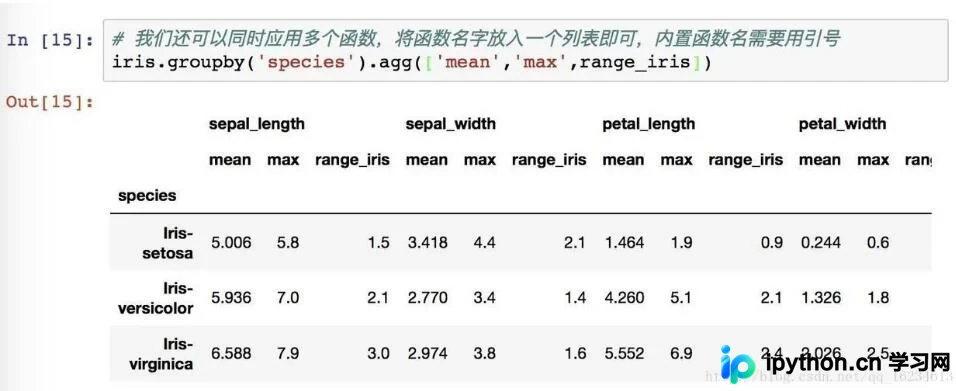
当需要对不同列应用不同的聚合逻辑时,agg可以通过字典形式指定每列对应的函数,实现灵活的多列处理。
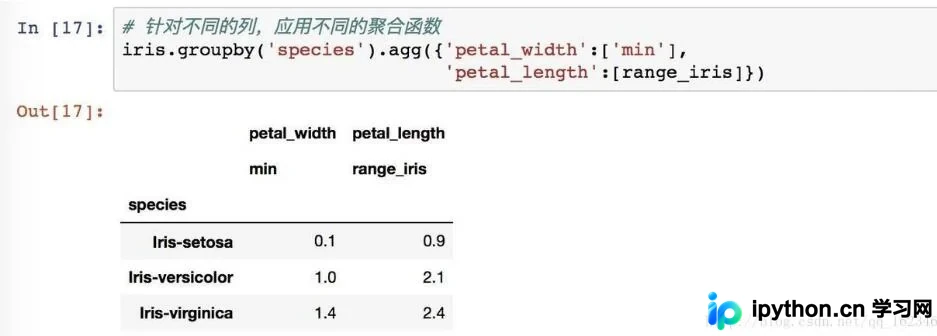
apply是一个更为通用的方法,遵循“拆分-应用-合并”的模式。与agg不同,apply将当前分组后的整个DataFrame作为参数传入函数,因此它可以处理多列数据,并返回多维结果(如Series或DataFrame),而不仅仅是标量。
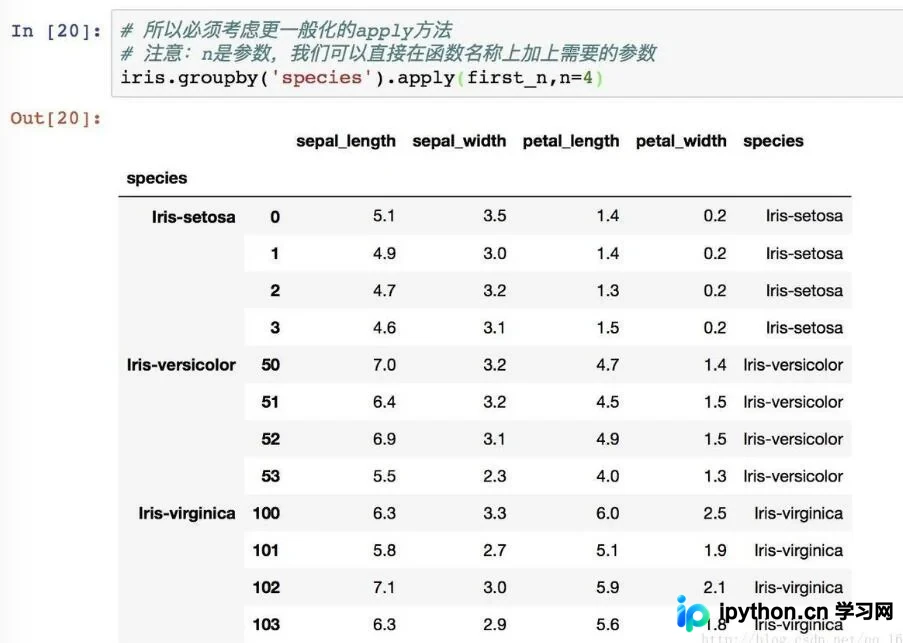
具体应用场景如下:
1、基础数据示例:
lawsuit2[['EID','LAWAMOUNT','LAWDATE']]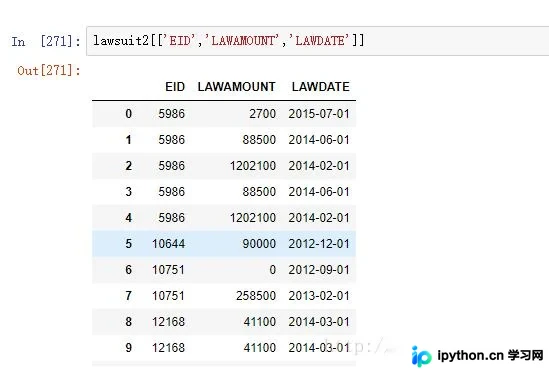
2、在groupby后应用apply,传入的函数接收的是整个分组后的DataFrame对象:
lawsuit2[['EID','LAWAMOUNT','LAWDATE']].groupby(['EID']).apply(lambda df:print(df))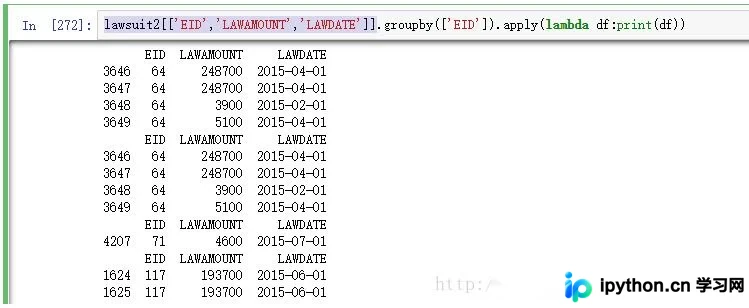
3、若使用agg处理多列,虽然可以处理两列,但若尝试在lambda中直接访问其他列(如通过df['其他列']),可能会因为传入的是单列Series而引发KeyError,除非显式处理列索引:
lawsuit2[['EID','LAWAMOUNT','LAWDATE']].groupby(['EID']).agg(lambda df:print(df))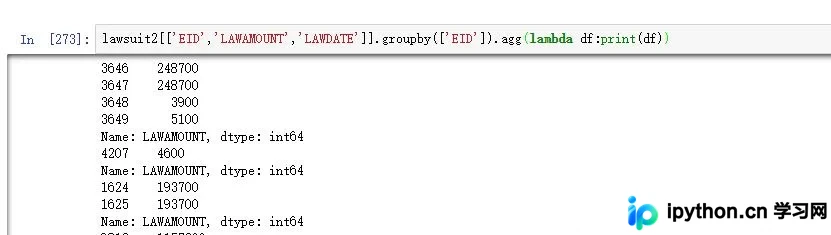
从上述输出可见,agg传入函数的仅是单列数据。虽然可以通过df.iloc或特定方式强行获取其他列信息,但这容易引发KeyError等错误,且代码可读性较差。
4、完整实现代码:
目标:判断每个分组中最近一次日期的花费,是否为该组所有花费中的最大值。
def handle(df):
#   print(df)
# 找最大日期
  maxdate = df['LAWDATE'].max()
# 找最大费用
  left = df[ df['LAWDATE']==maxdate ]['LAWAMOUNT'].max()
# 取ID
  EID = df['EID'].values[0]
#   print(EID)
# 从已存在的表中根据EID找到最大费用
  right = LAW_AMOUNT_MAX.loc[EID,'LAW_AMOUNT_MAX']
# 判断费用是否相等
  if left==right:
    return 1
  else:
    return 0

LAW_AMOUNT_MAX_IS_LAST = lawsuit2[['EID','LAWAMOUNT','LAWDATE']].groupby(['EID']).apply(handle)
其他注意事项:
在groupby后使用apply时,如果直接返回结果,可能会产生多余的层级索引(MultiIndex)。可以通过设置group_keys=False参数来避免这一问题:
orgin = reviews_df.sort_values(["reviewerID","unixReviewTime"]).groupby("reviewerID",group_keys=False)
train = orgin.apply(lambda df: df[:-2])
train.head()
补充:Pandas分组聚合运算中groupby、agg、apply和transform的综合对比。
groupby函数用于根据指定列对数据进行分组,返回GroupBy对象。虽然Pandas提供了sum、mean等优化过的聚合函数,但在需要自定义复杂逻辑时,需借助agg、apply或transform。
三者的核心区别在于:1. agg与transform的区别:agg聚合后仅返回该组单列的一个标量值;transform则将这个标量值广播回原DataFrame的索引位置,保持索引结构不变。2. 参数对象不同:agg和transform接收的是分组后的单列(Series),而apply接收的是分组后的整个DataFrame。
一、agg与transform对比
如代码所示,构造DataFrame后,agg和transform中的lambda函数输入均为单列Series。但agg返回的索引是分组键的唯一值,而transform返回的索引与原DataFrame一致。观察发现,transform实际上是将聚合结果(如形状)广播到原数据的每一行,从而维持原索引结构,且参与分组的列会被剔除。
df
Out[1]:
 index a b c
0   d 0 1 2
1   d 3 4 5
2   e 6 7 8

df.groupby(by='index').agg(lambda x:x.shape)
Out[2]:
     a   b   c
index
d   (2,) (2,) (2,)
e   (1,) (1,) (1,)

df.groupby(by='index').transform(lambda x:x.shape)
Out[3]:
   a   b   c
0 (2,) (2,) (2,)
1 (2,) (2,) (2,)
2 (1,) (1,) (1,)
二、agg与apply对比
apply的结果显示,其lambda函数的输入不再是单列Series,而是分组后的完整DataFrame对象,这使得处理多列交互成为可能。
dd.groupby(by='index').apply(lambda x:x.shape)
Out[4]:
index
d  (2, 4)
e  (1, 4)
三、其他关键注意点
agg不仅支持对每列执行相同操作,还支持传入字典{'列名': 函数}以对不同列执行不同操作,或传入函数列表对同一列执行多个操作,这是agg最灵活的特性。
这三个函数的参数形式均为(func, *args, **kwargs),因此可以通过位置参数或关键字参数向自定义函数传递额外参数。
以上内容为个人经验总结,旨在提供清晰参考。如有疏漏或错误,欢迎指正。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















