


pandas实现分组聚合:将多列合并为列表或字典的方法

发布时间:2026-10-14 |
5人浏览过
本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
在使用pandas处理数据时,有时需要将某一列作为键,将相同键对应的其他列值合并为一个列表或字典结构。例如,将具有相同第一列(即键)的所有值聚合为一个键值对,其中值为列表形式。
形式一:
import pandas as pd
# data
data = pd.DataFrame({'column1':['key1','key1','key2','key2'],
    'column2':['value1','value2','value3','value3']})
print(data)
# Grouped dict
data_dict = data.groupby('column1').column2.apply(list).to_dict()
print(data_dict)
输出结果:
 column1 column2
0  key1 value1
1  key1 value2
2  key2 value3
3  key2 value3
{'key1': ['value1', 'value2'], 'key2': ['value3', 'value3']}
形式二:
import pandas as pd
# data
df = pd.DataFrame({'column1':['key1','key1','key2','key2'],
    'column2':['value1','value2','value1','value2'],
    'column3':['value11','value11','value22','value22'],
    'column4':['value44','value44','value55','value55']})
# Grouped dict
data_dict = df.groupby('column1').apply(lambda x: {col:x[col].tolist() for col in x.columns if col != 'column2'}).to_dict()
print(data_dict)
data_dict2 = df.groupby('column1').apply(lambda x: {col:x[col].tolist()[0] if col != 'column2' else x[col].tolist() for col in x.columns}).to_dict()
print(data_dict2)
输出结果:
#data_dict
{
  'key1': {
    'column1': ['key1', 'key1'],
    'column3': ['value11', 'value11'],
    'column4': ['value44', 'value44']
  },
  'key2': {
    'column1': ['key2', 'key2'],
    'column3': ['value22', 'value22'],
    'column4': ['value55', 'value55']
  }
}
#data_dict2
{
  'key1': {
    'column1': 'key1',
    'column2': ['value1', 'value2'],
    'column3': 'value11',
    'column4': 'value44'
  },
  'key2': {
    'column1': 'key2',
    'column2': ['value1', 'value2'],
    'column3': 'value22',
    'column4': 'value55'
  }
}
补充:pandas中,利用groupby分组后,对字符串字段进行合并拼接
在pandas中,对于数值字段,groupby后可以使用sum()、max()等方法进行简单聚合。而对于字符串字段,若需将多个值拼接在一起,可以使用str.cat()结合lambda函数来实现。
例如,将下表中的内容,对skill字段按照id进行分组合并。
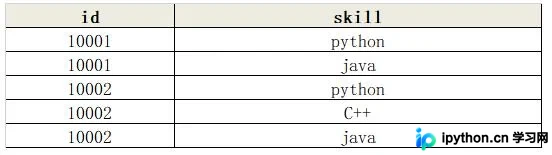
实现代码:
import pandas as pd
file_name='test.xlsx'
df=pd.read_excel(file_name)
data=df.groupby('id')['skill'].apply(lambda x:x.str.cat(sep=':')).reset_index()
print(data)
效果如下:
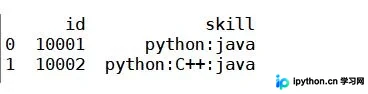
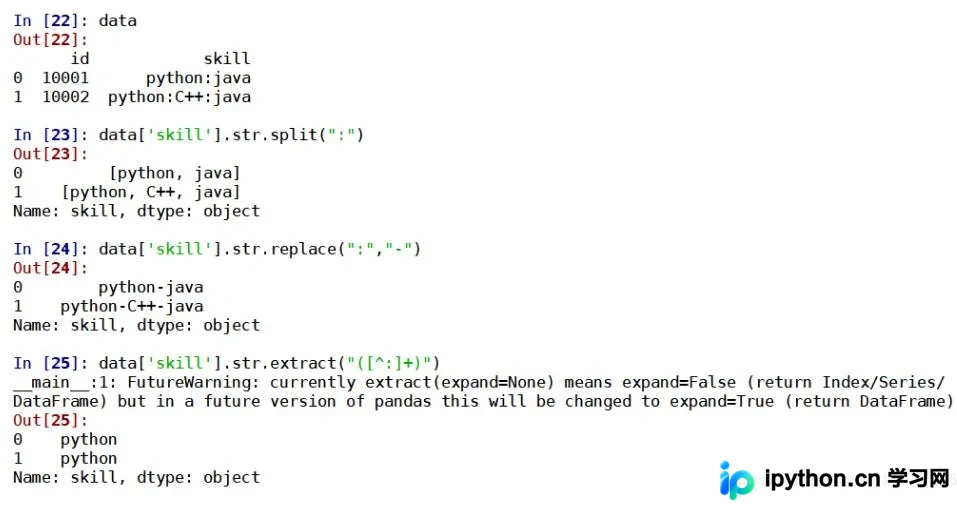
另外,在数据处理过程中,常常需要将某一列进行拆分、分列或替换等操作,相关的函数包括str.split()、str.extract()和str.replace()。
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。如有错误或未考虑完全的地方,望不吝赐教。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















