


pandas 实现分组后取第N行

本文介绍如何利用pandas实现分组后提取第N行数据,并通过示例将question_id对应的user_answer转换为ABCD选项。同时详细解析nlargest()函数的用法,包括获取最大前几行、处理重复值及分组求和等场景,帮助读者掌握高效的数据筛选技巧。
目的:
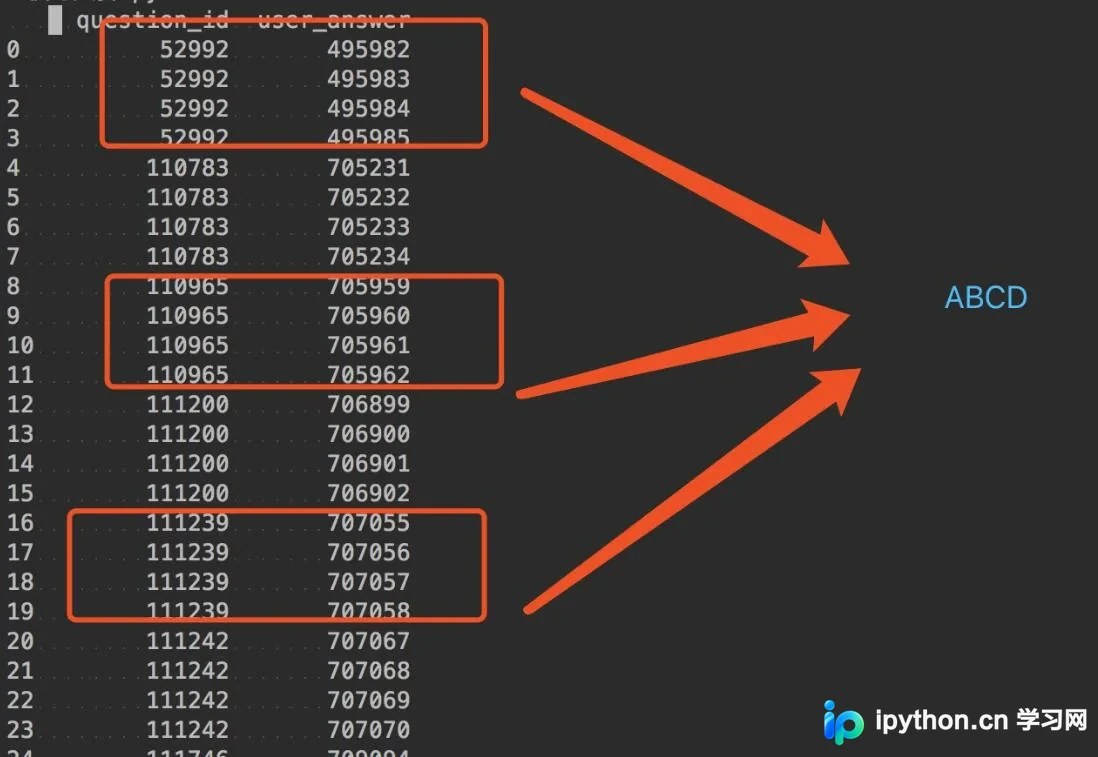
将question_id对应的user_answer转换为ABCD格式。
solution
dfa=df.groupby('question_id').nth(0).reset_index()
dfa['flag']='A'
dfb=df.groupby('question_id').nth(1).reset_index()
dfb['flag']='B'
dfc=df.groupby('question_id').nth(2).reset_index()
dfc['flag']='C'
dfd=df.groupby('question_id').nth(3).reset_index()
dfd['flag']='D'

resdf=dfa.append([dfb,dfc,dfd])
resdf.sort_values(by='question_id')
result:
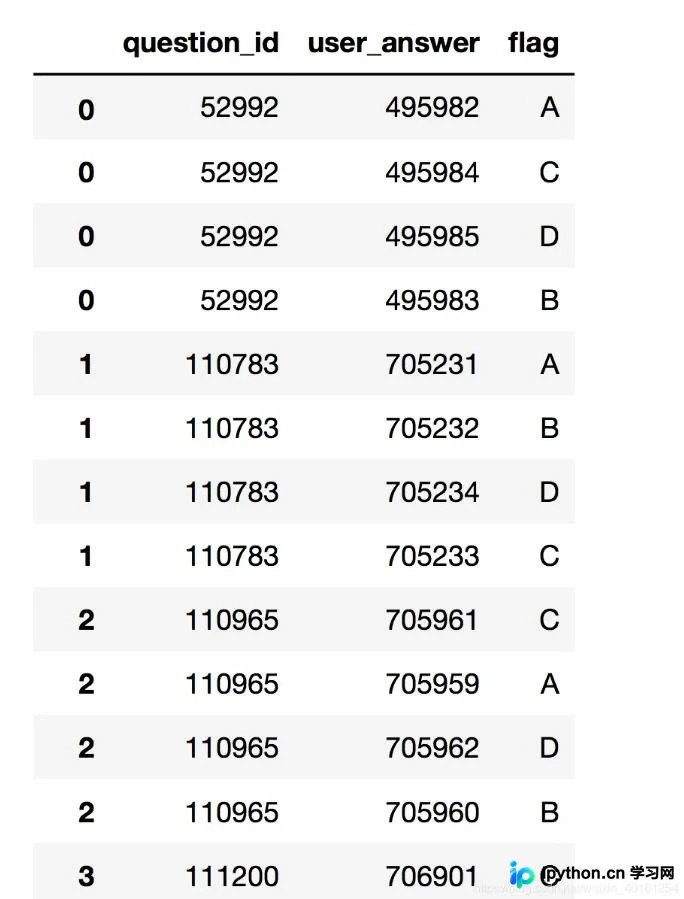
focus:
g.nth(0)
#同
g.first()
g.head(1)
g.last()

g.nth(2)
g.nth(-1)

g.nth(0,dropna='any')
g.B.nth(0,dropna='all')
g.groups
g.get_group(134429)
g.discribe()
g.agg([np.mean,np.sum.np,std])
补充:pandas的分组取最大多行并求和函数nlargest()。
在pandas库中,我们通常关注最大的前几个数据,例如销量最好的几款产品或几家门店。此前介绍的head()函数可以查看DataFrame的前几行,但若需查看最大或最小的几行,则需先进行排序。max()和min()函数虽能显示最大或最小值,但仅返回单个值。
因此,我们可以使用nlargest()函数。该函数的优点在于无需排序即可一次性获取最大的几行数据;其缺点则是无法直接查看最小的多行数据。
我们来看看单价排在前十的数据:
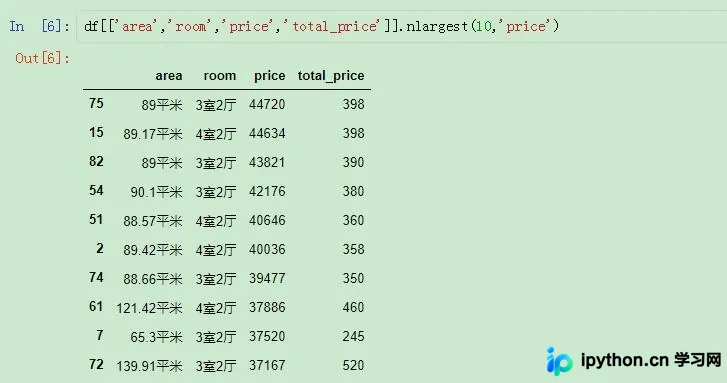
单价排在前十的数据
nlargest()函数的第一个参数指定截取的行数,第二个参数指定依据排序的列名。
这样即可筛选出单价最高的前十行数据,并按单价从高到低排列,索引保持原有顺序。
还可以按照total_price进行排名:
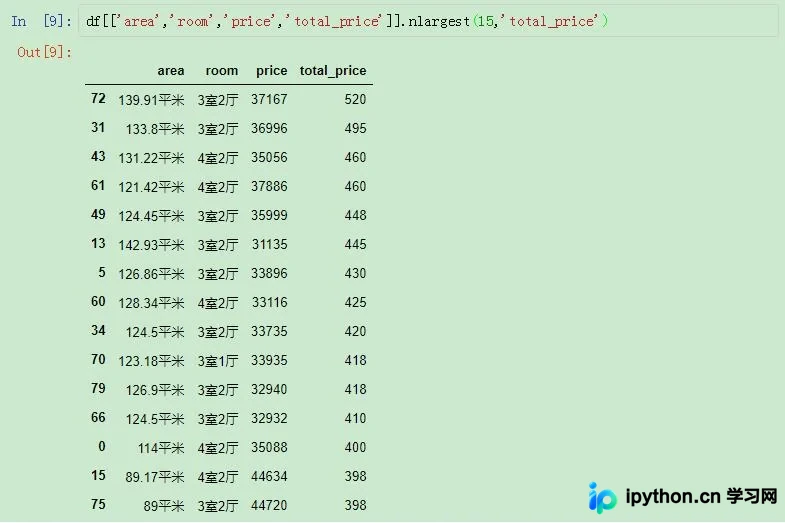
按照total_price排名
nlargest()函数还有一个参数keep,可选值为'first'或'last'。当存在重复值时,若设置keep='first',则选取原始DataFrame中排在前面的记录;若设置keep='last',则选取排在后面的记录。
由于nlargest()无法直接选取最小的多个值,若必须使用该函数进行选取,可采取以下方法。
首先设置一个辅助列:
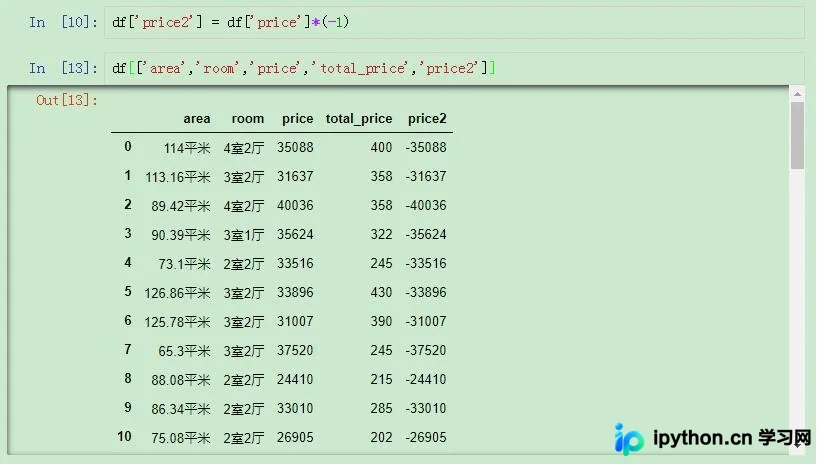
先设置一个辅助列
然后进行选取:
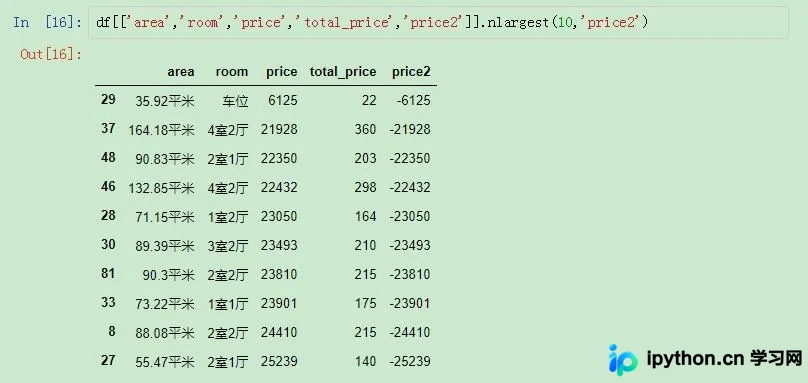
以辅助列进行选取
当然,也可以通过head()结合排序来进行选取。
既然上述操作均可通过其他函数替代,那么nlargest()函数是否仍有必要介绍?学习该函数有何意义?
这正是本文重点介绍的内容:如果需要选择不同location_road下的前五名,应如何操作?
许多人第一反应可能是先分组然后进行max()操作,但此类操作仅能选择单列的最大值:
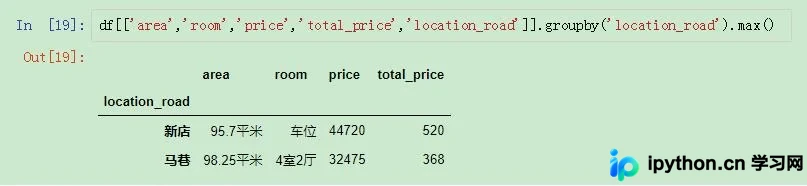
使用max()
然而,使用max()存在一个问题,即选取的是每一列的最大值,而非最大值所在的那一行数据。也就是说,只有在选取单列最大值时结果才是准确的。
此时,我们可以考虑使用apply和lambda自定义函数:
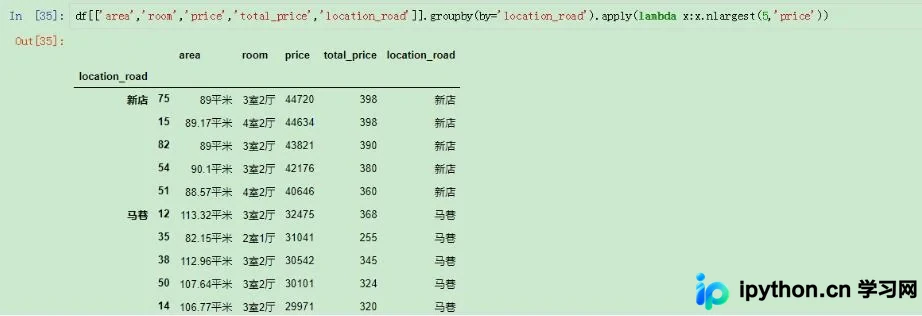
选取多个指标的TOP(N)
这样便选出了不同location_road下price排在前五的行数据。
在此场景下使用nlargest()函数非常便捷,且结果已默认按顺序排列。
此外,还有一些场景需要计算分组的前几名,然后进行求和,我们同样可以使用nlargest()进行操作:
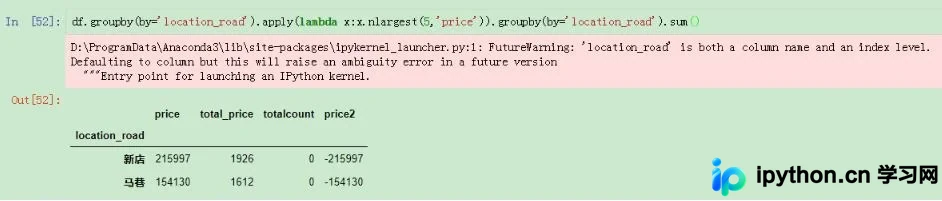
分组之后进行求和
使用这种方法可能会出现报错提示,原因在于列名和索引中均存在location_road,导致重复,系统发出警告。实际使用时,可先修改列名再操作。我们也可以换一种方式,直接按照索引进行求和,这样便不会产生警告:
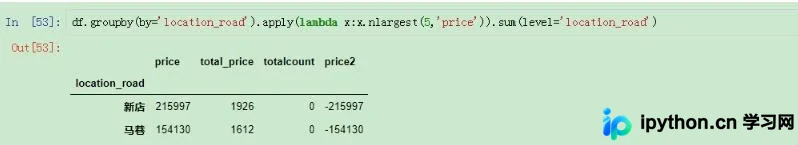
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。如有错误或未考虑完全的地方,望不吝赐教。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















