


怎么利用Cursor的@引用和Rules for AI提升代码生成准确率

在传统的AI编程助手中,我们常陷入一种尴尬的循环:花费大量时间描述背景,却仍得到泛泛而谈的代码片段;或者因为缺乏项目上下文,AI频繁产生“幻觉”,引用不存在的API或违背项目既有规范。这种低效并非工具能力不足,而是交互模式的错位——我们将AI视为独立的问答机器,而非嵌入工作流的协作者。
Cursor的核心突破在于它将“上下文”从隐性的心理预期变成了显性的技术操作。通过@符号的精准引用和Rules for AI的全局约束,我们可以强行拉齐AI的认知基线。这不仅仅是提示词工程的技巧升级,更是开发范式的转变:从“告诉AI做什么”转向“让AI看清我们在哪里”。
锚定上下文:@符号的精准导航
大多数开发者在使用AI时,习惯直接粘贴代码或口头描述需求。但在大型项目中,这种碎片化的信息输入往往导致AI忽略关键的依赖关系或类型定义。Cursor的@功能本质上是一个上下文注入器,它允许用户在对话框中直接挂载具体的文件、文件夹甚至官方文档,从而为AI构建一个局部的、高保真的认知环境。
当你在Chat面板输入@时,会触发一个智能搜索菜单。此时选择@Files并选中当前正在修改的核心业务逻辑文件,AI便能立即读取该文件的完整内容及其导入关系。更关键的是,你可以同时引用多个相关文件。例如,在重构一个React组件时,同时@其对应的CSS模块文件和TypeScript接口定义文件。在这种场景下,AI不再是基于通用知识猜测样式类名或属性类型,而是基于你提供的确切源码进行生成。
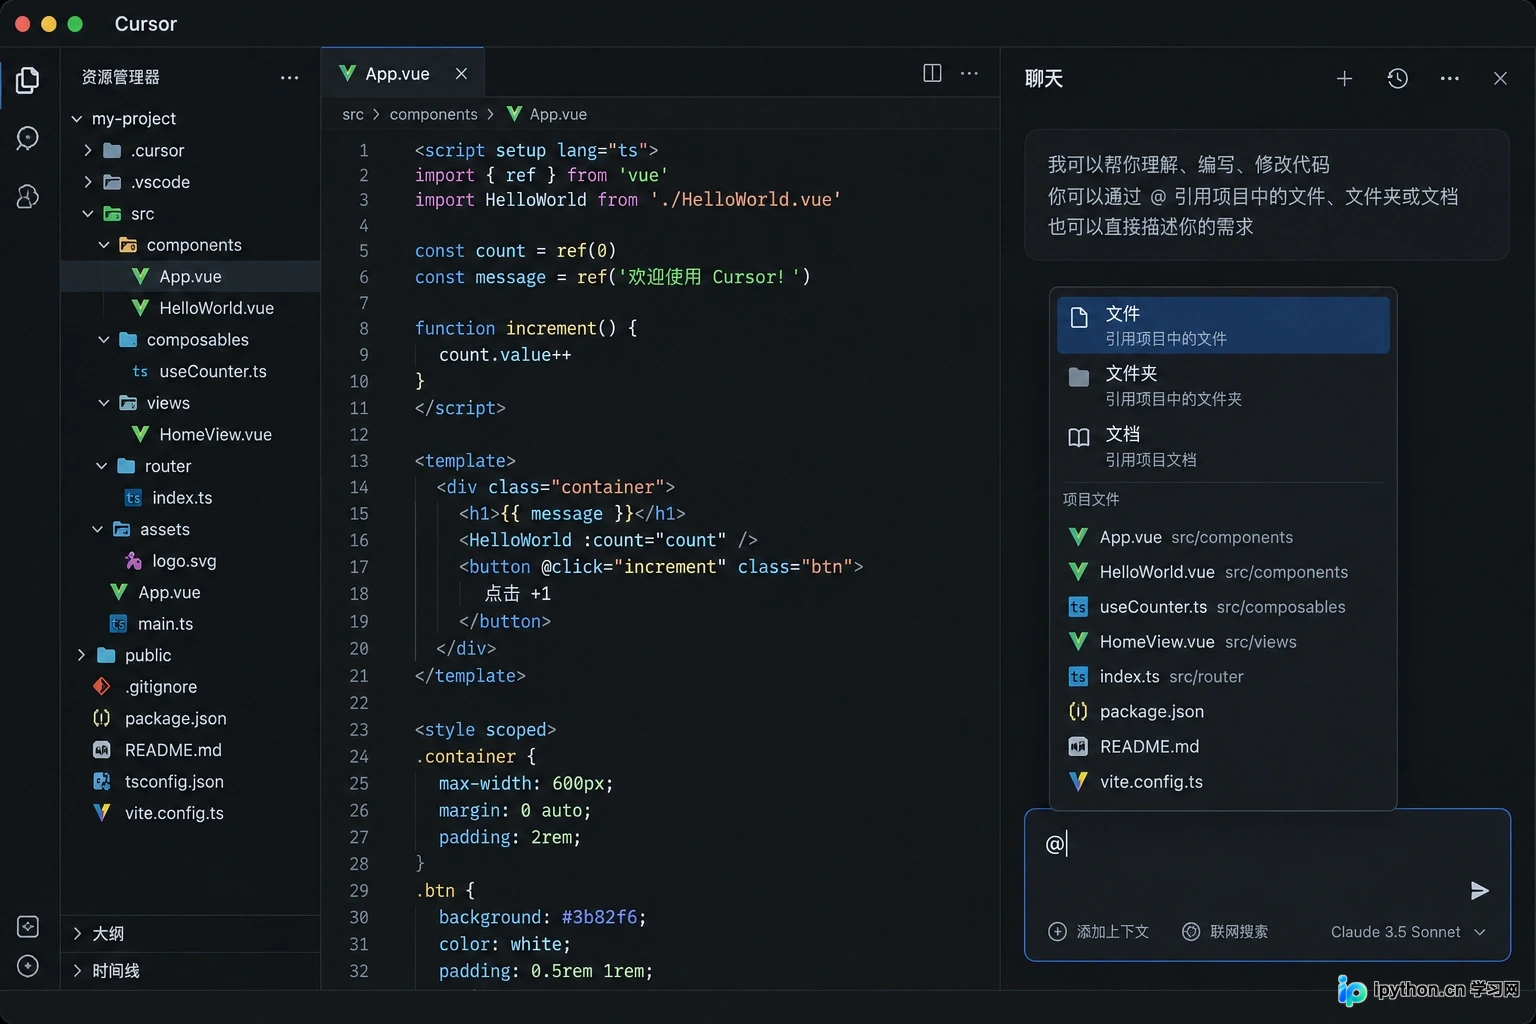
在Chat面板输入@符号触发的上下文选择菜单,包含文件、文件夹和文档选项
除了代码文件,@Docs是另一个被低估的神器。许多第三方库的API更新迅速,AI的训练数据可能存在滞后。通过@Docs引入特定库的官方文档链接(如Next.js或Tailwind CSS的最新文档),Cursor会在生成代码时实时检索这些文档内容。这意味着,即使是一个冷门的新特性,只要文档中有记载,AI就能给出符合最新规范的用法,极大降低了因版本差异导致的运行时错误。
这种引用机制的价值在于边界清晰。它明确告诉AI:“不要瞎猜,只看我给你的这些材料。”这不仅提高了准确率,还减少了后续人工核对代码合法性的时间成本。
固化风格:Rules for AI的全局约束
如果说@引用解决了单次对话的准确性问题,那么Rules for AI则解决了长期协作的一致性问题。在每个新对话中重复强调“使用TypeScript”、“遵循函数式编程风格”或“优先使用Hooks”是低效且容易遗漏的。Rules for AI允许我们将这些偏好固化为项目级的系统指令。
在Cursor的设置中,Rules for AI是一个文本区域,支持自然语言描述。这里不是写复杂的Prompt模板,而是制定“团队宪法”。例如,你可以写入:“始终使用async/await处理异步操作,禁止使用回调地狱;所有新组件必须包含JSDoc注释;遇到不确定的API调用时,请先解释思路再生成代码。”
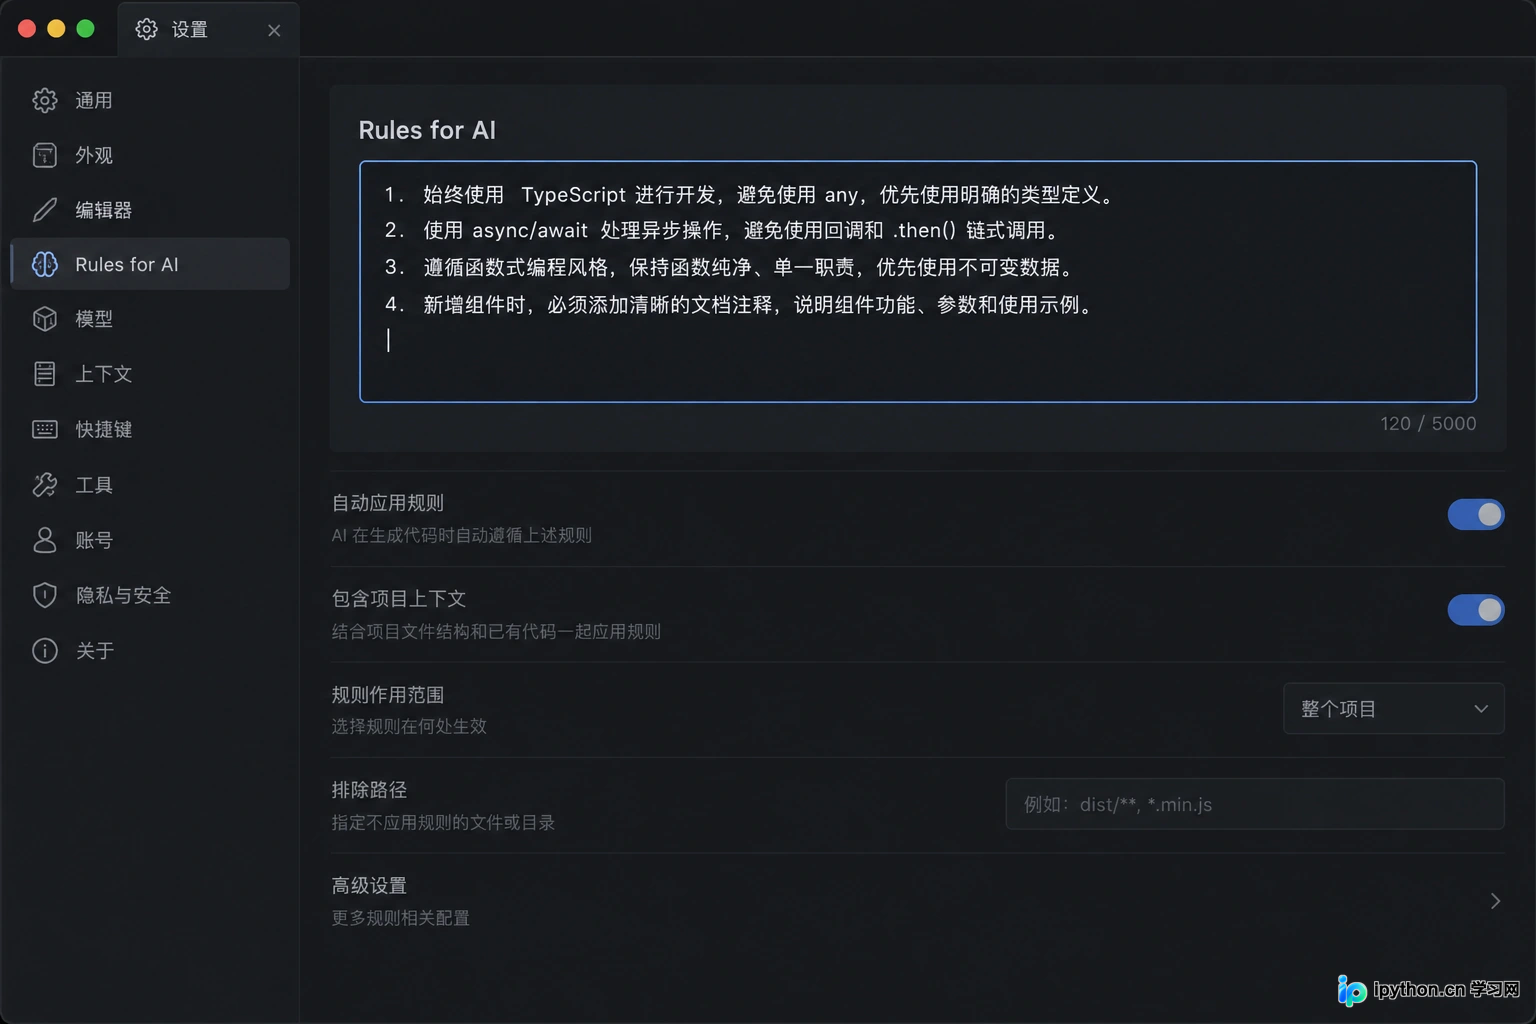
Rules for AI设置界面,展示了自然语言编写的编码规范指令
这些规则会在每一次与AI的交互中自动生效,无需用户手动附加。对于团队协作而言,这是一项巨大的红利。新加入的开发者无需熟悉老项目的隐性编码习惯,因为AI已经内化了这些规范。当AI生成的代码天然符合团队的Lint规则和架构风格时,Code Review的重点就可以从格式审查转移到逻辑正确性上。
需要注意的是,Rules应当保持简洁且具有强制性。过于冗长或模糊的规则(如“写出优雅的代码”)往往效果不佳,而具体的技术性约束(如“禁止使用any类型”)则能显著改善输出质量。定期回顾并精简Rules,随着项目演进剔除过时的约束,是保持AI助手敏锐度的关键。
场景实战:从需求到落地的闭环
理论上的优势需要在具体场景中验证。假设我们需要在一个现有的Vue3项目中新增一个用户管理模块,涉及API调用、状态管理和UI展示。传统方式下,我们需要分别询问API封装写法、Pinia Store结构和组件模板,然后手动拼接,极易出现变量名不一致或导入路径错误。
利用Cursor的组合拳,流程可以大幅压缩。首先,在Rules中确保已设定“使用Composition API”和“Pinia进行状态管理”。接着,在Chat中输入需求,并使用@引用现有的API服务文件、类似的Store文件以及基础UI组件库。此时,AI能够看到项目中已有的axios实例配置、Pinia的store定义模式以及UI组件的Props接口。
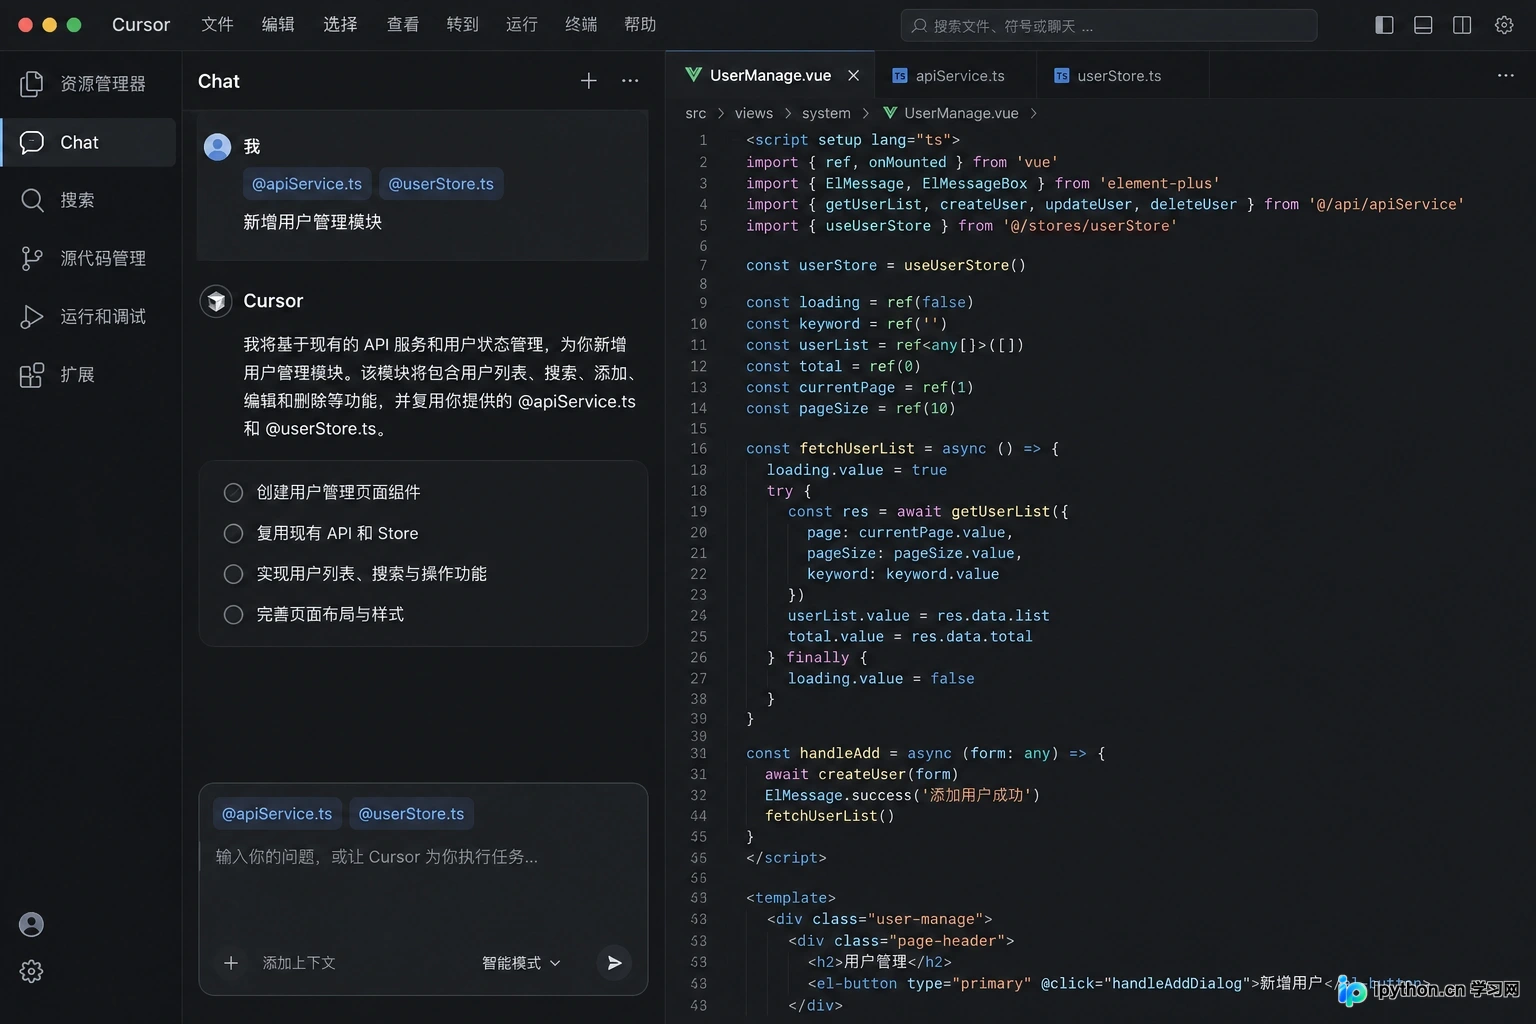
Chat面板中同时引用了API文件和Store文件,了符合项目规范的代码
在这种高上下文的条件下,AI生成的代码将直接复用项目中的useRequest钩子,遵循已有的Store命名规范,并正确导入UI组件。更重要的是,它会避免引入项目中未安装的第三方库,因为它“看”到了package.json的内容(如果也被引用或在上下文中可见)。这种生成结果几乎可以直接复制粘贴到IDE中,仅需微调业务逻辑细节。
这一过程改变了开发的节奏:思考重心从“如何写语法”转移到了“如何组织上下文”。开发者更像是一个架构师,负责搭建信息框架,而AI负责填充具体的实现细节。这种分工不仅提升了速度,更保证了代码与项目整体生态的融合度。
边界的认知:何时不应依赖自动化
尽管@引用和Rules极大地提升了准确率,但它们并非万能。AI的本质仍是概率模型,它在处理高度抽象的业务逻辑、复杂的算法优化或涉及安全敏感的数据处理时,仍存在局限。
当面对全新的、没有任何参考代码的业务领域时,过度依赖@引用可能导致AI陷入局部最优解,无法提出创新性的架构建议。此时,适当放宽上下文,让AI基于通用最佳实践提供多种方案,反而更有价值。此外,对于涉及核心加密、支付逻辑等高风险代码,AI生成的片段必须经过严格的人工审计和安全测试,绝不能因为“符合Rules”就盲目信任。
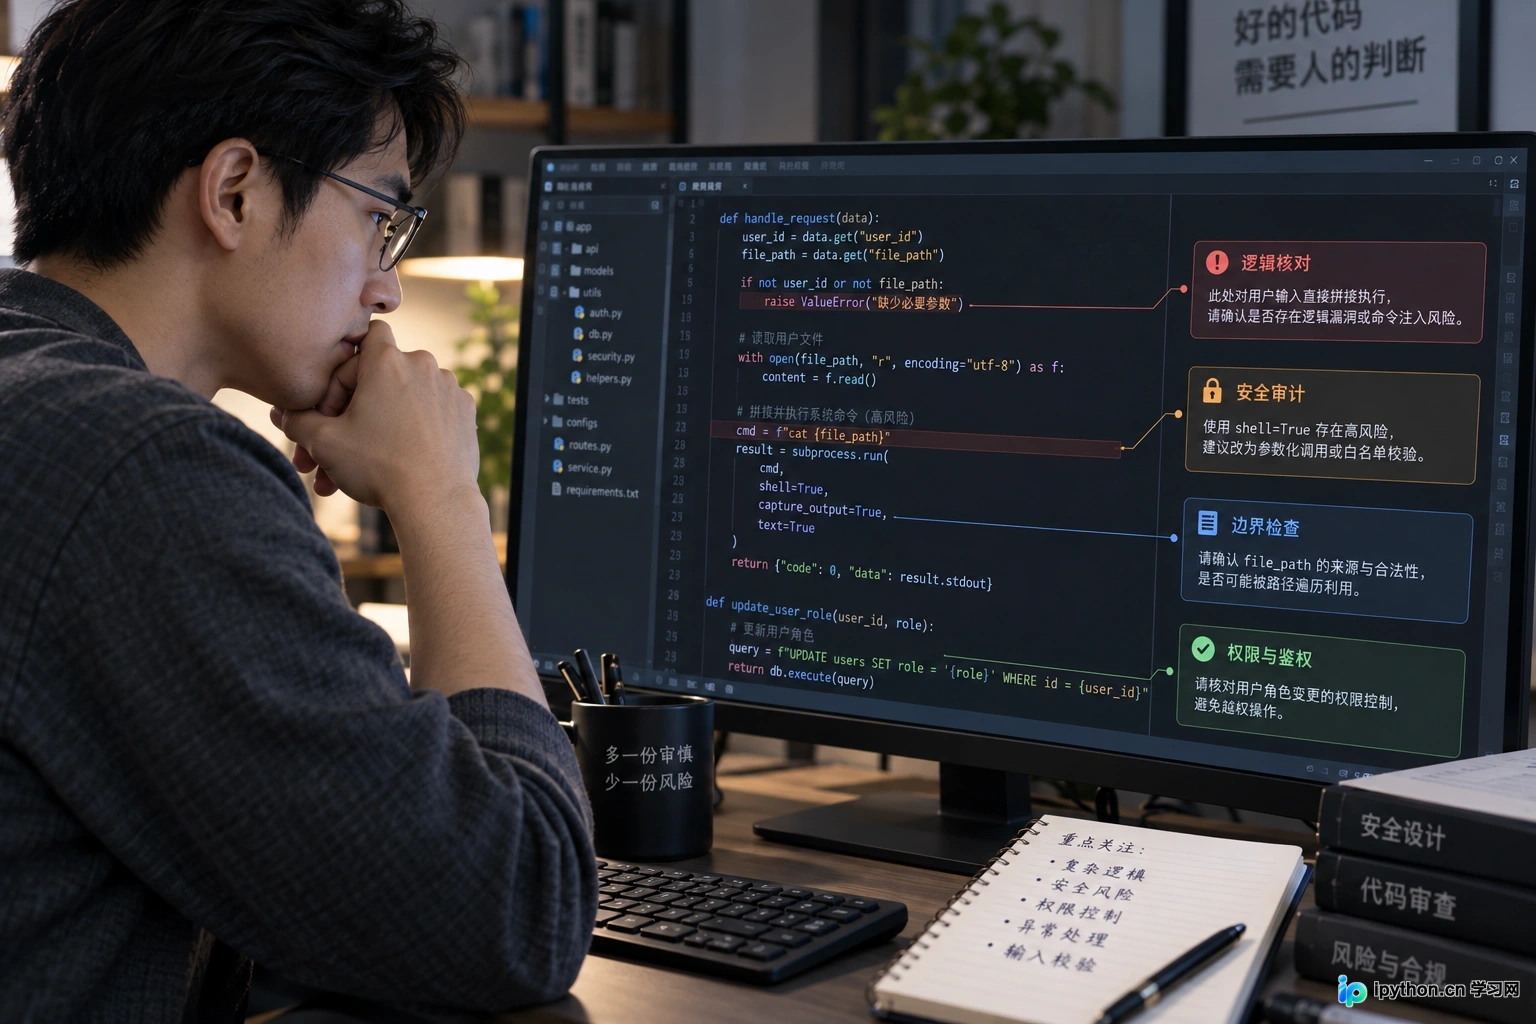
开发者在IDE中仔细检查复杂逻辑代码,体现人机协作中的审计环节
另外,Rules的设定也需要警惕“过度约束”。如果规则过于严苛,可能会抑制AI的灵活性,导致其在面对非标准问题时束手无策或产生奇怪的变通写法。保持规则的适度弹性,允许AI在特定情况下提出质疑或替代方案,是人机协作健康的标志。
回到开头的取舍,我们使用Cursor并非为了完全取代思考,而是为了消除那些重复、机械且易错的编码劳动。通过@引用锁定事实边界,通过Rules固化风格底线,我们将精力释放给了真正需要创造力的部分。准确的代码生成不是终点,而是高效工程实践的起点。 当工具足够透明和可控时,它便不再是黑盒,而是你思维的直接延伸。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















