


Python中X[:,0]和X[:,1]的用法

本文详细解析Python中numpy二维数组的切片语法,重点讲解X[:,0]和X[:,1]如何提取特定列数据,以及X[n,:]和X[:,m:n]的用法。同时补充Python列表的[1:]、[::-1]等切片操作及其在统计场景中的应用示例,帮助开发者掌握高效的数据处理方法。
在numpy库中,X[:,0]是一种针对二维数组的切片写法。其含义是:在第一维度(行)上选取所有数据,在第二维度(列)上仅选取索引为0的元素。直观理解,X[:,0]即提取所有行的第0列数据;同理,X[:,1]则是提取所有行的第1列数据。
举例说明:
import numpy as np

X = np.array([[0,1],[2,3],[4,5],[6,7],[8,9],[10,11],[12,13],[14,15],[16,17],[18,19]])
print X[:,0]
X[:,0]输出结果是:
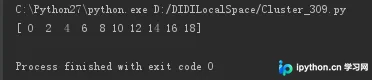
import numpy as np

X = np.array([[0,1],[2,3],[4,5],[6,7],[8,9],[10,11],[12,13],[14,15],[16,17],[18,19]])
print X[:,1]
X[:,1]输出结果是:
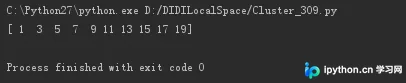
X[n,:]表示提取第一维中索引为n的那一行所有元素。
X[1,:]即取第一维中下标为1的元素的所有值,输出结果:
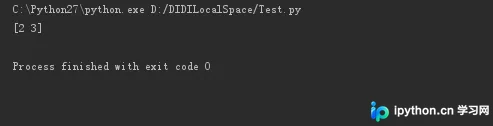
X[:, m:n]用于提取所有行中从第m列到第n-1列的数据,遵循左闭右开原则。
例:输出X数组中所有行第1到2列数据
X = np.array([[0,1,2],[3,4,5],[6,7,8],[9,10,11],[12,13,14],[15,16,17],[18,19,20]])
print X[:,1:3]
输出结果:
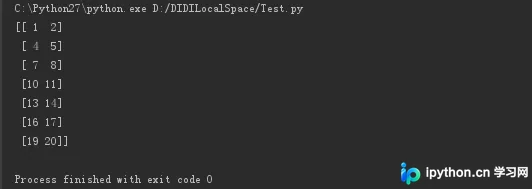
补充:python中的[1:]、[::-1]、X[:,m:n]和X[1,:]
Python中的[1:]
该语法意为去除列表的第一个元素(索引为0),对剩余元素进行操作。以下通过一个遍历统计示例进行说明:
题:读入N名学生的成绩,将获得某一给定分数的学生人数输出。
输入格式:
输入在第1行给出不超过10^5^的正整数N,即学生总人数。随后1行给出N名学生的百分制整数成绩,中间以空格分隔。最后1行给出要查询的分数个数K(不超过N的正整数),随后是K个分数,中间以空格分隔。
输出格式:
在一行中按查询顺序给出得分等于指定分数的学生人数,中间以空格分隔,但行末不得有多余空格。
stu_num = input('请输入学生总人数:')
stu_grade = input('请输入每位学生的成绩(百分制),并以空格分开:').split()  # 将如数的字符串转化成列表
num_and_grade = input('请输入要统计几个分数,以及每个分数值,以空格分开:').split()  # 转成列表格式
result = []  # 定义一个新列表保存结果
for i in num_and_grade[1:]:   # 定义变量i,遍历num_and_grade[]列表中除了第一个元素的其他元素
    result.append(str(stu_grade.count(i)))  # 利用Python的count()函数统计相应i值在列表stu_grade[]列表中的个数,转换成字符串格式并追加到result[]列表中
print(" ".join(result))  # 列表转换成字符串格式,打印结果
结果:
请输入学生总人数:10
请输入每位学生的成绩(百分制),并以空格分开:88 99 75 88 95 42 78 88 95 99
请输入要统计几个分数,以及每个分数值,以空格分开:3 88 99 95
3 2 2
Python中的[::-1]
这是Python切片语法(slice notation)的一种特殊用法。
b = a[i:j] 表示复制a[i]到a[j-1],以生成新的list对象。
当i缺省时,默认为0,即 a[:3]相当于 a[0:3]。
当j缺省时,默认为len(alist), 即a[1:]相当于a[1:10]。
当i,j都缺省时,a[:]就相当于完整复制一份a。
b = a[i:j:s]这种格式呢,i,j与上面的一样,但s表示步进,缺省为1。
所以a[i:j:1]相当于a[i:j]。
当s<0时:i缺省时,默认为-1; j缺省时,默认为-len(a)-1。
所以a[::-1]相当于 a[-1:-len(a)-1:-1],也就是从最后一个元素到第一个元素复制一遍。
a = ['a','b','c','d','e','f','g','h','g','k','l','m']
b = a[:]  # 列表切片,表示把列表a[]的值全部正序复制到列表b[]中
print(b)  # ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'g', 'k', 'l', 'm']
# b = a[n:m]表示列表切片,复制列表a[n]到a[m-1]的内容到新的列表对象b[]
# 当n缺省时,默认为0,即a[:m]
# 当m缺省时,默认到最后,即a[n:]
b1 = a[1:4]
print(b1)  # ['b', 'c', 'd']
b2 = a[:3]
print(b2)  # ['a', 'b', 'c']
b3 = a[1:]
print(b3)  # ['b', 'c', 'd', 'e', 'f', 'g', 'h', 'g', 'k', 'l', 'm']
# b = a[i:j:s]这种格式呢,i,j与上面的一样,但s表示步进,缺省为1,s可以取任何数字.
# 所以a[i:j:1]相当于a[i:j]
b4 = a[1:5:2]
print(b4)  # ['b', 'd']
b5 = a[:5:-1]  # 从末尾倒数取值
print(b5)  # ['m', 'l', 'k', 'g', 'h', 'g']
b6 = a[5::-2]
print(b6)  # 从a[n]处倒数取值
b7 = a[::-1]  # 到这取值
print(b7)  # ['m', 'l', 'k', 'g', 'h', 'g', 'f', 'e', 'd', 'c', 'b', 'a']
输出结果:
['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'g', 'k', 'l', 'm']
['b', 'c', 'd']
['a', 'b', 'c']
['b', 'c', 'd', 'e', 'f', 'g', 'h', 'g', 'k', 'l', 'm']
['b', 'd']
['m', 'l', 'k', 'g', 'h', 'g']
['f', 'd', 'b']
['m', 'l', 'k', 'g', 'h', 'g', 'f', 'e', 'd', 'c', 'b', 'a']
Python中的X[:,m:n]和X[1,:]
在numpy库中,X[:,0]是一种针对二维数组的切片写法。其含义是:在第一维度(行)上选取所有数据,在第二维度(列)上仅选取索引为0的元素。直观理解,X[:,0]即提取所有行的第0列数据;同理,X[:,1]则是提取所有行的第1列数据。
X[n,:]表示提取第一维中索引为n的那一行所有元素。
X[:, m:n]用于提取所有行中从第m列到第n-1列的数据,遵循左闭右开原则。
import numpy as np
X = np.array([[0,1,2,3],[4,5,6,7],[8,9,10,11],[12,13,14,15]])  # 定义二维数组
print(X[:,0])  # 取数组X二维数组中每一个的0号下标对应的值 [0 4 8 12]
print(X[1,:])  # 取数组X一维数组中的第一组全部数值  [0 1 2 3]
print(X[:,1:3])  #取所有数据的第1列到3-1列数据,从第0列开始计算,结果如下:
'''
[[1 2]
 [5 6]
 [9 10]
 [13 14]]
'''
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。如有错误或未考虑完全的地方,望不吝赐教。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















