


Python Pandas中duplicated()与drop_duplicates()的区别详解

发布时间:2026-10-14 |
2人浏览过
本文详细解析Python Pandas中duplicated()与drop_duplicates()函数的核心区别。通过生成测试数据,演示如何判断行重复及删除重复值。重点说明duplicated()返回重复出现的行(仅显示n-1条),而drop_duplicates()直接返回去重后的完整数据框,默认保留第一条记录。
前言
在计算face_track_id映射关系时产生了一些思考,特此记录。
开始验证
data={'state':[1,1,2,2,1,2,2,2],'pop':['a','b','c','d','b','c','d','d']}
frame=pd.DataFrame(data)
frame
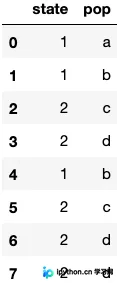
frame.shape
$ (8,2)
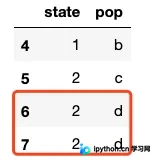
# 说明duplicated()是对整行进行查重,return 重复了的数据,且只现实n-1条重复的数据(n是重复的次数)
frame[frame.duplicated() == True]
起初感到困惑,明明数据对(1,b)仅出现一次,为何会被判定为重复?实际上,该函数返回的结果是剔除了首次出现后的后续重复行。因此直观上容易误以为(1,b)没有重复,但函数逻辑简洁且正确:它返回了所有被视为“冗余”的重复值,且不包含冗余数据本身。
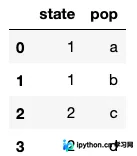
# 说明drop_duplicates()函数是将所有重复的数据都去掉了,且默认保留重复数据的第一条。
# 比如(2,d)出现了3次,在duplicated()中显示了2次,在drop_dupicates()后保留了一个
frame.drop_duplicates().shape
$ (4,2)
# 留下了完全唯一的数据行
frame.drop_duplicates()
补充:Python的Pandas库中处理重复值的常用方法(duplicated()和drop_duplicates())
一、生成包含重复记录的数据集
import numpy as np
import pandas as pd

#生成重复数据
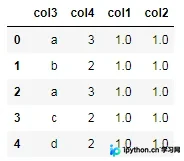
df=pd.DataFrame(np.ones([5,2]),columns=['col1','col2'])
df['col3']=['a','b','a','c','d']
df['col4']=[3,2,3,2,2]
df=df.reindex(columns=['col3','col4','col1','col2'])  #将新增的一列排在第一列
df
输出结果如下:
二、判断重复记录(行)
#判断重复数据
isDplicated=df.duplicated()   #判断重复数据记录
isDplicated
输出结果如下:

三、删除重复值
#删除重复值
new_df1=df.drop_duplicates() #删除数据记录中所有列值相同的记录
new_df2=df.drop_duplicates(['col3']) #删除数据记录中col3列值相同的记录
new_df3=df.drop_duplicates(['col4']) #删除数据记录中col4列值相同的记录
new_df4=df.drop_duplicates(['col3','col4']) #删除数据记录中(col3和col4)列值相同的记录
new_df1
new_df2
new_df3
new_df4
输出结果如下:
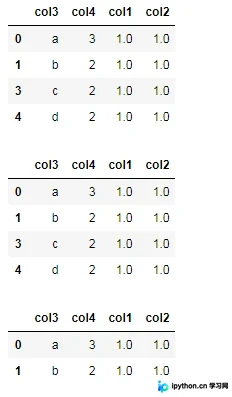
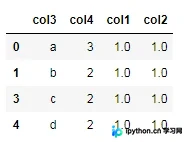
以上为个人经验分享,希望能为大家提供参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















