


OpenCV与YOLOv3实现高效目标检测实战

本文详解如何利用OpenCV的DNN模块加载并运行YOLOv3模型进行目标检测。文章梳理了从R-CNN到YOLO系列算法的演进,重点解析YOLOv3的多尺度预测架构。通过Python代码示例,演示了图像预处理、Blob转换、前向传播及非极大值抑制(NMS)的完整流程,旨在提供一份清晰、可复现的目标检测实现指南。
近期工作中涉及目标检测任务,笔者利用晚间和上午时间快速梳理了相关技术,并成功实现了基于OpenCV的目标检测功能。
鉴于网络资料繁杂,检索资源耗时较多,特此整理这段时间的学习成果与实践经验,供有兴趣的读者参考学习。
目标检测概况
目标检测定义
简而言之,目标检测的任务是接收图片或视频输入,经过算法处理,输出目标的位置坐标(如左上角和右下角坐标)、预测类别以及预测置信度(confidence)。
以Faster R-CNN算法为例:输入一个batch(batch size可为1)的图片或视频,网络直接输出格式为:[batchId, classId, confidence, left, top, right, bottom],其中batchId、classId、confidence、left、top、right、bottom均为标量。batchId表示该batch中图片的索引(index),后四个标量代表目标位置信息,即左上角和右下角像素点的坐标。
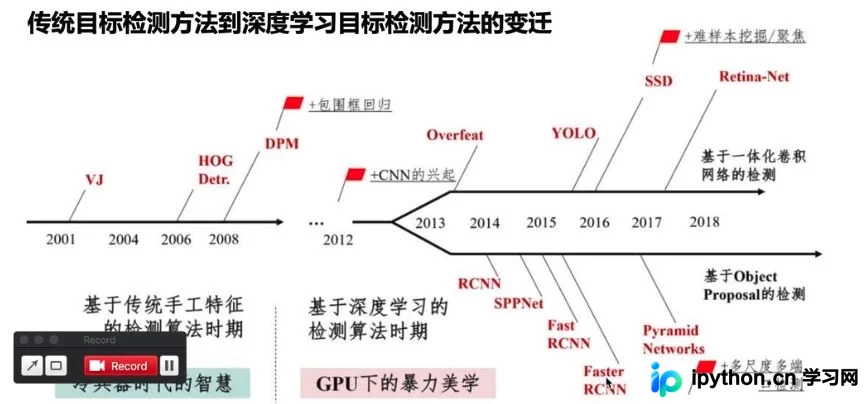
目标检测算法演进
从历史脉络来看:
早期采用手工特征提取算法,如VJ、HOG、DPM。
R-CNN算法(2014年)是最早的基于深度学习目标检测器之一,采用两级网络结构:1)需借助选择性搜索等算法提出可能包含对象的候选边界框;2)将这些区域输入CNN进行分类。
R-CNN算法的主要问题是仿真速度慢,且并非完整的端到端目标检测器。
Fast R-CNN算法(2014年末)对原始R-CNN进行了显著改进,提升了准确度并减少了前向传播所需时间。
然而,该模型仍依赖外部区域搜索算法。
Faster R-CNN算法(2015年)实现了真正的端到端深度学习目标检测。它摒弃了选择性搜索,转而依赖:
(1)完全卷积的区域提议网络(RPN, Region Proposal Network),用于预测对象边界框及“对象”分数(量化该区域包含物体的可能性)。
(2)将RPN的输出传递给R-CNN组件以进行最终分类和标记。
R-CNN系列算法均采用two-stage策略。其特点是检测结果通常非常准确,但仿真速度极慢,即使在GPU上也仅能达到5 FPS。
One-stage方法包括:YOLO(2015)、SSD(2015年末),以及基于这两者改进的各论文提出的算法。这些算法的基本思路是:在图片不同位置进行密集均匀抽样,抽样时可采用不同尺度和长宽比,随后利用CNN提取特征并直接进行分类与回归。
整个过程仅需一步,因此优势在于速度快,但训练难度较大。
YOLOv3(2018年)是YOLO作者提出的第三个版本(此前还提出过YOLOv2及其tinny版本,tinny版本经压缩后速度更快但准确率降低)。YOLOv3支持80类物体的目标检测,完整类别列表[戳这里]: https://github.com/pjreddie/darknet/blob/master/data/coco.names
时间线:
YOLOv3模型简介
性能介绍
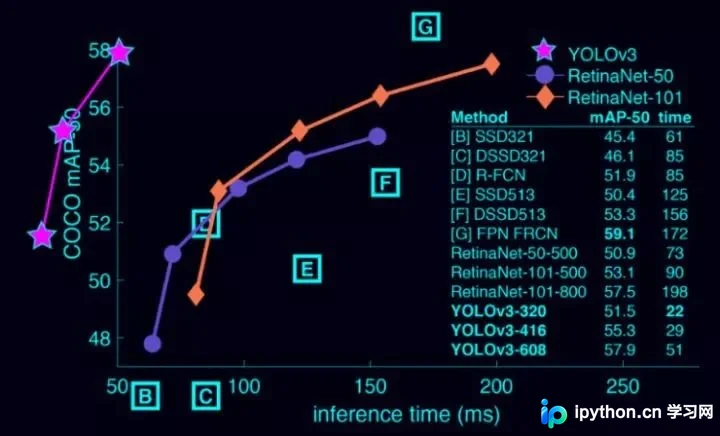
首先,YOLOv3功能强大(否则无需使用)。速度方面,它比R-CNN快1000倍,比Fast R-CNN快100倍。在检测准确率方面,它并非最高:YOLOv3-608比DSSD更高,接近FPN。但其速度不足后两者的1/3。
从下图也可以看出:
架构介绍
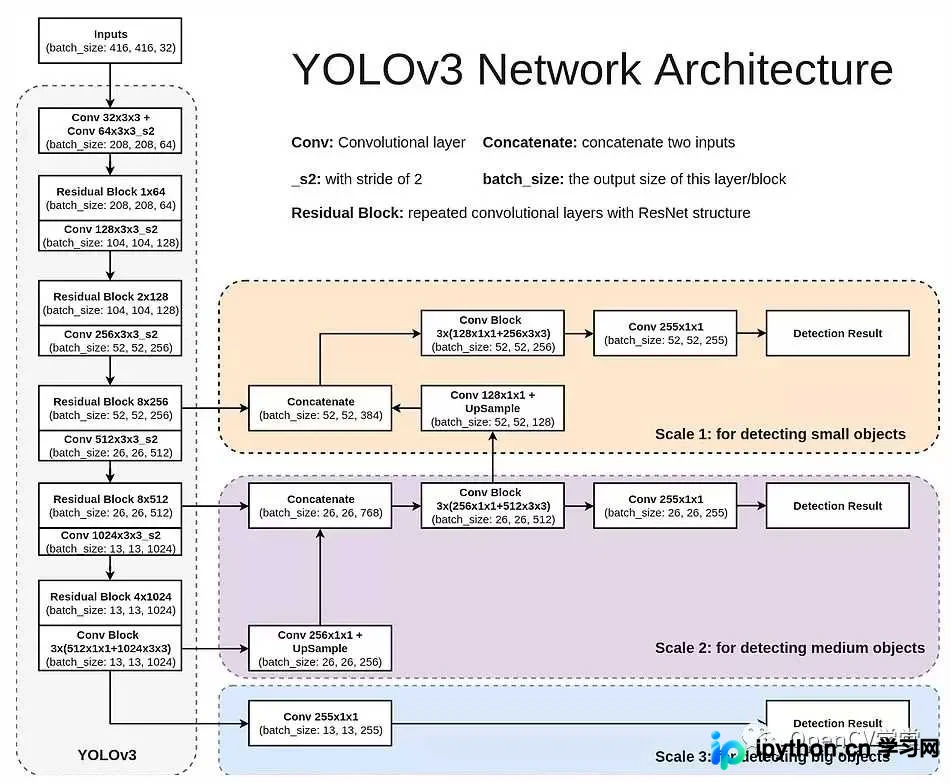
可以看出,其架构由一系列卷积、残差连接、上采样组成。特点在于,它将预测分为三个尺度(Scale)进行(见图中三个彩色框),并在三个scale分别输出。
OpenCV-Python实现
为何选择OpenCV?
OpenCV(3.4.2+版本)的DNN(Deep Neural Network-DNN)模块封装了Darknet框架,该框架是:
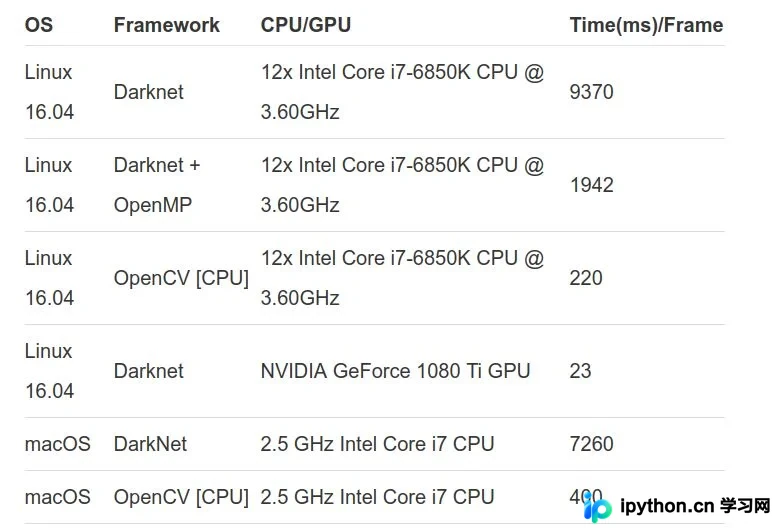
自主开发的,封装了YOLO算法。基于这一层关系,我们可以使用OpenCV方便地调用YOLO的各个版本,且有数据(见下)证明OpenCV的DNN模块在CPU上的实现速度比使用OpenML的Darknet快9倍。
正文
我将先结合脚本片段进行讲解,随后给出该脚本的完整代码。
首先
引入库
import numpy as np
import cv2 as cv
import os
import time
参数设置:
yolo_dir = '/home/hessesummer/github/NTS-Net-my/yolov3'  # YOLO文件路径
weightsPath = os.path.join(yolo_dir, 'yolov3.weights')  # 权重文件
configPath = os.path.join(yolo_dir, 'yolov3.cfg')  # 配置文件
labelsPath = os.path.join(yolo_dir, 'coco.names')  # label名称
imgPath = os.path.join(yolo_dir, 'test.jpg')  # 测试图像
CONFIDENCE = 0.5  # 过滤弱检测的最小概率
THRESHOLD = 0.4  # 非最大值抑制阈值
权重文件、配置文件、label名称的下载地址:
wget https://pjreddie.com/media/files/yolov3.weights
wget https://github.com/pjreddie/darknet/blob/master/cfg/yolov3.cfg
wget https://github.com/pjreddie/darknet/blob/master/data/coco.names
简单来说:
过滤弱检测的最小概率:置信度低于此值的输出将被丢弃; 非最大值抑制阈值:允许边界框重叠的程度(多框检测同一物体),供后续NMS算法使用,该算法会根据此值合并有重叠的框。值为0时,不允许框重叠。默认值为0.3。
详细来说:
此处未深入查阅。读者若感兴趣可自行了解。
核心部分1:
# 加载网络、配置权重
net = cv.dnn.readNetFromDarknet(configPath, weightsPath)  ## 利用下载的文件
# print("[INFO] loading YOLO from disk...") ## 可以打印下信息

# 加载图片、转为blob格式、送入网络输入层
img = cv.imread(imgPath)
blobImg = cv.dnn.blobFromImage(img, 1.0/255.0, (416, 416), None, True, False)  ## net需要的输入是blob格式的,用blobFromImage这个函数来转格式
net.setInput(blobImg)  ## 调用setInput函数将图片送入输入层

# 获取网络输出层信息(所有输出层的名字),设定并前向传播
outInfo = net.getUnconnectedOutLayersNames()  ## 前面的yolov3架构也讲了,yolo在每个scale都有输出,outInfo是每个scale的名字信息,供net.forward使用
# start = time.time()
layerOutputs = net.forward(outInfo)  # 得到各个输出层的、各个检测框等信息,是二维结构。
# end = time.time()
# print("[INFO] YOLO took {:.6f} seconds".format(end - start)) ## 可以打印下信息layerOutputs是二维结构,第0维代表输出层,第1维代表各个检测框。
其他细节均在注释中讲解。
核心部分2:
# 拿到图片尺寸
(H, W) = img.shape[:2]
供后续使用:
# 过滤layerOutputs
# layerOutputs的第1维的元素内容: [center_x, center_y, width, height, objectness, N-class score data]
# 过滤后的结果放入:
boxes = [] # 所有边界框(各层结果放一起)
confidences = [] # 所有置信度
classIDs = [] # 所有分类ID

# # 1)过滤掉置信度低的框框
for out in layerOutputs:  # 各个输出层
    for detection in out:  # 各个框框
        # 拿到置信度
        scores = detection[5:]  # 各个类别的置信度
        classID = np.argmax(scores)  # 最高置信度的id即为分类id
        confidence = scores[classID]  # 拿到置信度

        # 根据置信度筛查
        if confidence > CONFIDENCE:
            box = detection[0:4] * np.array([W, H, W, H])  # 将边界框放会图片尺寸
            (centerX, centerY, width, height) = box.astype("int")
            x = int(centerX - (width / 2))
            y = int(centerY - (height / 2))
            boxes.append([x, y, int(width), int(height)])
            confidences.append(float(confidence))
            classIDs.append(classID)

# # 2)应用非最大值抑制(non-maxima suppression,nms)进一步筛掉
idxs = cv.dnn.NMSBoxes(boxes, confidences, CONFIDENCE, THRESHOLD) # boxes中,保留的box的索引index存入idxs
这里的NMS算法即前文提到的非极大值抑制算法。
应用检测结果,此处用于绘制边界框。
# 得到labels列表
with open(labelsPath, 'rt') as f:
    labels = f.read().rstrip('\n').split('\n')
供后续使用:
# 应用检测结果
np.random.seed(42)
COLORS = np.random.randint(0, 255, size=(len(labels), 3), dtype="uint8")  # 框框显示颜色,每一类有不同的颜色,每种颜色都是由RGB三个值组成的,所以size为(len(labels), 3)
if len(idxs) > 0:
    for i in idxs.flatten(): # indxs是二维的,第0维是输出层,所以这里把它展平成1维
        (x, y) = (boxes[i][0], boxes[i][1])
        (w, h) = (boxes[i][2], boxes[i][3])

        color = [int(c) for c in COLORS[classIDs[i]]]
        cv.rectangle(img, (x, y), (x+w, y+h), color, 2)  # 线条粗细为2px
        text = "{}: {:.4f}".format(labels[classIDs[i]], confidences[i])
        cv.putText(img, text, (x, y-5), cv.FONT_HERSHEY_SIMPLEX, 0.5, color, 2)  # cv.FONT_HERSHEY_SIMPLEX字体风格、0.5字体大小、粗细2px
cv.imshow('目标检测结果', img)
cv.waitKey(0)
第一部分讲解结束,下面展示完整代码:
随后
import numpy as np
import cv2 as cv
import os
import time

yolo_dir = '/home/hessesummer/github/NTS-Net-my/yolov3'  # YOLO文件路径
weightsPath = os.path.join(yolo_dir, 'yolov3.weights')  # 权重文件
configPath = os.path.join(yolo_dir, 'yolov3.cfg')  # 配置文件
labelsPath = os.path.join(yolo_dir, 'coco.names')  # label名称
imgPath = os.path.join(yolo_dir, 'test.jpg')  # 测试图像
CONFIDENCE = 0.5  # 过滤弱检测的最小概率
THRESHOLD = 0.4  # 非最大值抑制阈值

# 加载网络、配置权重
net = cv.dnn.readNetFromDarknet(configPath, weightsPath)  # #  利用下载的文件
print("[INFO] loading YOLO from disk...")  # # 可以打印下信息

# 加载图片、转为blob格式、送入网络输入层
img = cv.imread(imgPath)
blobImg = cv.dnn.blobFromImage(img, 1.0/255.0, (416, 416), None, True, False)   # # net需要的输入是blob格式的,用blobFromImage这个函数来转格式
net.setInput(blobImg)  # # 调用setInput函数将图片送入输入层

# 获取网络输出层信息(所有输出层的名字),设定并前向传播
outInfo = net.getUnconnectedOutLayersNames()  # # 前面的yolov3架构也讲了,yolo在每个scale都有输出,outInfo是每个scale的名字信息,供net.forward使用
start = time.time()
layerOutputs = net.forward(outInfo)  # 得到各个输出层的、各个检测框等信息,是二维结构。
end = time.time()
print("[INFO] YOLO took {:.6f} seconds".format(end - start))  # # 可以打印下信息

# 拿到图片尺寸
(H, W) = img.shape[:2]
# 过滤layerOutputs
# layerOutputs的第1维的元素内容: [center_x, center_y, width, height, objectness, N-class score data]
# 过滤后的结果放入:
boxes = [] # 所有边界框(各层结果放一起)
confidences = [] # 所有置信度
classIDs = [] # 所有分类ID

# # 1)过滤掉置信度低的框框
for out in layerOutputs:  # 各个输出层
    for detection in out:  # 各个框框
        # 拿到置信度
        scores = detection[5:]  # 各个类别的置信度
        classID = np.argmax(scores)  # 最高置信度的id即为分类id
        confidence = scores[classID]  # 拿到置信度

        # 根据置信度筛查
        if confidence > CONFIDENCE:
            box = detection[0:4] * np.array([W, H, W, H])  # 将边界框放会图片尺寸
            (centerX, centerY, width, height) = box.astype("int")
            x = int(centerX - (width / 2))
            y = int(centerY - (height / 2))
            boxes.append([x, y, int(width), int(height)])
            confidences.append(float(confidence))
            classIDs.append(classID)

# # 2)应用非最大值抑制(non-maxima suppression,nms)进一步筛掉
idxs = cv.dnn.NMSBoxes(boxes, confidences, CONFIDENCE, THRESHOLD) # boxes中,保留的box的索引index存入idxs
# 得到labels列表
with open(labelsPath, 'rt') as f:
    labels = f.read().rstrip('\n').split('\n')
# 应用检测结果
np.random.seed(42)
COLORS = np.random.randint(0, 255, size=(len(labels), 3), dtype="uint8")  # 框框显示颜色,每一类有不同的颜色,每种颜色都是由RGB三个值组成的,所以size为(len(labels), 3)
if len(idxs) > 0:
    for i in idxs.flatten():  # indxs是二维的,第0维是输出层,所以这里把它展平成1维
        (x, y) = (boxes[i][0], boxes[i][1])
        (w, h) = (boxes[i][2], boxes[i][3])

        color = [int(c) for c in COLORS[classIDs[i]]]
        cv.rectangle(img, (x, y), (x+w, y+h), color, 2)  # 线条粗细为2px
        text = "{}: {:.4f}".format(labels[classIDs[i]], confidences[i])
        cv.putText(img, text, (x, y-5), cv.FONT_HERSHEY_SIMPLEX, 0.5, color, 2)  # cv.FONT_HERSHEY_SIMPLEX字体风格、0.5字体大小、粗细2px
cv.imshow('detected image', img)
cv.waitKey(0)
结果展示:
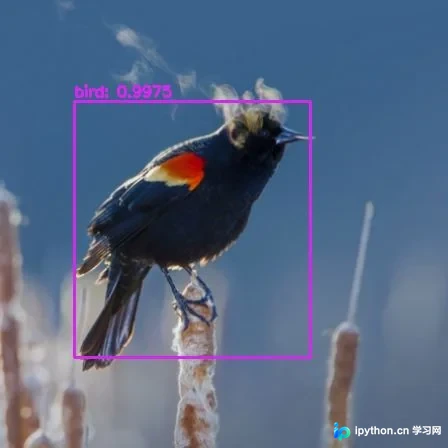
到此关于OpenCV-Python+YOLOv3实现目标检测的文章介绍完毕,更多相关OpenCV YOLOv3目标检测内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















