


使用pandas生成与读取CSV文件的两种方法

本文介绍如何使用Python的pandas库生成和读取CSV文件。通过构造列表嵌套字典数据,利用pd.DataFrame转换为二维结构,并使用to_csv方法保存为CSV文件,支持指定编码以解决中文乱码问题。同时展示了通过read_table读取CSV文件的示例,涵盖写入与读取的核心代码及实际应用。
前言
CSV是一种接触较早的文件格式,其优势在于既可以通过电子表格软件查看,也能以纯文本形式直接打开和编辑。
首先需要引入pandas库以进行后续操作。
import pandas as pd
方法一:
首先构造一个名为cont_list的变量,其结构为列表嵌套字典,其中每个字典代表一个样本,这种结构类似于爬虫获取的数据格式。
接着利用pd.DataFrame方法将数据转换为二维结构数据,如打印结果所示。通过columns参数指定列名,该参数必须接收一个列表。
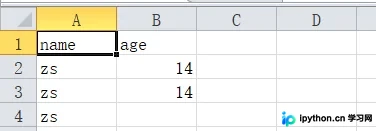
使用to_csv方法可以直接将数据保存为CSV文件,设置index=False表示在生成的文件中不包含行序号。
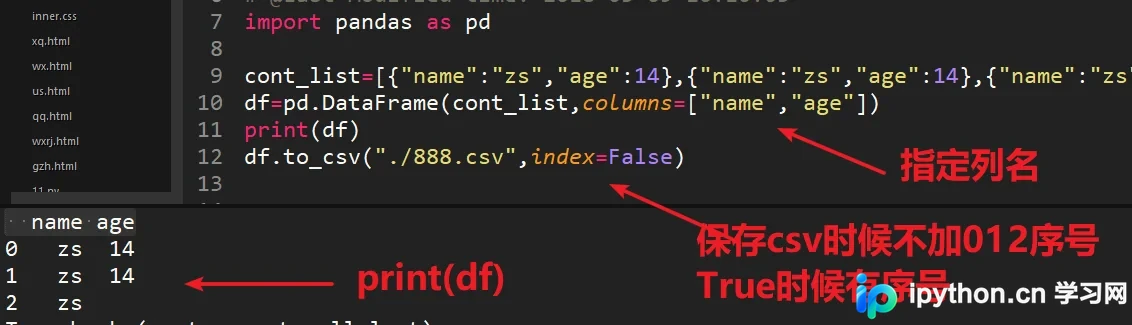
保存CSV结果
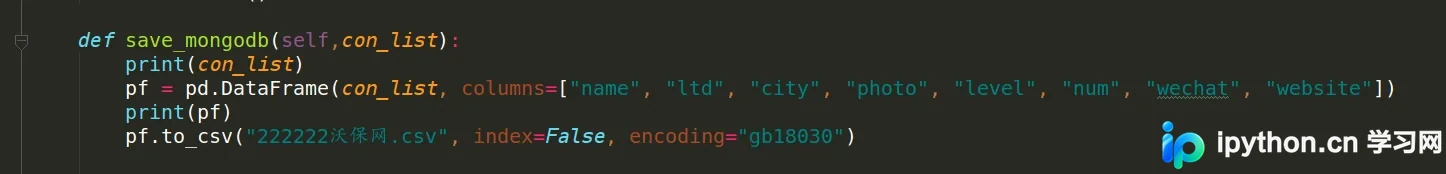
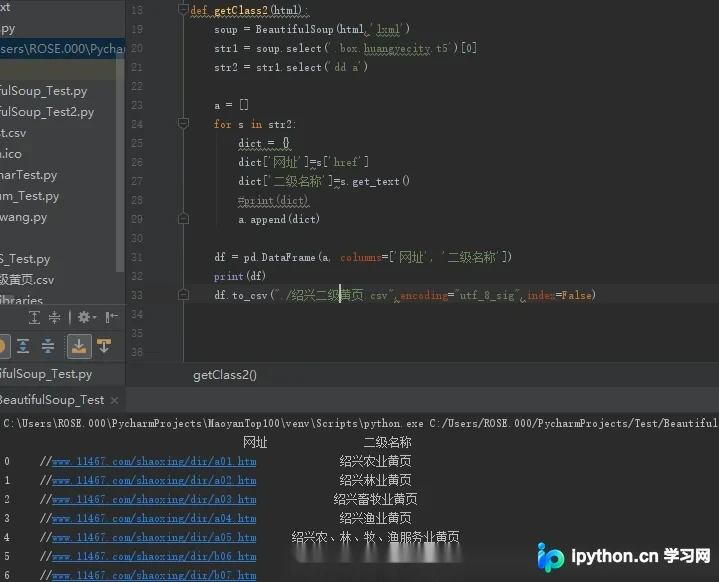
将此方法应用于爬虫代码时,传入的con_list结构为[{},{},{}****]。为了解决中文编码问题,可以指定encoding="utf_8_sig"或encoding="gb18030"。
这种方法非常便捷,仅需2行代码即可完成保存,相比之前介绍的方法更为简单。实际上,Python拥有众多优秀库,这使得它在数据分析领域具有显著优势。
方法二:
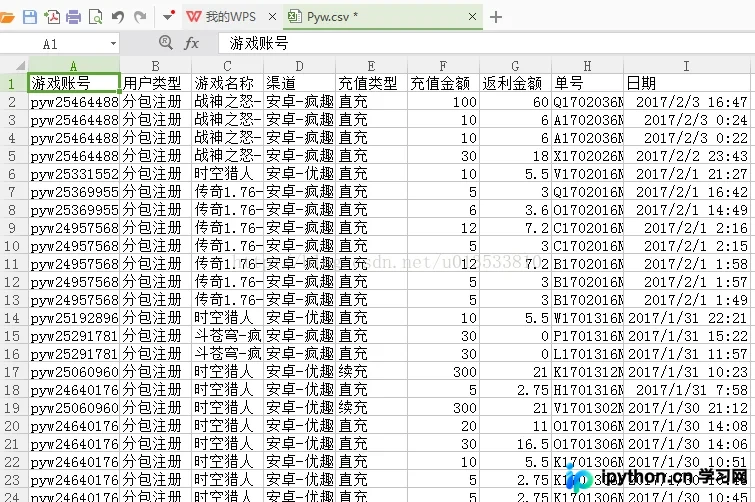
流程包括:模拟登录、获取HTML页面、使用正则解析所有符合条件的行、逐一将符合条件的行的所有列存入到CSVData[]临时变量中,最后写入到CSV文件中。
核心代码:
####写入csv文件中

with open(self.CsvFileName, 'wb') as csvfile:

spamwriter = csv.writer(csvfile, dialect='excel')

#设置标题

spamwriter.writerow(["游戏账号","用户类型","游戏名称","渠道","充值类型","充值金额","返利金额","单号","日期"])

#将CsvData中的数据循环写入到CsvFileName文件中

for item in self.CsvData:

spamwriter.writerow(item)
完整代码:
# coding=utf-8

import urllib

import urllib2

import cookielib

import re

import csv

import sys


class Pyw():

#初始化数据

def __init__(self):

#登录的Url地址

self.LoginUrl="http://v.pyw.cn/login/check"

#所要获取的Url地址

self.PageUrl="http://v.pyw.cn/Data/accountdetail/%s"

# 传输的数据:用户名、密码、是否记住用户名

self.PostData = urllib.urlencode({

"username": "15880xxxxxx",

"password": "a123456",

"remember": "1"

})

#第几笔记录

self.PageIndex=0;

#循环获取共4页内容

self.PageTotal=1

#正则解析出tr

self.TrExp=re.compile("(?isu)<tr[^>]*>(.*?)</tr>")

#正则解析出td

self.TdExp = re.compile("(?isu)<td[^>]*>(.*?)</td>")

#创建cookie

self.cookie = cookielib.CookieJar()

#构建opener

self.opener=urllib2.build_opener(urllib2.HTTPCookieProcessor(self.cookie))

#解析页面总页数

self.Total=4

#####设置csv文件

self.CsvFileName="Pyw.csv"

#####存储Csv数据

self.CsvData=[]


#解析网页中的内容

def GetPageItem(self,PageHtml):

#循环取出Table中的所有行

for row in self.TrExp.findall(PageHtml):

#取出当前行的所有列

coloumn=self.TdExp.findall(row)

#判断符合的记录

if len(coloumn) == 9:

# print "游戏账号:%s" % coloumn[0].strip()

# print "用户类型:%s" % coloumn[1].strip()

# print "游戏名称:%s" % coloumn[2].strip()

# print "渠道:%s" % coloumn[3].strip()

# print "充值类型:%s" % coloumn[4].strip()

# print "充值金额:%s" % coloumn[5].strip().replace("¥", "")

# print "返利金额:%s" % coloumn[6].strip().replace("¥", "")

# print "单号:%s" % coloumn[7].strip()

# print "日期:%s" % coloumn[8].strip()

#拼凑行数据

d=[coloumn[0].strip(),

coloumn[1].strip(),

coloumn[2].strip(),

coloumn[3].strip(),

coloumn[4].strip(),

coloumn[5].strip().replace("¥", ""),

coloumn[6].strip().replace("¥", ""),

coloumn[7].strip(),

coloumn[8].strip()]

self.CsvData.append(d)


#模拟登录并获取页面数据

def GetPageHtml(self):

try:

#模拟登录

request=urllib2.Request(url=self.LoginUrl,data=self.PostData)

ResultHtml=self.opener.open(request)

#开始执行获取页面数据

while self.PageTotal<=self.Total:

#动态拼凑所要解析的Url

m_PageUrl = self.PageUrl % self.PageTotal

#计算当期第几页

self.PageTotal = self.PageTotal + 1

#获取当前解析页面的所有内容

ResultHtml=self.opener.open(m_PageUrl)

#解析网页中的内容

self.GetPageItem(ResultHtml.read())


####写入Csv文件中

with open(self.CsvFileName, 'wb') as csvfile:

spamwriter = csv.writer(csvfile, dialect='excel')

#设置标题

spamwriter.writerow(["游戏账号","用户类型","游戏名称","渠道","充值类型","充值金额","返利金额","单号","日期"])

#将CsvData中的数据循环写入到CsvFileName文件中

for item in self.CsvData:

spamwriter.writerow(item)


print "成功导出CSV文件!"

except Exception,e:

print "404 error!%s" % e

#实例化类

p=Pyw()

#执行方法

p.GetPageHtml()
导出结果
读取CSV
import pandas as pd

data = pd.read_table('地址', sep=",")['网址'].values

print(data[1])
总结
到此这篇关于使用pandas生成/读取csv文件的文章就介绍到这了,更多相关pandas生成读取csv文件内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















