


MySQL索引失效的常见场景及优化原则

在 MySQL 数据库运维与业务开发中,给查询字段建立了索引却未生效,往往会导致全表扫描和系统延迟陡增。排查并解决此类问题的核心路径在于:先用 EXPLAIN 分析实际使用的索引与访问类型,识别出违背 B+ 树有序性检索的具体写法,再按规范重写 SQL 或调整复合索引设计。
一、如何验证索引是否真正失效
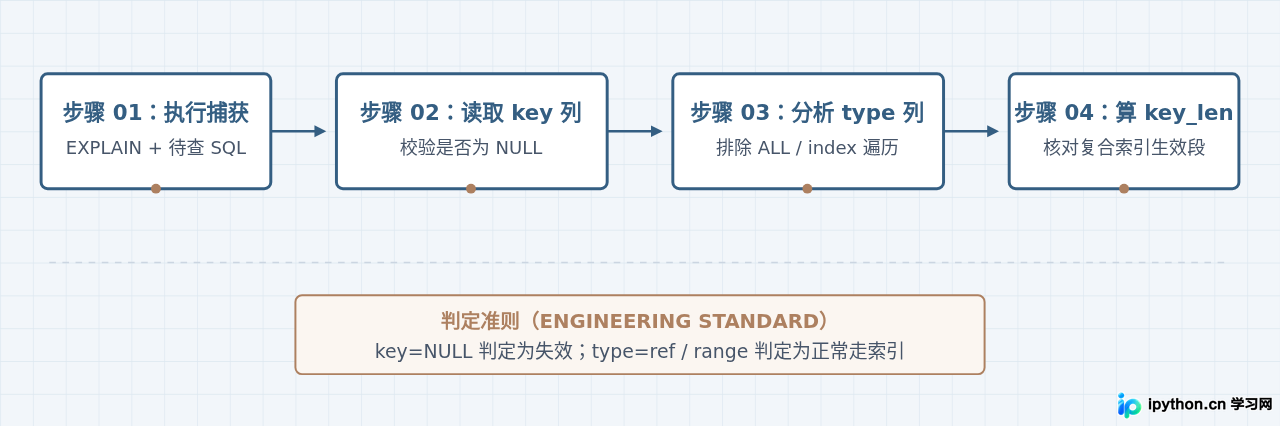
在判断 SQL 语句是否走索引时,不能只凭执行耗时推断,因为数据量较小或系统存在查询缓存时耗时差异并不明显。MySQL 官方提供了 EXPLAIN 关键字,用于输出优化器生成的执行计划。
通过分析 EXPLAIN 结果中的三个核心指标,可以准确确定索引的使用状态:
- type(访问类型):由好到差依次为
system>const>eq_ref>ref>range>index>ALL。当该列显示为ALL时,表示进行了全表扫描,索引完全未被采用;若为index,则表示遍历了整棵索引树。 - key(实际使用的索引):如果该字段为
NULL,说明 MySQL 优化器没有使用任何索引。 - key_len(使用的索引字节长度):用于在联合索引中判断究竟命中了前几个字段。
二、常见索引失效场景与原因剖析
在 InnoDB 引擎中,索引基于 B+ 树构建。B+ 树要求在构建和查找时,节点关键字具备确定的大小比较关系。一旦 SQL 语句破坏了“先按既定顺序查找”的前提,或者让优化器认为全表扫描成本更低,索引就会失效。
场景 1:违背最左前缀原则
在联合索引 idx_dept_age_name(department_id, age, name) 中,B+ 树是先按 department_id 排序,在 department_id 相同的情况下再按 age 排序,最后按 name 排序。如果查询条件直接跳过最左侧的 department_id,优化器无法利用现有的有序结构,导致索引失效。
-- 示例表索引:idx_dept_age_name(department_id, age, name)

-- 失效:跳过了最左侧字段 department_id,索引完全不生效 (type=ALL)
EXPLAIN SELECT * FROM staff WHERE age = 30 AND name = '张伟';

-- 部分失效:命中了 department_id,但跳过了 age,仅 department_id 走索引
EXPLAIN SELECT * FROM staff WHERE department_id = 10 AND name = '张伟';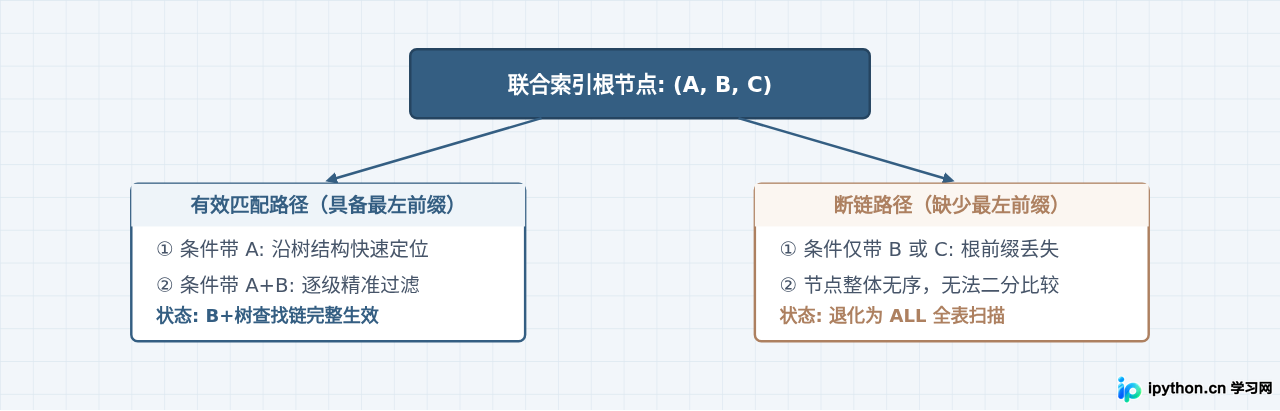
场景 2:在索引列上进行运算或使用内置函数
索引保存的是字段的原始值,而不是经过函数计算后的结果。一旦在查询条件的列上包裹函数或进行算术表达式计算,MySQL 就必须对表中的每一行记录执行该运算后再作比较,导致索引无法直接比对定位。
-- 假设 create_time 列存在独立索引 idx_create_time

-- 失效写法:对索引字段使用 DATE() 函数
EXPLAIN SELECT id FROM orders WHERE DATE(create_time) = '2026-03-01';

-- 正确写法:将运算推导移至常量侧,保持索引列裸露
EXPLAIN SELECT id FROM orders
WHERE create_time >= '2026-03-01 00:00:00' AND create_time <= '2026-03-01 23:59:59';
场景 3:隐式类型转换(隐式 Cast)
当字段的数据类型与传入常量的类型不一致时,MySQL 内部会调用类型转换机制。在字符串与数字比较时,MySQL 会将字符串隐式转换为浮点数再进行比对,这等效于在字段外包裹了转换函数 CAST()。
-- 假设 mobile 为 VARCHAR(20),存在索引 idx_mobile

-- 失效写法:传入整数,触发 CAST(mobile AS SIGNED)
EXPLAIN SELECT * FROM users WHERE mobile = 13800000000;

-- 正确写法:严格传入匹配的字符串字面量
EXPLAIN SELECT * FROM users WHERE mobile = '13800000000';
场景 4:模糊查询前置通配符(LIKE '%abc')
B+ 树对字符串建立索引时,是按照从左至右的字符编码逐位排序的。若匹配模式为 '138%',优化器可以根据开头的 138 缩小检索范围;但如果以 % 开头,意味着前缀未知,整个索引树中的每一项都有可能是目标值,因而只能全表扫描。
场景 5:OR 连接条件中存在未建索引的列
使用 OR 连接多个条件时,MySQL 必须保证所有分支都能使用索引(通过 index_merge 机制合并)。若其中任意一个字段没有索引,整条查询就必须走全表扫描来获取没有索引的那部分数据,因此即使前面的列有索引也会被放弃。
-- 假设 a 列有索引,b 列无索引
-- 失效:必须全表扫描获取 b=2 的记录,导致 a 的索引也无法生效
SELECT * FROM t WHERE a = 1 OR b = 2;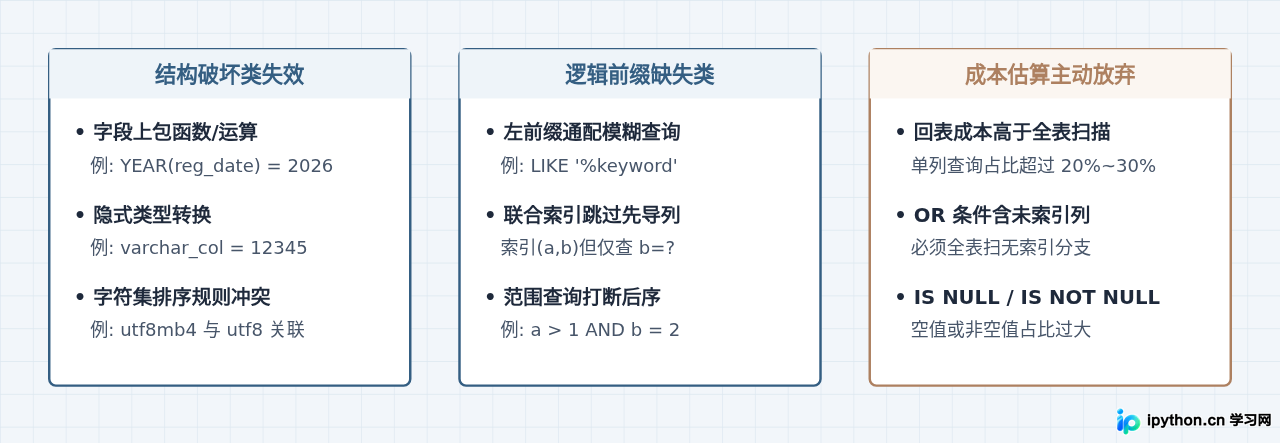
IS NULL 或 NOT IN 一定不走索引,这种说法不准确。MySQL 会统计字段中 NULL 值的分布比例。如果表中 NULL 值极少,执行 IS NULL 往往会走索引范围扫描(type=ref 或 range);反之,如果绝大多数记录都是 NULL,优化器判定走索引后的大量回表开销高于全表扫描,才会放弃使用索引。
三、核心优化原则与工程实践
规避索引失效不仅需要纠正 SQL 写法,更需要在表结构和索引设计阶段就遵循合理的工程规范。
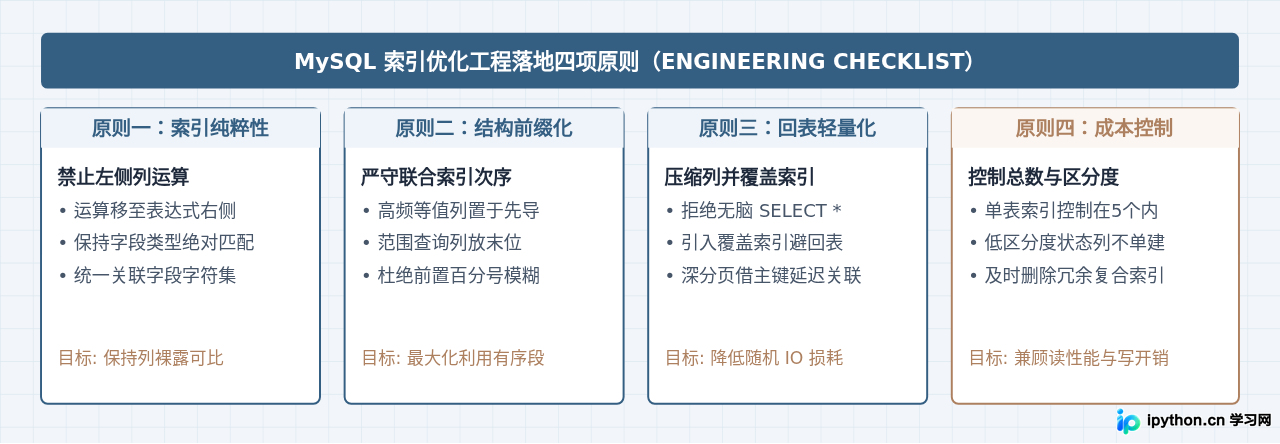
1. 优先采用覆盖索引,消除回表开销
当二级索引本身的叶子节点已包含查询所需的所有字段时,存储引擎无需再拿着主键 ID 回到主键索引树(聚簇索引)去查找整行数据,这种机制被称为覆盖索引(Covering Index)。在 EXPLAIN 的 Extra 列中出现 Using index,即代表命中了覆盖索引。
-- 联合索引:idx_user_status(user_id, status)

-- 覆盖索引:查询字段全在索引内,无须回表,效率极高
EXPLAIN SELECT user_id, status FROM user_accounts WHERE user_id = 1001;

-- 非覆盖索引:由于 SELECT * 需要读取其他字段,当命中数据较多时可能退化为全表扫描
EXPLAIN SELECT * FROM user_accounts WHERE user_id = 1001;
2. 建立高区分度索引,遵循最左前缀排布
字段的区分度越高,过滤后剩余的行数就越少,扫描成本也就越低。区分度的计算公式为:
区分度 = COUNT(DISTINCT column_name) / COUNT(*)
区分度越接近 1,说明该列越适合建立索引。性别、布尔状态值等区分度极低的字段单独建索引意义不大。在设计复合索引时,应将区分度最高、使用频率最高、用于等值匹配的字段放在最左侧,将用于范围查询的字段放在最右侧。
3. 严格遵循字段与参数一致性规范
在设计数据库表和接口通信时,必须保证应用层传入的参数类型与数据库字段类型严格对应。多表关联(JOIN)操作中,参与关联的两个字段不仅数据类型必须一致,字符集(如 utf8mb4)和排序规则(如 utf8mb4_unicode_ci 与 utf8mb4_general_ci)也必须完全一致,否则关联时同样会发生隐式转换而导致索引失效。
四、常见问题排查对照
| 异常写法 | 索引失效机制 | 标准改写建议 |
|---|---|---|
WHERE user_no = 10086(字段为 VARCHAR) |
发生隐式类型转换,底层自动调用转换函数,无法使用 B+ 树快速比对。 | WHERE user_no = '10086'确保常量与字段类型完全一致。 |
WHERE SUBSTR(title, 1, 3) = 'SQL' |
索引列被内置函数包裹,无法直接读取索引原始值。 | WHERE title LIKE 'SQL%'改写为右通配范围扫描,保留索引使用。 |
WHERE name LIKE '%技术%' |
首字符为未知通配符,导致无法进行二分折半匹配。 | 若仅能全模糊匹配,考虑引入 ES、全文索引(Fulltext),或使用覆盖索引减轻全表扫代价。 |
WHERE status != 0 |
不等于(!=、<>)往往覆盖表中绝大多数数据,回表成本高于全表扫描。 |
明确枚举有效业务值改写为 status IN (1, 2),或借助覆盖索引避免回表。 |
复合索引 (a, b)查询 WHERE a > 1 AND b = 2 |
在范围查询(>、<)之后的列,其相对顺序已不再全局有序。 |
将等值列前置,创建复合索引 (b, a),使等值字段先准确定位。 |
在日常开发与重构中,始终牢记“保持列裸露、兼顾最左前缀、善用覆盖索引”这三大基石。在上线任何涉及多表关联或关键过滤的 SQL 之前,先在测试环境使用真实体量的数据配合 EXPLAIN 验证其执行计划,是避免慢查询事故最有效的方法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















