


MySQL创建分区的方法实例:原理与操作详解

面对海量数据存储,MySQL表分区是提升查询效率和管理历史数据的有效手段。本文详细解析RANGE、HASH、KEY及LIST四种核心分区类型的创建方法与优缺点,提供完整的建表、批量插入及状态查看代码,并指出确保查询命中分区的关键优化策略。
MySQL常用分区类型概述
在进行表分区之前,了解不同分区类型的机制至关重要:
- RANGE 分区:根据列值落在一个给定的连续区间内,将行分配给不同的分区。适用于时间范围或数值范围明显的数据。
- HASH 分区:基于用户定义的表达式返回值进行分区选择。该表达式必须产生非负整数值,常用于通过算法均匀分布数据。
- KEY 分区:类似于HASH分区,但由MySQL服务器内部提供哈希函数。支持一列或多列,且必须包含整数值。
- LIST 分区:类似于RANGE,但是基于枚举列表中的离散值进行匹配。适用于有固定分类状态的数据。
第一类实操:RANGE 分区应用
RANGE分区常用于按时间段或ID段划分数据。其主要特点是通过整形类型的主键或索引列进行分区,能实现数据在逻辑上的连续存储。
第1步:创建 RANGE 分区表
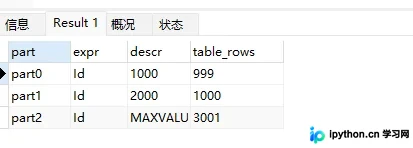
本例创建一个产品表,按照 Id 列的值范围分为三个区:part0 接收小于1000的数据,part1 接收1000到2000的数据,part2 接收大于等于2000的数据。
DROP TABLE IF EXISTS `product_partiton_range`;
CREATE TABLE `product_partiton_range`  (
  `Id` int(11) NOT NULL AUTO_INCREMENT,
  `ProductName` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `ProductId` int(11) NOT NULL,
  PRIMARY KEY (`Id`) USING BTREE
) ENGINE = InnoDB AUTO_INCREMENT = 1 CHARACTER SET = utf8mb4
PARTITION BY RANGE (Id) PARTITIONS 3 (
PARTITION part0 VALUES LESS THAN (1000),
PARTITION part1 VALUES LESS THAN (2000),
PARTITION part2 VALUES LESS THAN MAXVALUE);
第2步:批量插入测试数据
为了方便验证,创建一个存储过程向表中批量插入5000条记录,以触发不同分区的分布效果。
DROP PROCEDURE IF EXISTS PROC_USER_INSERT;
delimiter $$
-- 创建存储过程
CREATE  PROCEDURE PROC_USER_INSERT(
IN START_NUM INT,
IN MAX_NUM INT
)
BEGIN

DECLARE TEMP_NUM INT DEFAULT 0;
SET TEMP_NUM=START_NUM;

WHILE TEMP_NUM<=MAX_NUM  DO
    INSERT INTO product_partiton_range(ProductName,ProductId) VALUES('XIAOHEMIAO',TEMP_NUM);
    SET TEMP_NUM=TEMP_NUM+1;
END WHILE;


END$$ ;
delimiter;

-- 调用存储过程
CALL PROC_USER_INSERT(1,5000);
第3步:检查执行计划与分区情况
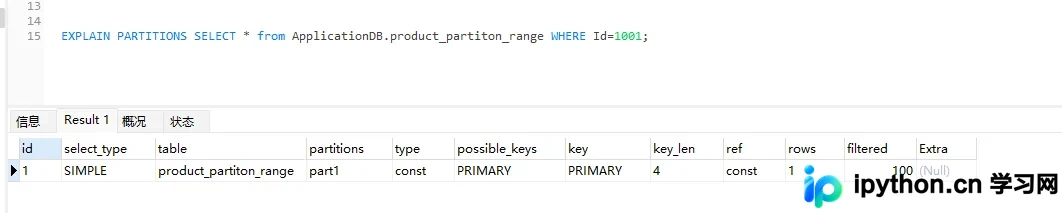
使用 EXPLAIN PARTITIONS 命令可以观察到,如果查询语句中使用了分区键(此处为 Id),优化器只会扫描对应的分区,而不需要全表扫描,从而显著提升性能。
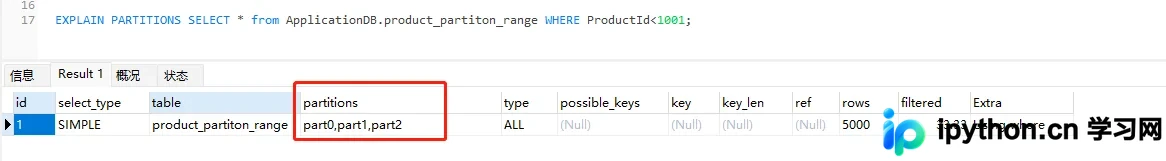
注意风险:若 SQL 查询未使用分区键,则会导致所有分区被扫描(全量扫描),这在数据量大时极度危险,务必在查询中包含分区字段。
可通过查询信息_schema查看当前表的分区详情:
SELECT
partition_name part,
partition_expression expr,
partition_description descr,
table_rows
FROM information_schema.partitions WHERE
table_schema = SCHEMA()
AND table_name='product_partiton_range';
第二类实操:HASH 与 KEY 分区
1. HASH 分区配置
HASH 分区的优点是能够将数据相对平均地分布到各个分区中,避免数据倾斜。但它只能对数字字段进行分区,若需对字符字段分区,通常需要配合其他转换函数或将其纳入主键计算。
DROP TABLE IF EXISTS `product_partiton_hash`;
CREATE TABLE `product_partiton_hash`  (
  `Id` int(11) NOT NULL AUTO_INCREMENT,
  `ProductName` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `ProductId` int(11) NOT NULL,
  PRIMARY KEY (`Id`) USING BTREE
) ENGINE = InnoDB AUTO_INCREMENT = 1 CHARACTER SET = utf8mb4
PARTITION BY HASH (Id) PARTITIONS 3 ;
2. KEY 分区配置
KEY 分区相比 HASH 更灵活,除了 TEXT 和 BLOB 类型外,几乎支持所有类型的字段进行分区(但在内部仍转换为整数)。以下示例尝试对字符串 ProductName 进行 KEY 分区。
DROP TABLE IF EXISTS `product_partiton_key`;
CREATE TABLE `product_partiton_key`  (
  `Id` int(11) NOT NULL AUTO_INCREMENT,
  `ProductName` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `ProductId` int(11) NOT NULL,
  PRIMARY KEY (`Id`,`ProductName`) ,
  INDEX `ProductId_index`(`ProductId`)
) ENGINE = InnoDB AUTO_INCREMENT = 1 CHARACTER SET = utf8mb4
PARTITION BY KEY (ProductName) PARTITIONS 3 ;
第三类实操:LIST 分区应用
当数据具有明确的枚举属性(如商品状态、地区代码等)时,LIST 分区是最直观的选择。它支持基于特定的离散值进行归类。
第1步:建立 LIST 分区表
这里建立一个包含商品状态的表,状态值为0、1的数据进入 p0 分区,状态值为2、3、4的进入 p1 分区。
DROP TABLE IF EXISTS `product_partiton_list`;
CREATE TABLE `product_partiton_list`  (
  `Id` int(11) NOT NULL AUTO_INCREMENT,
  `ProductName` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL,
  `ProductId` int(11) NOT NULL,
    `ProductStatus` int(11) NOT NULL,
  PRIMARY KEY (`Id`,`ProductStatus`) ,
  INDEX `ProductId_index` (`ProductId`)
) ENGINE = InnoDB AUTO_INCREMENT = 1 CHARACTER SET = utf8mb4
PARTITION BY LIST(ProductStatus)(
    PARTITION p0 VALUES in(0,1),
    PARTITION p1 VALUES in(2,3,4)
);
第2步:录入并验证数据
分别插入不同状态的数据后,可以通过查询系统表确认各分区内的行数变化:
INSERT INTO product_partiton_list(ProductName,ProductId,ProductStatus) VALUES('XIAOHEMIAO',1,0);
INSERT INTO product_partiton_list(ProductName,ProductId,ProductStatus) VALUES('XIAOHEMIAO',1,1);
INSERT INTO product_partiton_list(ProductName,ProductId,ProductStatus) VALUES('XIAOHEMIAO',1,2);
INSERT INTO product_partiton_list(ProductName,ProductId,ProductStatus) VALUES('XIAOHEMIAO',1,3);
INSERT INTO product_partiton_list(ProductName,ProductId,ProductStatus) VALUES('XIAOHEMIAO',1,4);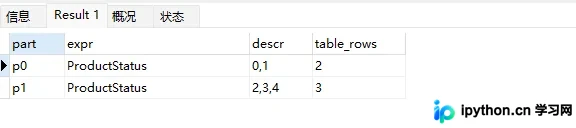
通用查询与维护技巧
无论采用何种分区方式,若要快速查看某张分区表在各个分区中的数据存储量,可以使用如下 SQL 语句:
SELECT PARTITION_NAME,TABLE_ROWS
FROM INFORMATION_SCHEMA.PARTITIONS
WHERE TABLE_NAME = '你的表名';
核心注意事项总结
- 主键约束:MySQL规定,作为分区依据的列,如果是单键分区则必须是主键;如果是复合主键,则分区键必须包含在主键之内。
- 查询失效风险:在进行 SELECT 查询时,WHERE 条件中必须包含分区键。否则,MySQL 无法定位数据所在的分区,会导致扫描全部子分区,不仅使分区失去意义,还可能引发严重的性能瓶颈。
以上就是MySQL表分区创建的详细内容,更多关于MySQL分区管理与优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















